Hace un año escribí una guía
sobre el uso de la inteligencia artificial desde la terminal. Lo
esencial sigue siendo válido, pero una parte importante ha quedado
desfasada: casi todas estas herramientas han pasado a requerir una
suscripción de pago. Quien siga hoy aquellas instrucciones se encontrará
con límites y precios que entonces no existían.
Este artículo pone al día el panorama. Es una introducción breve para
quien empieza: qué son estas consolas, qué cuesta cada una en septiembre
de 2026, cómo se instalan y cómo se dan los primeros pasos.
Pódcast del artículo realizado por Gemini Notebook
Pódcast del artículo realizado por Gemini Notebook
Qué son
Estamos acostumbrados a usar la IA en una página web. Una
consola de IA es el mismo modelo, pero instalado en
nuestro ordenador y manejado desde una ventana de texto: la terminal del
sistema. Se habla con ella igual que en el chat, escribiendo lo que
queremos.
La diferencia no está en la conversación, sino en lo que puede hacer.
La IA en la web no ve nuestro ordenador: hay que subirle los archivos de
uno en uno y bajar después los resultados. La consola trabaja
directamente en la carpeta desde la que la hemos abierto, así que puede
leer, escribir, convertir y ordenar decenas de archivos sin que
intervengamos. Renombrar con un criterio común las fotos de una salida,
convertir a PDF los documentos de una unidad, sacar la transcripción de
unos audios o construir un recurso interactivo de varios archivos son
tareas que en la web resultan tediosas y en la consola se piden en una
frase.
No hace falta un ordenador potente. El programa solo pone en contacto
nuestro equipo con el servicio en Internet, de modo que un portátil
modesto es suficiente.
Lo que ha
cambiado: ahora casi todo es de pago
El cambio de este año afecta a lo esencial, que es el acceso. Lo que
en 2025 era gratuito y generoso hoy está limitado o cerrado.
Gemini CLI ya no existe para el usuario particular.
Google la limitó primero a los modelos Flash y, el 18 de junio
de 2026, dejó de atender peticiones de las cuentas personales,
tanto gratuitas como de pago. Su sustituta es Antigravity
CLI, que se instala aparte y se abre con la orden
agy. Gemini CLI sobrevive solo para las licencias
corporativas de Gemini Code Assist y para quien pague por clave de
API.
Qwen Code era la alternativa gratuita. Su acceso
libre con cuenta de Qwen se retiró el 15 de abril de
2026 y ahora necesita un plan de Alibaba Cloud o una clave de
API de pago.
Codex, en cambio, ha ido en sentido contrario:
OpenAI lo ha incluido en todos los planes de ChatGPT,
incluido el gratuito, aunque en este último solo para un uso
mínimo.
Claude Code nunca fue gratuito y sigue sin
serlo.
Copilot CLI, de GitHub, tampoco funciona con el
plan gratuito de Copilot.
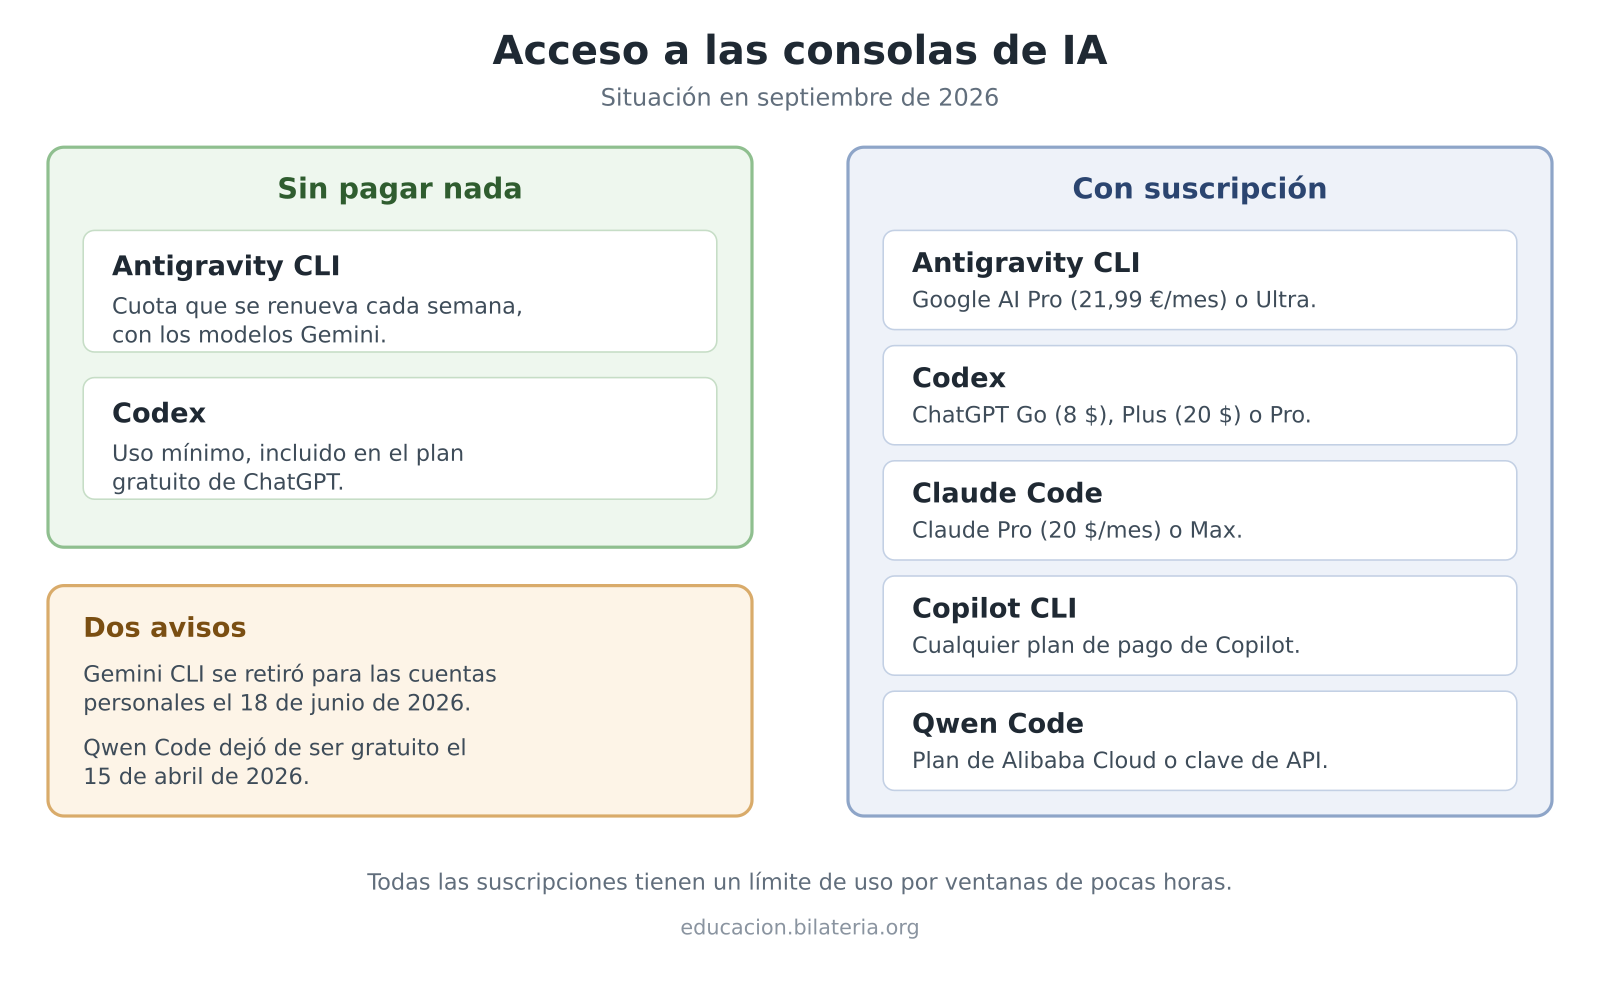
Resumen del acceso a cada consola según el plan contratado, en
septiembre de 2026.
Qué hay hoy y qué cuesta
Consola
Empresa
Sin pagar nada
Con suscripción
Antigravity CLI
Google
Sí, con una cuota que se renueva cada semana
Google AI Pro (21,99 €/mes) o Ultra, con cuota mayor cada cinco
horas
Codex
OpenAI
Sí, uso mínimo con el plan gratuito de ChatGPT
ChatGPT Go (8 $), Plus (20 $) o Pro (desde 100 $)
Claude Code
Anthropic
No
Claude Pro (20 $/mes) o Max (desde 100 $)
Copilot CLI
GitHub
No
Cualquier plan de pago de Copilot
Qwen Code
Alibaba
No desde abril de 2026
Plan de Alibaba Cloud o clave de API
Dos advertencias sobre los precios, que son los del 10 de septiembre
de 2026 y conviene comprobar antes de pagar:
El plan Google AI Plus (4,99 €/mes) no amplía nada
aquí. Es el más barato de Google y resulta tentador, pero para
la consola cuenta igual que no tener plan: la cuota mayor es solo de AI
Pro y AI Ultra.
Las suscripciones incluyen un límite de uso por ventanas de
pocas horas. En un trabajo intenso se agota antes de lo que
parece, y entonces no queda más que esperar o pagar más.
Existen también consolas de código abierto, como OpenCode, que
funcionan con el modelo que se les indique, incluidos los de proveedores
más económicos o los que se ejecutan en el propio ordenador. Son
flexibles, pero exigen configurarlas y entender qué se está contratando,
así que no son el punto de partida recomendable.
Instalación
Primero se abre la terminal del sistema
operativo:
Windows: pulsar la tecla de Windows, escribir
PowerShell y abrir el programa.
Mac: abrir Launchpad, escribir
Terminal y hacer clic en la aplicación.
Linux: buscar Terminal en el menú de
aplicaciones, o pulsar CTRL + ALT + T.
Y allí se escribe una de las siguientes órdenes, según la consola que
se quiera instalar. Basta elegir una herramienta: no hay ninguna ventaja
en instalar las tres.
Ninguna de las tres necesita ya Node.js: las tres traen su propio
instalador. Si alguien tiene todavía instalada la antigua Gemini CLI,
puede desinstalarla: con una cuenta personal ya no responde.
Codex, la de OpenAI. En Mac y Linux:
curl -fsSL https://chatgpt.com/codex/install.sh | sh
Si algo falla, lo más práctico es copiar el mensaje de error y
pegárselo a la IA de la web: son errores conocidos y los resuelve en un
par de intentos.
Los primeros pasos
Abrir la consola en
la carpeta de trabajo
Esto es lo más importante y lo que más se olvida. La IA trabaja sobre
la carpeta desde la que se ha arrancado, de modo que nunca
conviene abrirla en la carpeta personal ni en la raíz del
disco, donde tiene a la vista todo lo que guardamos. Se crea
una carpeta para el trabajo en cuestión y se abre allí:
En Windows, abrir la carpeta en el explorador de
archivos, pulsar CTRL + L y escribir powershell.
En Mac, desde Finder, con el botón derecho sobre la
carpeta y «Nueva terminal en la carpeta».
En Linux, con el botón derecho en un espacio vacío
de la carpeta y «Abrir en un terminal».
Una vez dentro, se escribe agy, codex o
claude, según lo que hayamos instalado, y se pulsa Enter.
La primera vez se abrirá el navegador para iniciar sesión con nuestra
cuenta; después ya no lo volverá a pedir.
Hablar con ella
A partir de aquí se escribe lo que queremos, en lenguaje corriente y
con el mismo detalle que en la web. Conviene empezar por algo inofensivo
y comprobable, como pedirle que describa lo que hay en la carpeta.
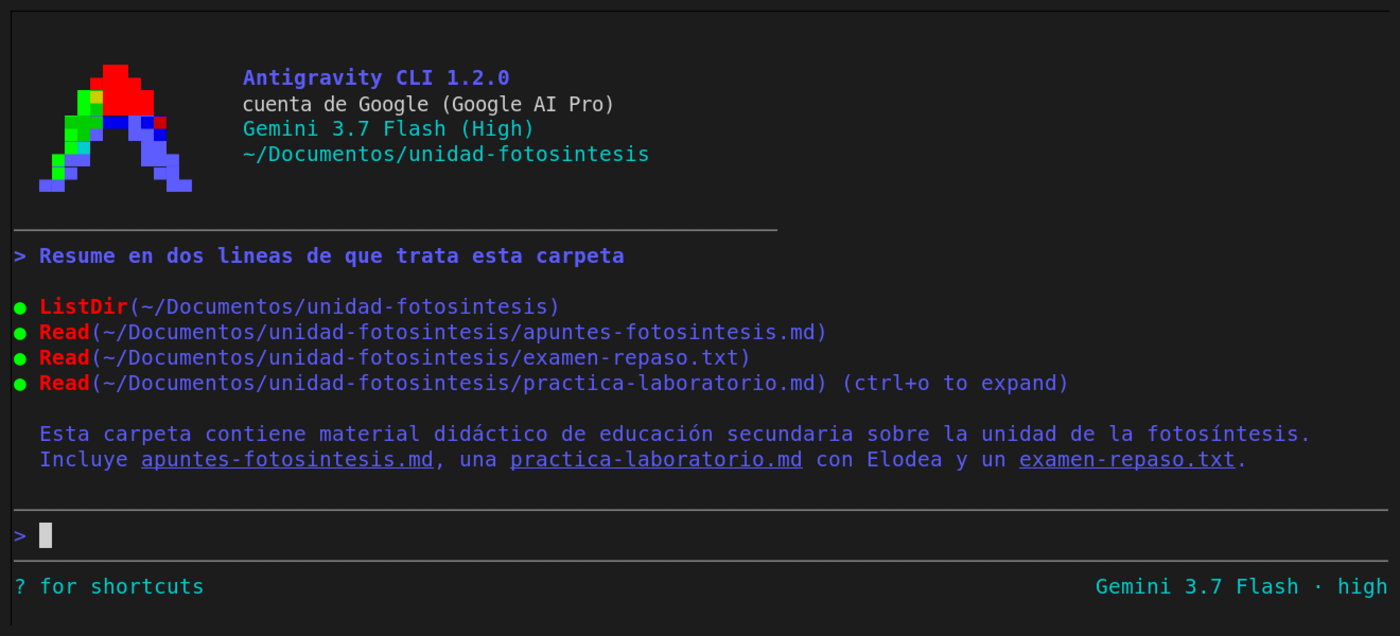
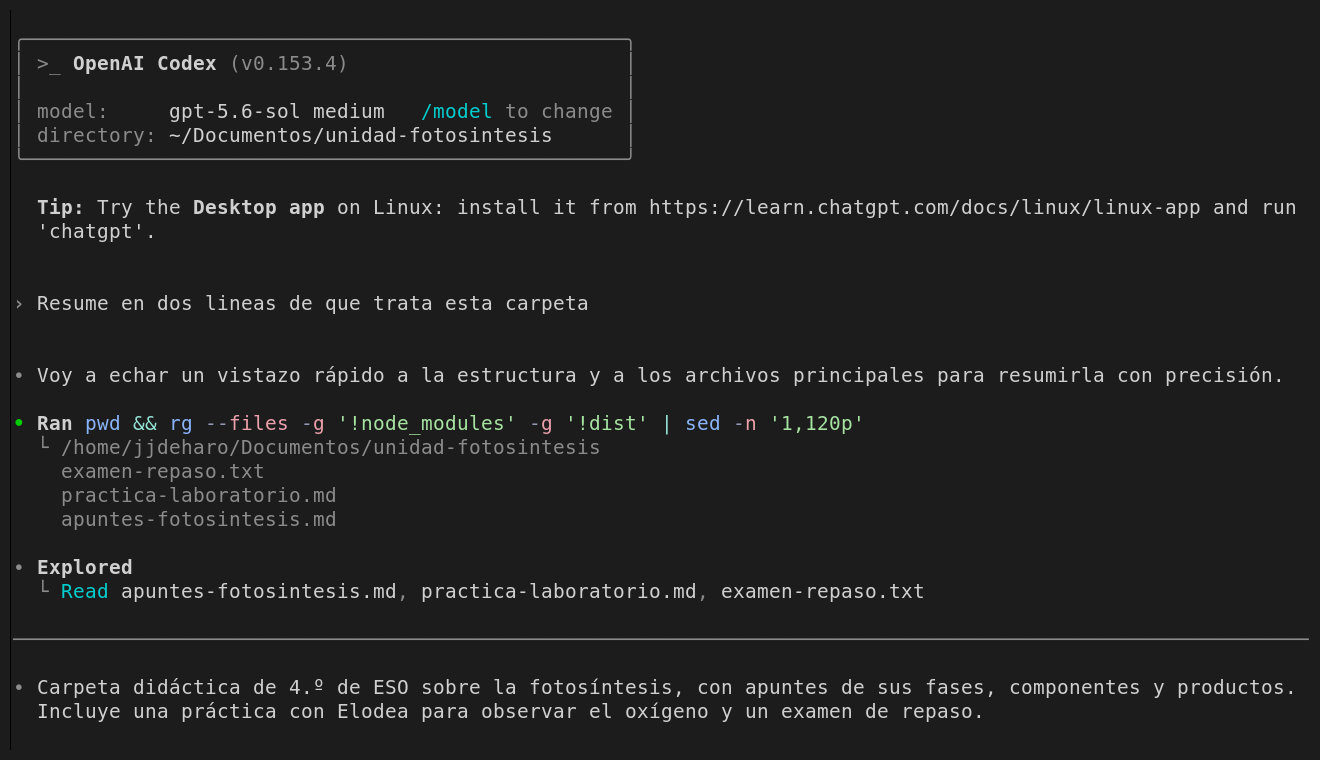
Antigravity CLI, la consola de Google, resumiendo una carpeta de
trabajo. Arriba indica la cuenta, el modelo y la carpeta.Codex, la consola de OpenAI, resumiendo el contenido de una
carpeta. En el recuadro superior indica el modelo que utiliza y la
carpeta en la que trabaja.
Cuando la tarea implique tocar nuestros archivos o ejecutar un
programa, pedirá permiso. Se le puede dar una sola vez
o para el resto de la sesión. Es la protección principal que tenemos:
merece la pena leer qué pide antes de aceptar.
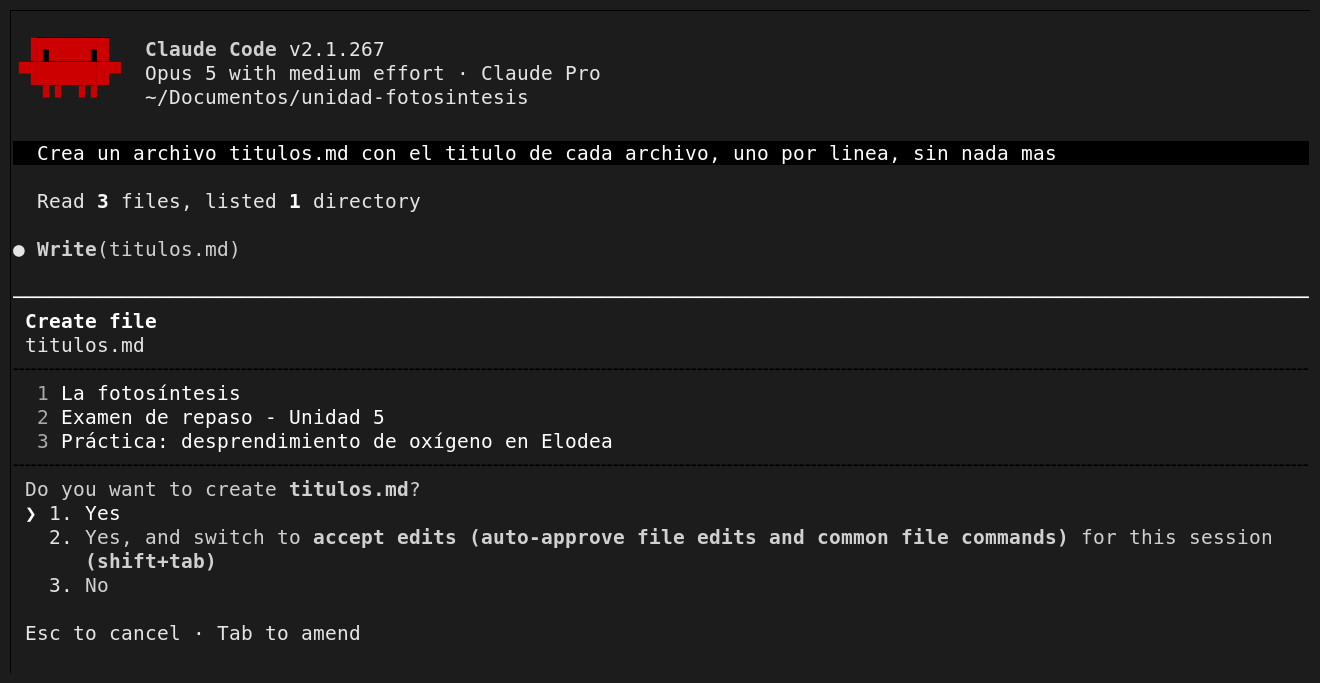
Claude Code, antes de crear un archivo, enseña lo que va a
escribir y espera la respuesta.
Cuatro comandos que sirven
en todas
/ muestra la lista completa de comandos disponibles,
con una descripción de cada uno. Son muchos, y esta es la forma de
descubrirlos sin buscar en la documentación.
/model indica qué modelo se está usando y permite
cambiarlo, en las tres. Conviene usarlo en lugar de fiarse de lo que se
leyó en un artículo: los modelos cambian cada pocos meses. Codex y
Claude Code tienen además /status, que muestra el plan y el
consumo, y Antigravity CLI, /usage, que muestra cuánta
cuota queda.
/init hace que examine la carpeta y escriba un resumen
de lo que contiene, que usará como memoria a partir de entonces. Está en
Codex y en Claude Code, y conviene ejecutarlo al empezar en una carpeta
que ya tenga archivos; Antigravity CLI no lo tiene.
/exit cierra la consola, y en Codex y Claude Code vale
también /quit. En las tres se consigue lo mismo pulsando
dos veces CTRL + C.
Darle memoria
Cada consola lee, al arrancar, un archivo de texto en formato
Markdown con instrucciones permanentes que hay que dejar en la carpeta
de trabajo: AGENTS.md para Antigravity CLI y para Codex, y
CLAUDE.md para Claude Code. Codex y Claude Code buscan
además uno general en su carpeta de configuración (~/.codex
y ~/.claude, y en Windows %USERPROFILE%\.codex
y %USERPROFILE%\.claude), que se aplica a todo lo que
hagamos con ellas.
Es el equivalente a la personalización de los chats web, y vale la
pena dedicarle diez minutos: nuestro nombre, las asignaturas que
impartimos, el nivel del alumnado o la licencia que queremos en todo lo
que produzca. Se escribe una vez y lo tiene en cuenta siempre.
Tres atajos que ahorran
tiempo
Cuando la consola deja de dar respeto, estos tres recursos son los
que más se usan a diario.
Arrancar con el trabajo ya encargado. No hace falta
abrir la consola y escribir después: la instrucción puede ir en la misma
orden de arranque, y la consola aparece ya trabajando. En Antigravity
CLI se pasa con -i, y en Codex y Claude Code basta con
escribirla detrás, entre comillas:
agy -i "Lee los archivos .txt de esta carpeta y dime qué contienen"
claude "Lee los archivos .txt de esta carpeta y dime qué contienen"
Pedir algo sin llegar a entrar. Para un encargo
suelto, la opción -p devuelve la respuesta en la terminal
del sistema y termina, sin abrir ninguna sesión. Es lo cómodo para una
consulta rápida o para dejar preparada una tarea:
agy -p "Renombra las fotos de esta carpeta como salida-01, salida-02, y así"
claude -p "Renombra las fotos de esta carpeta como salida-01, salida-02, y así"
Codex funciona de otra manera: usa codex exec "…", y si
la carpeta no está controlada con Git, avisa de que hay que añadir
--skip-git-repo-check.
Cuatro teclas. En la terminal el ratón no sirve de
mucho, y estas suplen casi todo: CTRL + A y CTRL + E llevan el cursor al
principio y al final de la línea; CTRL + L limpia la pantalla; CTRL + R,
en la terminal del sistema, busca entre las órdenes ya escritas mientras
tecleamos, que evita volver a escribir las largas; y CTRL + C interrumpe
lo que la IA esté haciendo, sin cerrar la sesión. En Linux, además,
copiar y pegar son CTRL + MAYÚS + C y CTRL + MAYÚS + V, porque CTRL + C
está ocupado en interrumpir.
Antes de empezar, dos
precauciones
La privacidad depende del plan. En las cuentas
personales gratuitas de Google, las conversaciones pueden usarse para
entrenar los modelos salvo que se desactive expresamente. Los planes de
pago, los corporativos y los de Workspace for Education ofrecen
garantías mayores. La regla práctica es no poner en la consola datos del
alumnado ni documentación confidencial del centro, igual que en el chat
web.
Conviene mirar lo que hace. Una consola de IA puede
borrar y sobrescribir archivos, y se equivoca. Trabajar sobre una copia,
o en una carpeta controlada con Git, evita disgustos que de otro modo no
tienen vuelta atrás.
Qué elegir
Para quien no quiera pagar nada, hoy la opción con más recorrido es
Antigravity CLI, cuya cuota semanal gratuita da para
las tareas mecánicas con archivos, que es justamente donde la consola
aporta más al trabajo diario. El plan gratuito de ChatGPT también
permite probar Codex, aunque con muy poco margen.
Para quien ya pague una suscripción, lo sensato es usar la que tenga:
con ChatGPT, Codex; con Claude, Claude
Code; con Google AI Pro, Antigravity CLI. La
diferencia entre ellas es hoy menor que la diferencia entre usar una
consola y no usar ninguna.
Y si la ventana de texto se hace cuesta arriba, conviene saber que
Claude, ChatGPT y el propio Antigravity tienen ya aplicación de
escritorio o editor propio, con las mismas capacidades y sin terminal a
la vista. La terminal es el camino más directo, no el único.
La preparación de materiales suele exigir un mismo contenido en
formatos distintos: el documento de Word que pide el departamento, el
PDF que se entrega al alumnado y, en ocasiones, la página web del aula
virtual. Cuando el texto incluye fórmulas, la conversión de un formato a
otro deja de ser inmediata y obliga a repasar y rehacer el resultado en
cada paso.
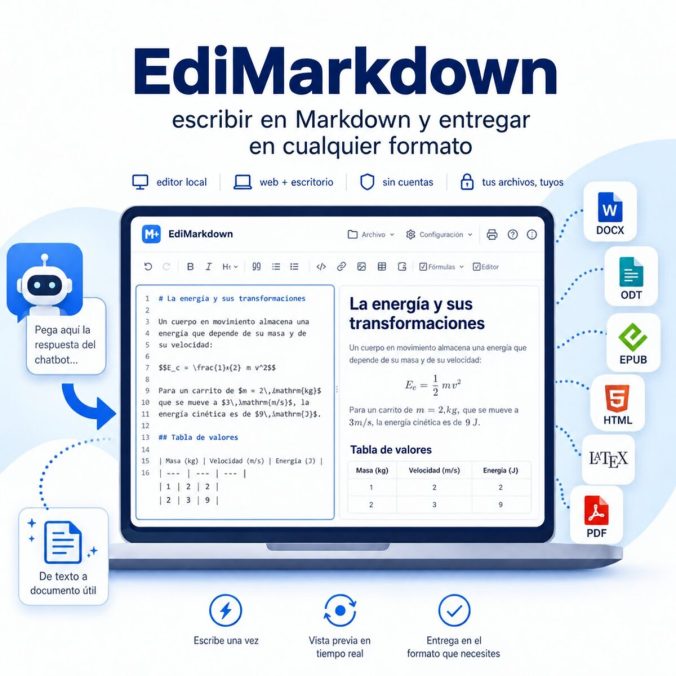
EdiMarkdown es un editor
de Markdown pensado para ese trabajo: se escribe una sola vez, o se pega
directamente lo que ha respondido un chatbot, se ve el resultado
mientras se escribe y se exporta a DOCX, ODT, EPUB, HTML, LaTeX o PDF
según convenga. También recorre el camino inverso: abre documentos de
esos mismos formatos, PDF incluido, y los convierte en texto editable.
Funciona en el navegador, sin instalar nada, y también como aplicación
de escritorio para Linux, Windows y macOS. En los dos casos el documento
no sale del equipo: no hay cuentas, ni servidores, ni subida de archivos
a ningún sitio.
El programa se llamó EdiMarkWeb hasta la versión 3. Aquel nombre
describía lo que era al empezar: una herramienta que solo funcionaba en
el navegador. Desde entonces se instala también como aplicación de
escritorio, abre y exporta una docena de formatos y resuelve las citas y
la bibliografía, de modo que el nombre se había quedado corto. La
versión 3 lo llama EdiMarkdown, que es lo que hace. La
dirección y el repositorio siguen siendo los mismos, así que los enlaces
guardados continúan funcionando.
Actualizado el 13 de septiembre de 2026: el programa pasa a
llamarse EdiMarkdown en la versión 3, y la importación de PDF reconoce
las notas al pie.
Pódcast del artículo realizado por Gemini Notebook
Markdown y los dos editores
Markdown es texto corriente con unas pocas marcas: almohadillas para
los encabezados, asteriscos para la negrita, guiones para las listas. Se
aprende en unos minutos y tiene una ventaja de fondo: el archivo es
texto plano, de modo que se abre en cualquier ordenador, también dentro
de veinte años, sin depender de la versión del programa con que se
escribió.
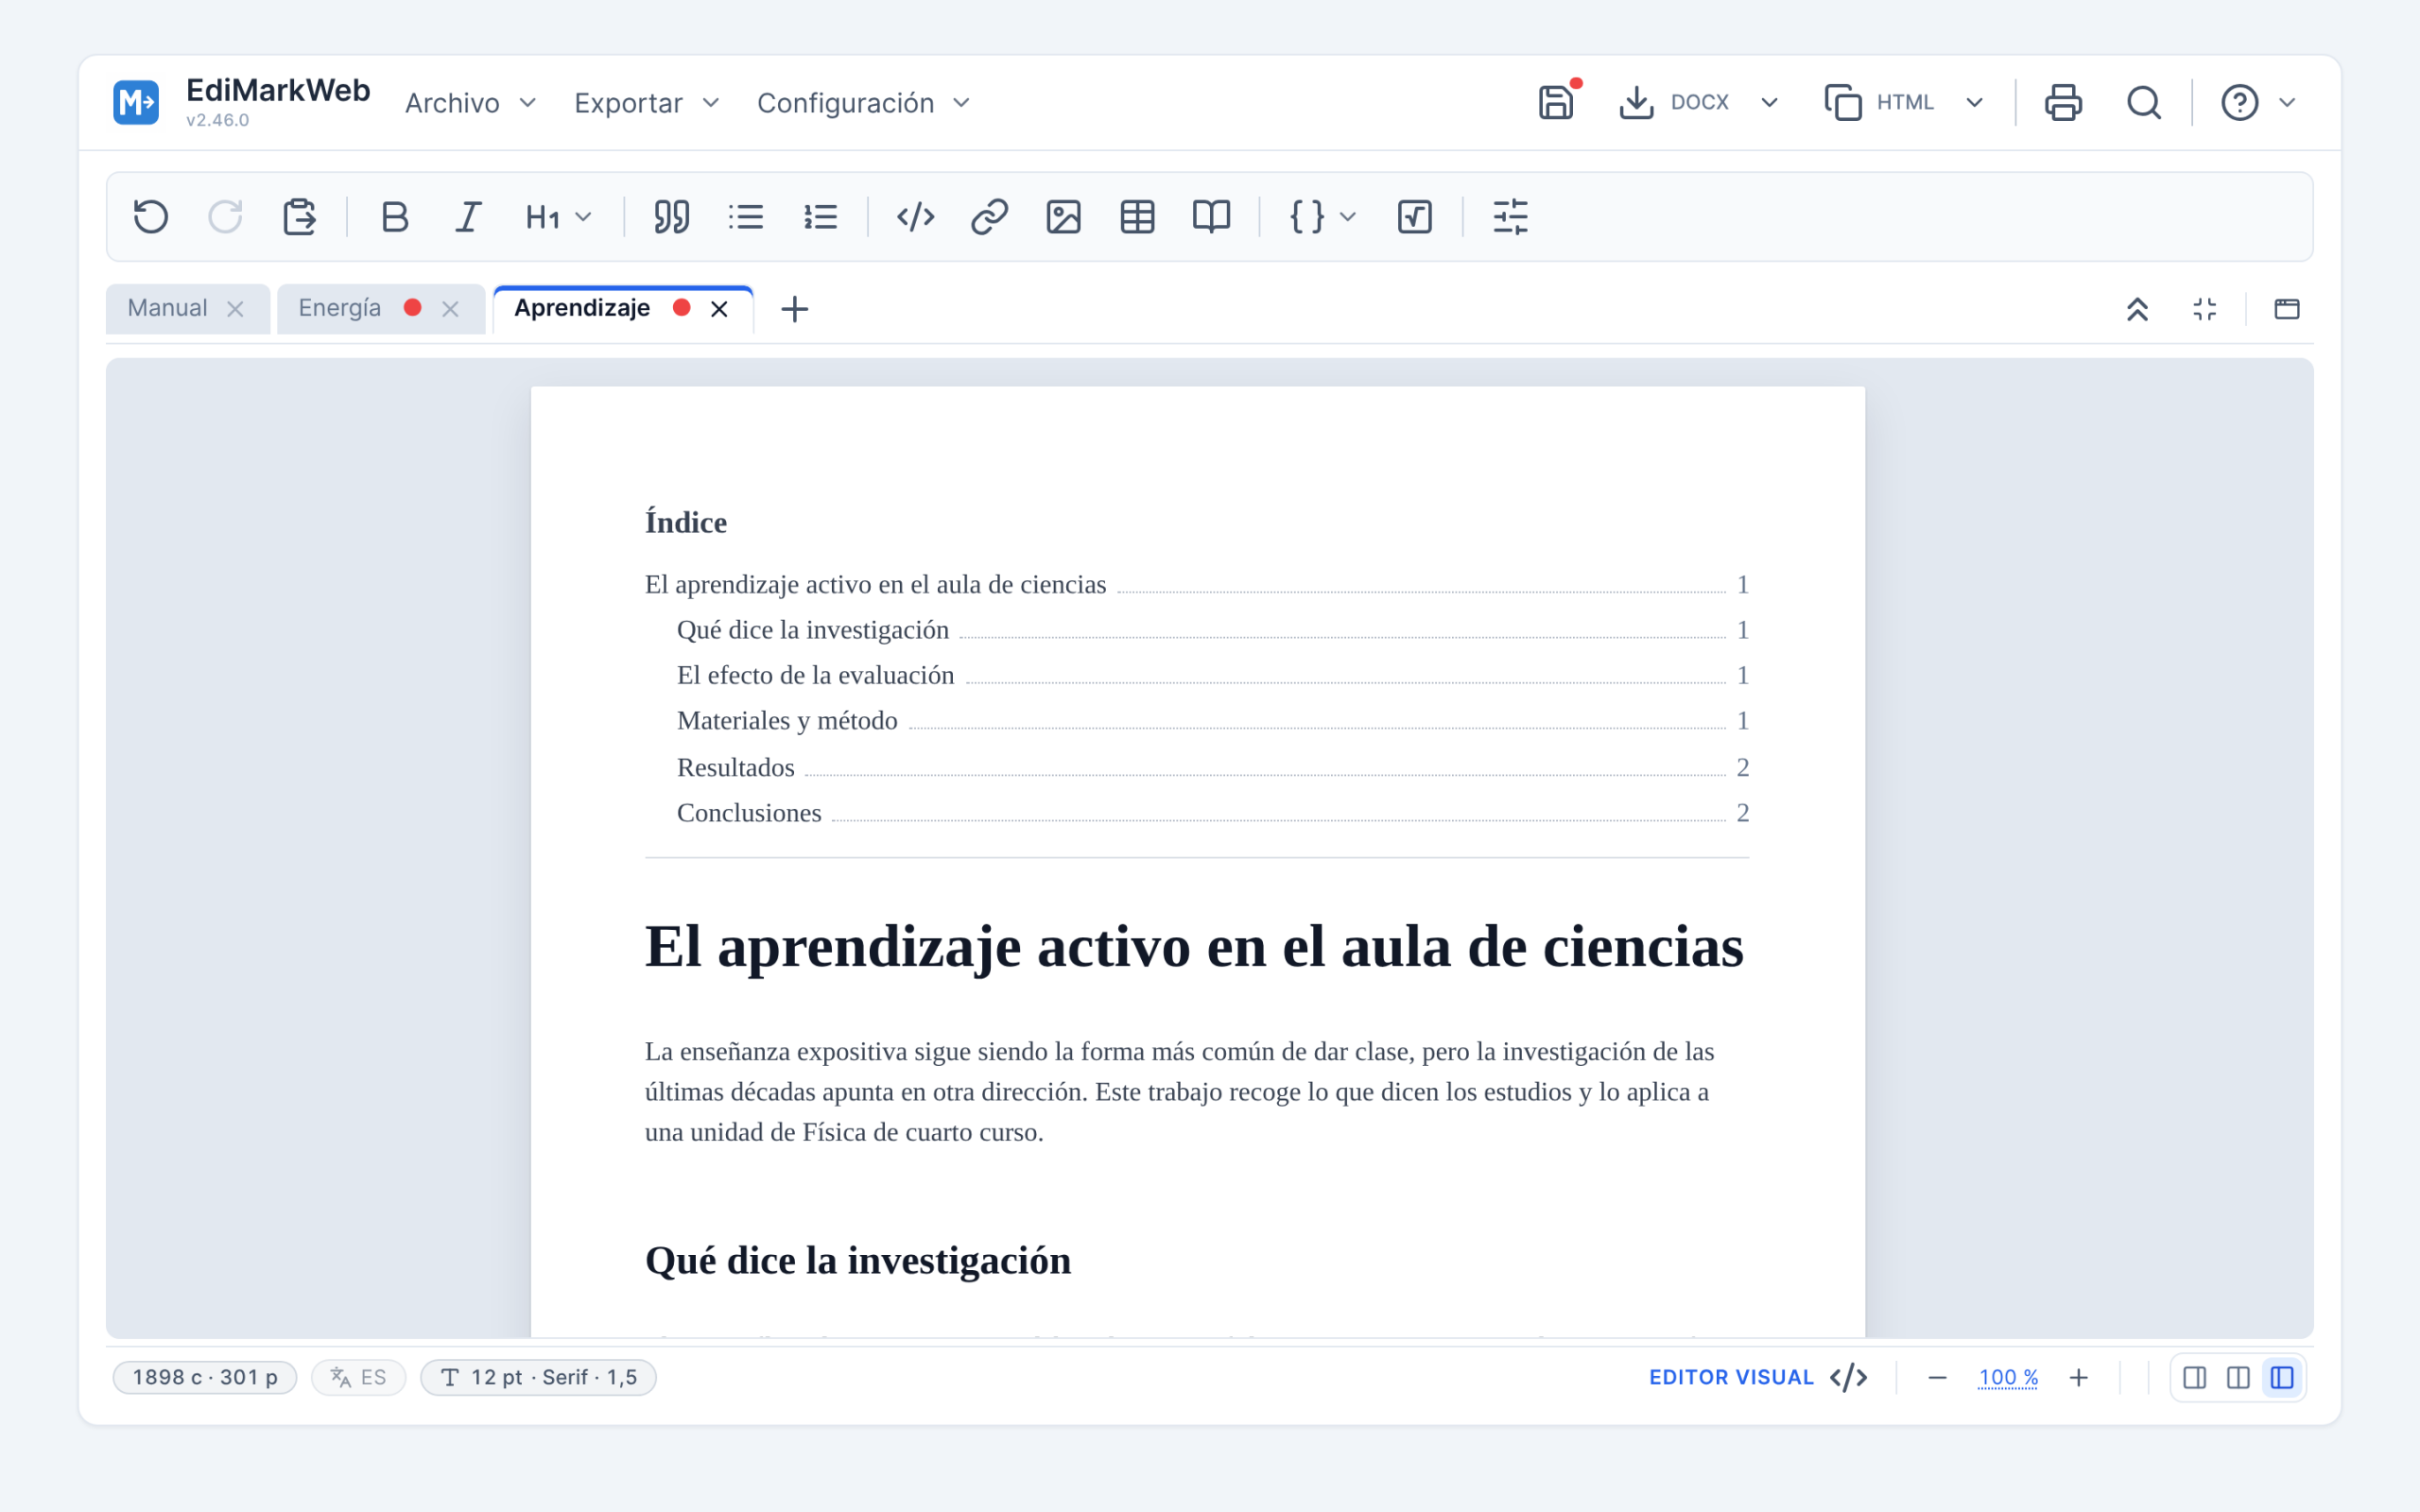
La pantalla se divide en dos paneles. A la izquierda, el editor
Markdown, con el texto y sus marcas. A la derecha, el editor visual, con
el documento ya compuesto. Los dos están sincronizados y los dos
se pueden editar, de modo que se puede corregir sobre el texto
acabado, como en un procesador, y ver cómo cambia el Markdown de la
izquierda. La barra de herramientas cubre lo habitual (encabezados,
listas, citas, enlaces, imágenes, tablas, bloques de código) y trabaja
en cualquiera de los dos.
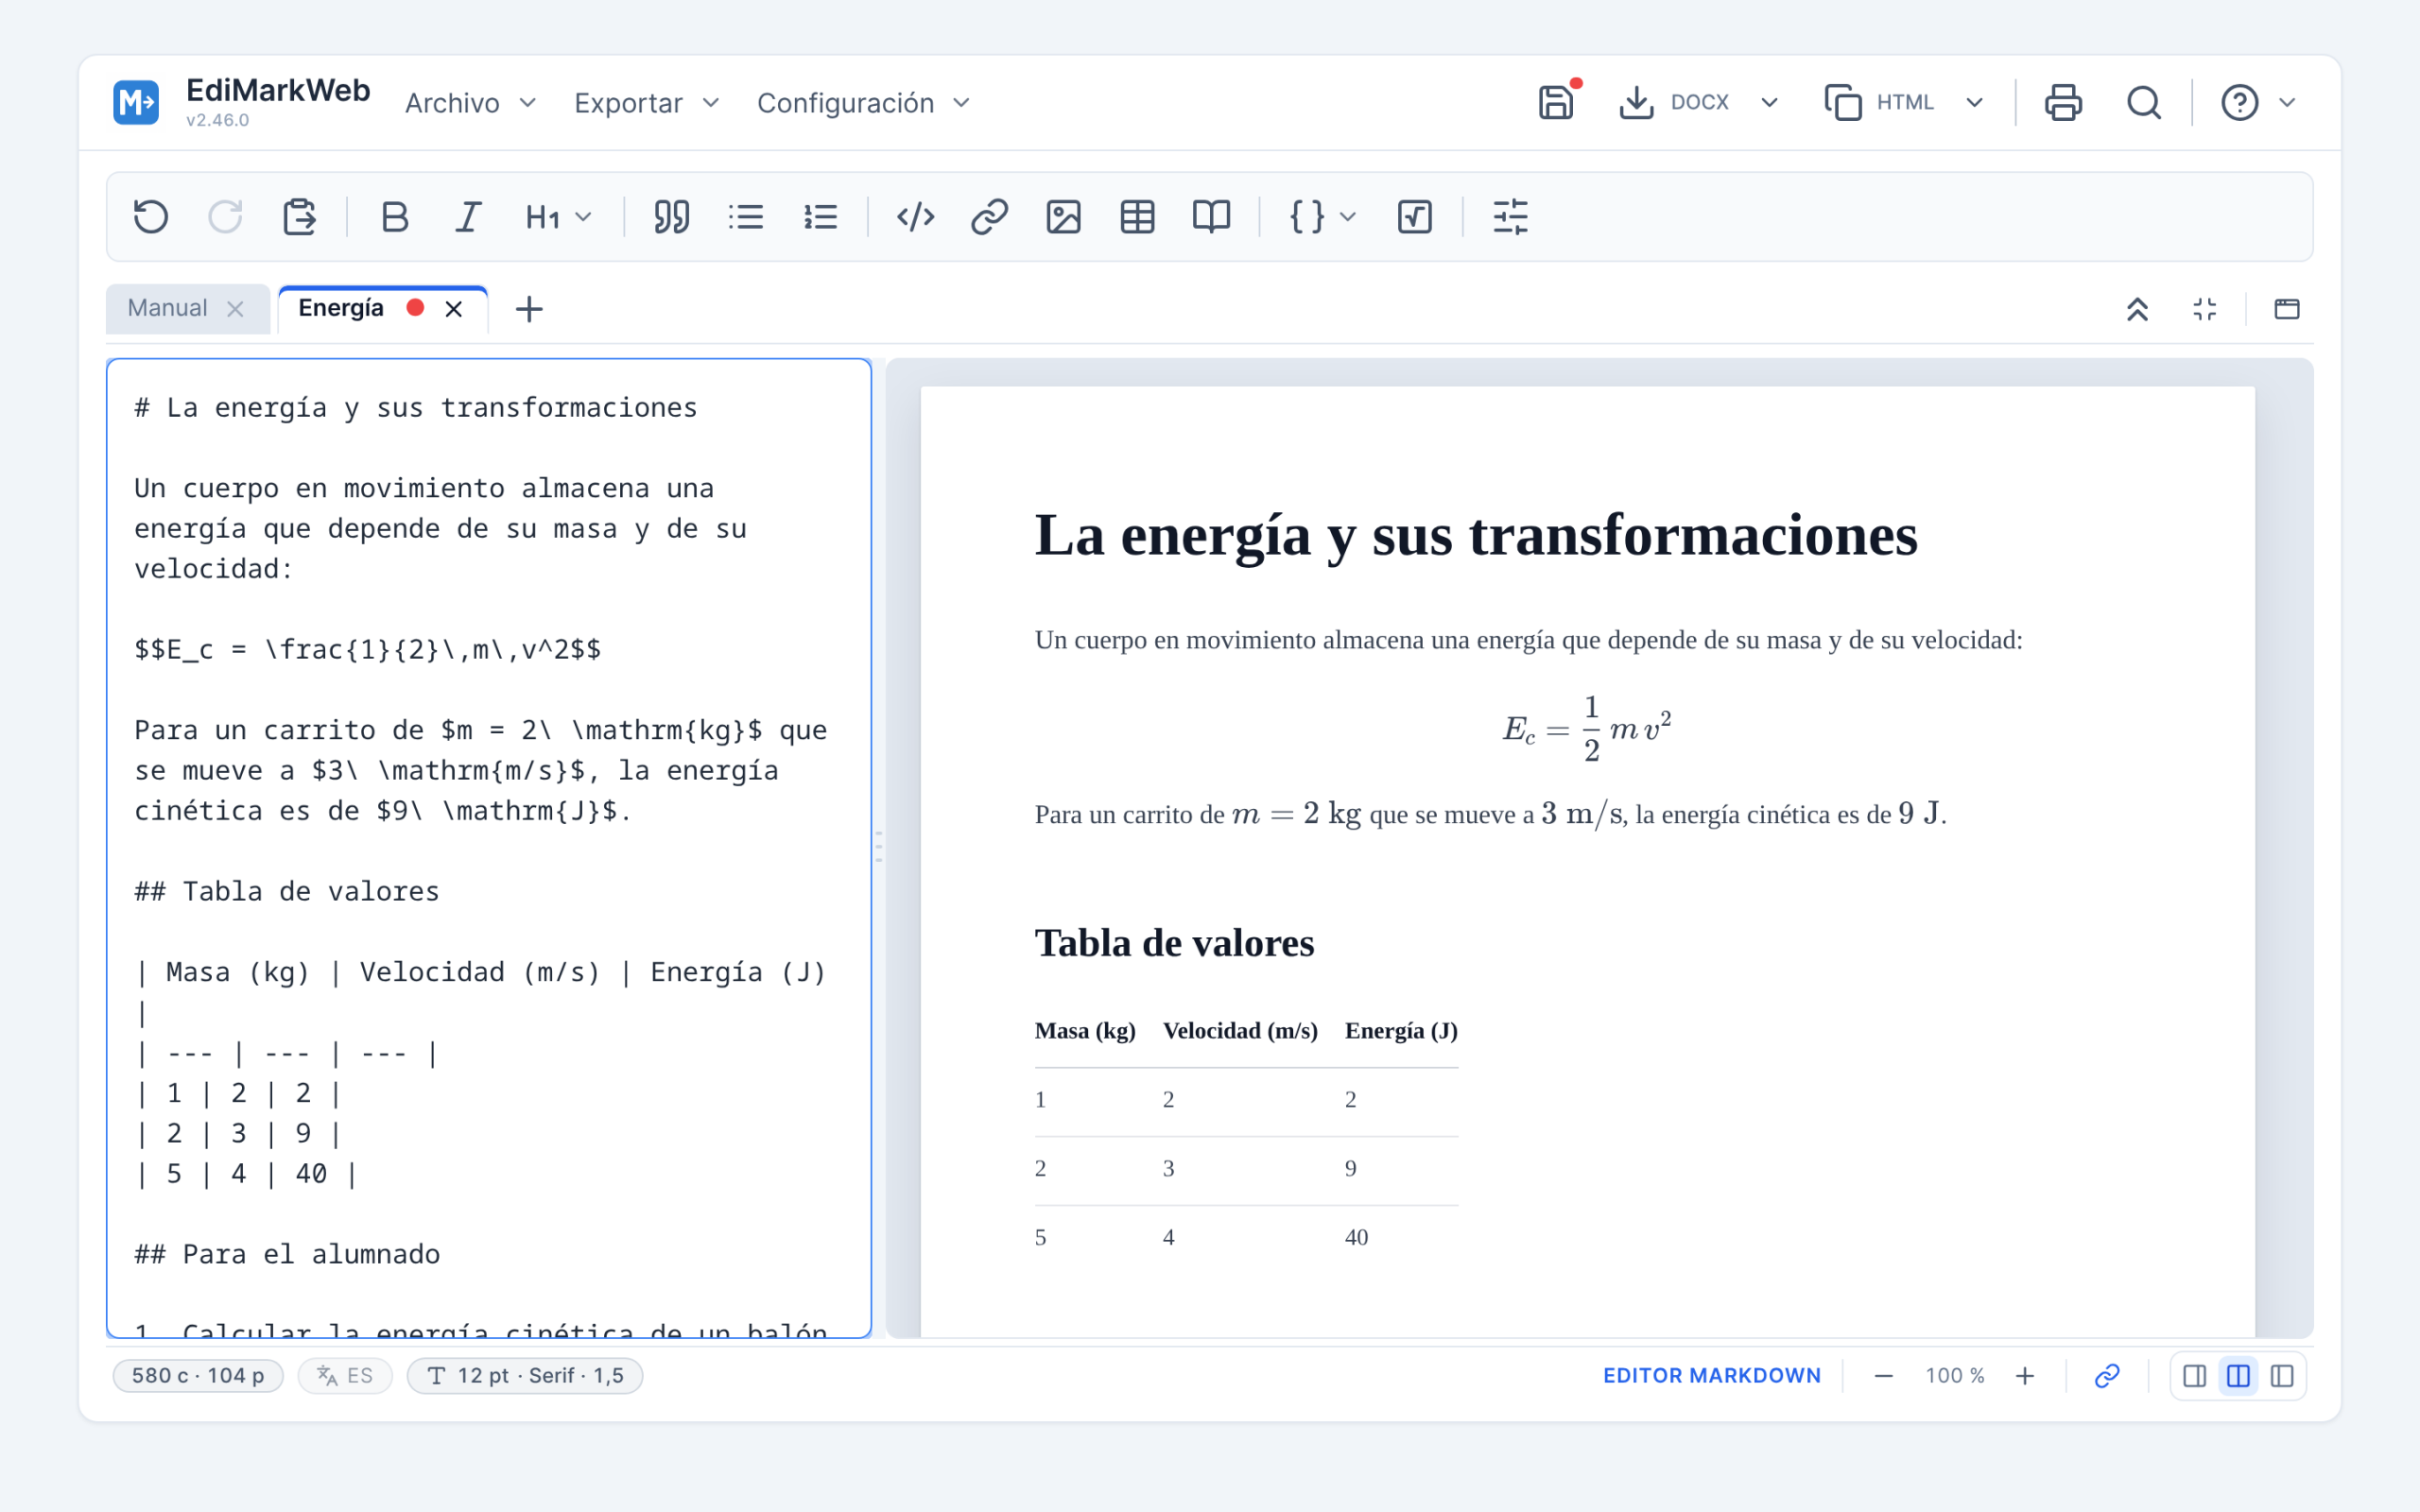
El panel izquierdo contiene el texto con sus marcas; el derecho,
el documento tal como va a imprimirse. La fórmula del centro se compone
al escribirla.
Bajo los paneles, una barra de estado reúne lo que se consulta a
diario: el número de caracteres y palabras, el idioma del documento, un
resumen de cómo va a salir (tamaño de letra, tipo e interlineado), la
lupa y los tres botones que reparten la pantalla entre un panel, los dos
o el otro.
Los documentos se organizan en pestañas, cada una con su archivo, y
se guardan solas: si se cierra el navegador por accidente, al volver
está todo. Y si queda algo sin guardar, avisa antes de cerrar la
pestaña. Con el botón derecho sobre una pestaña se cierran las demás de
una vez y se recupera la última cerrada, que es lo que se echa en falta
después de abrir una carpeta entera.
El Markdown de
la IA, directamente al documento
Esta es la función con la que nació el programa y sigue siendo la más
utilizada. Al copiar la respuesta de un chatbot y pegarla en un
procesador de textos, lo que aparece es un texto lleno de asteriscos y
almohadillas. Las fórmulas llegan además como el código que son,
\frac{-b \pm \sqrt{b^{2}-4ac}}{2a}, y no compuestas. El
contenido es correcto, pero no se puede entregar en ese estado.
La causa es que las inteligencias artificiales responden en
Markdown, con las fórmulas escritas en LaTeX. Es su formato
nativo, aunque el chat lo presente ya compuesto. Al copiar, lo que viaja
son las marcas, y el procesador de textos no sabe qué hacer con
ellas.
EdiMarkdown interpreta ese formato. Se copia la respuesta del chat,
se pega en el panel izquierdo y en el derecho aparece el documento
terminado: los encabezados como encabezados, las listas como listas, las
tablas como tablas y las fórmulas compuestas. De ahí sale ya un DOCX, un
ODT o un PDF listos para entregar.
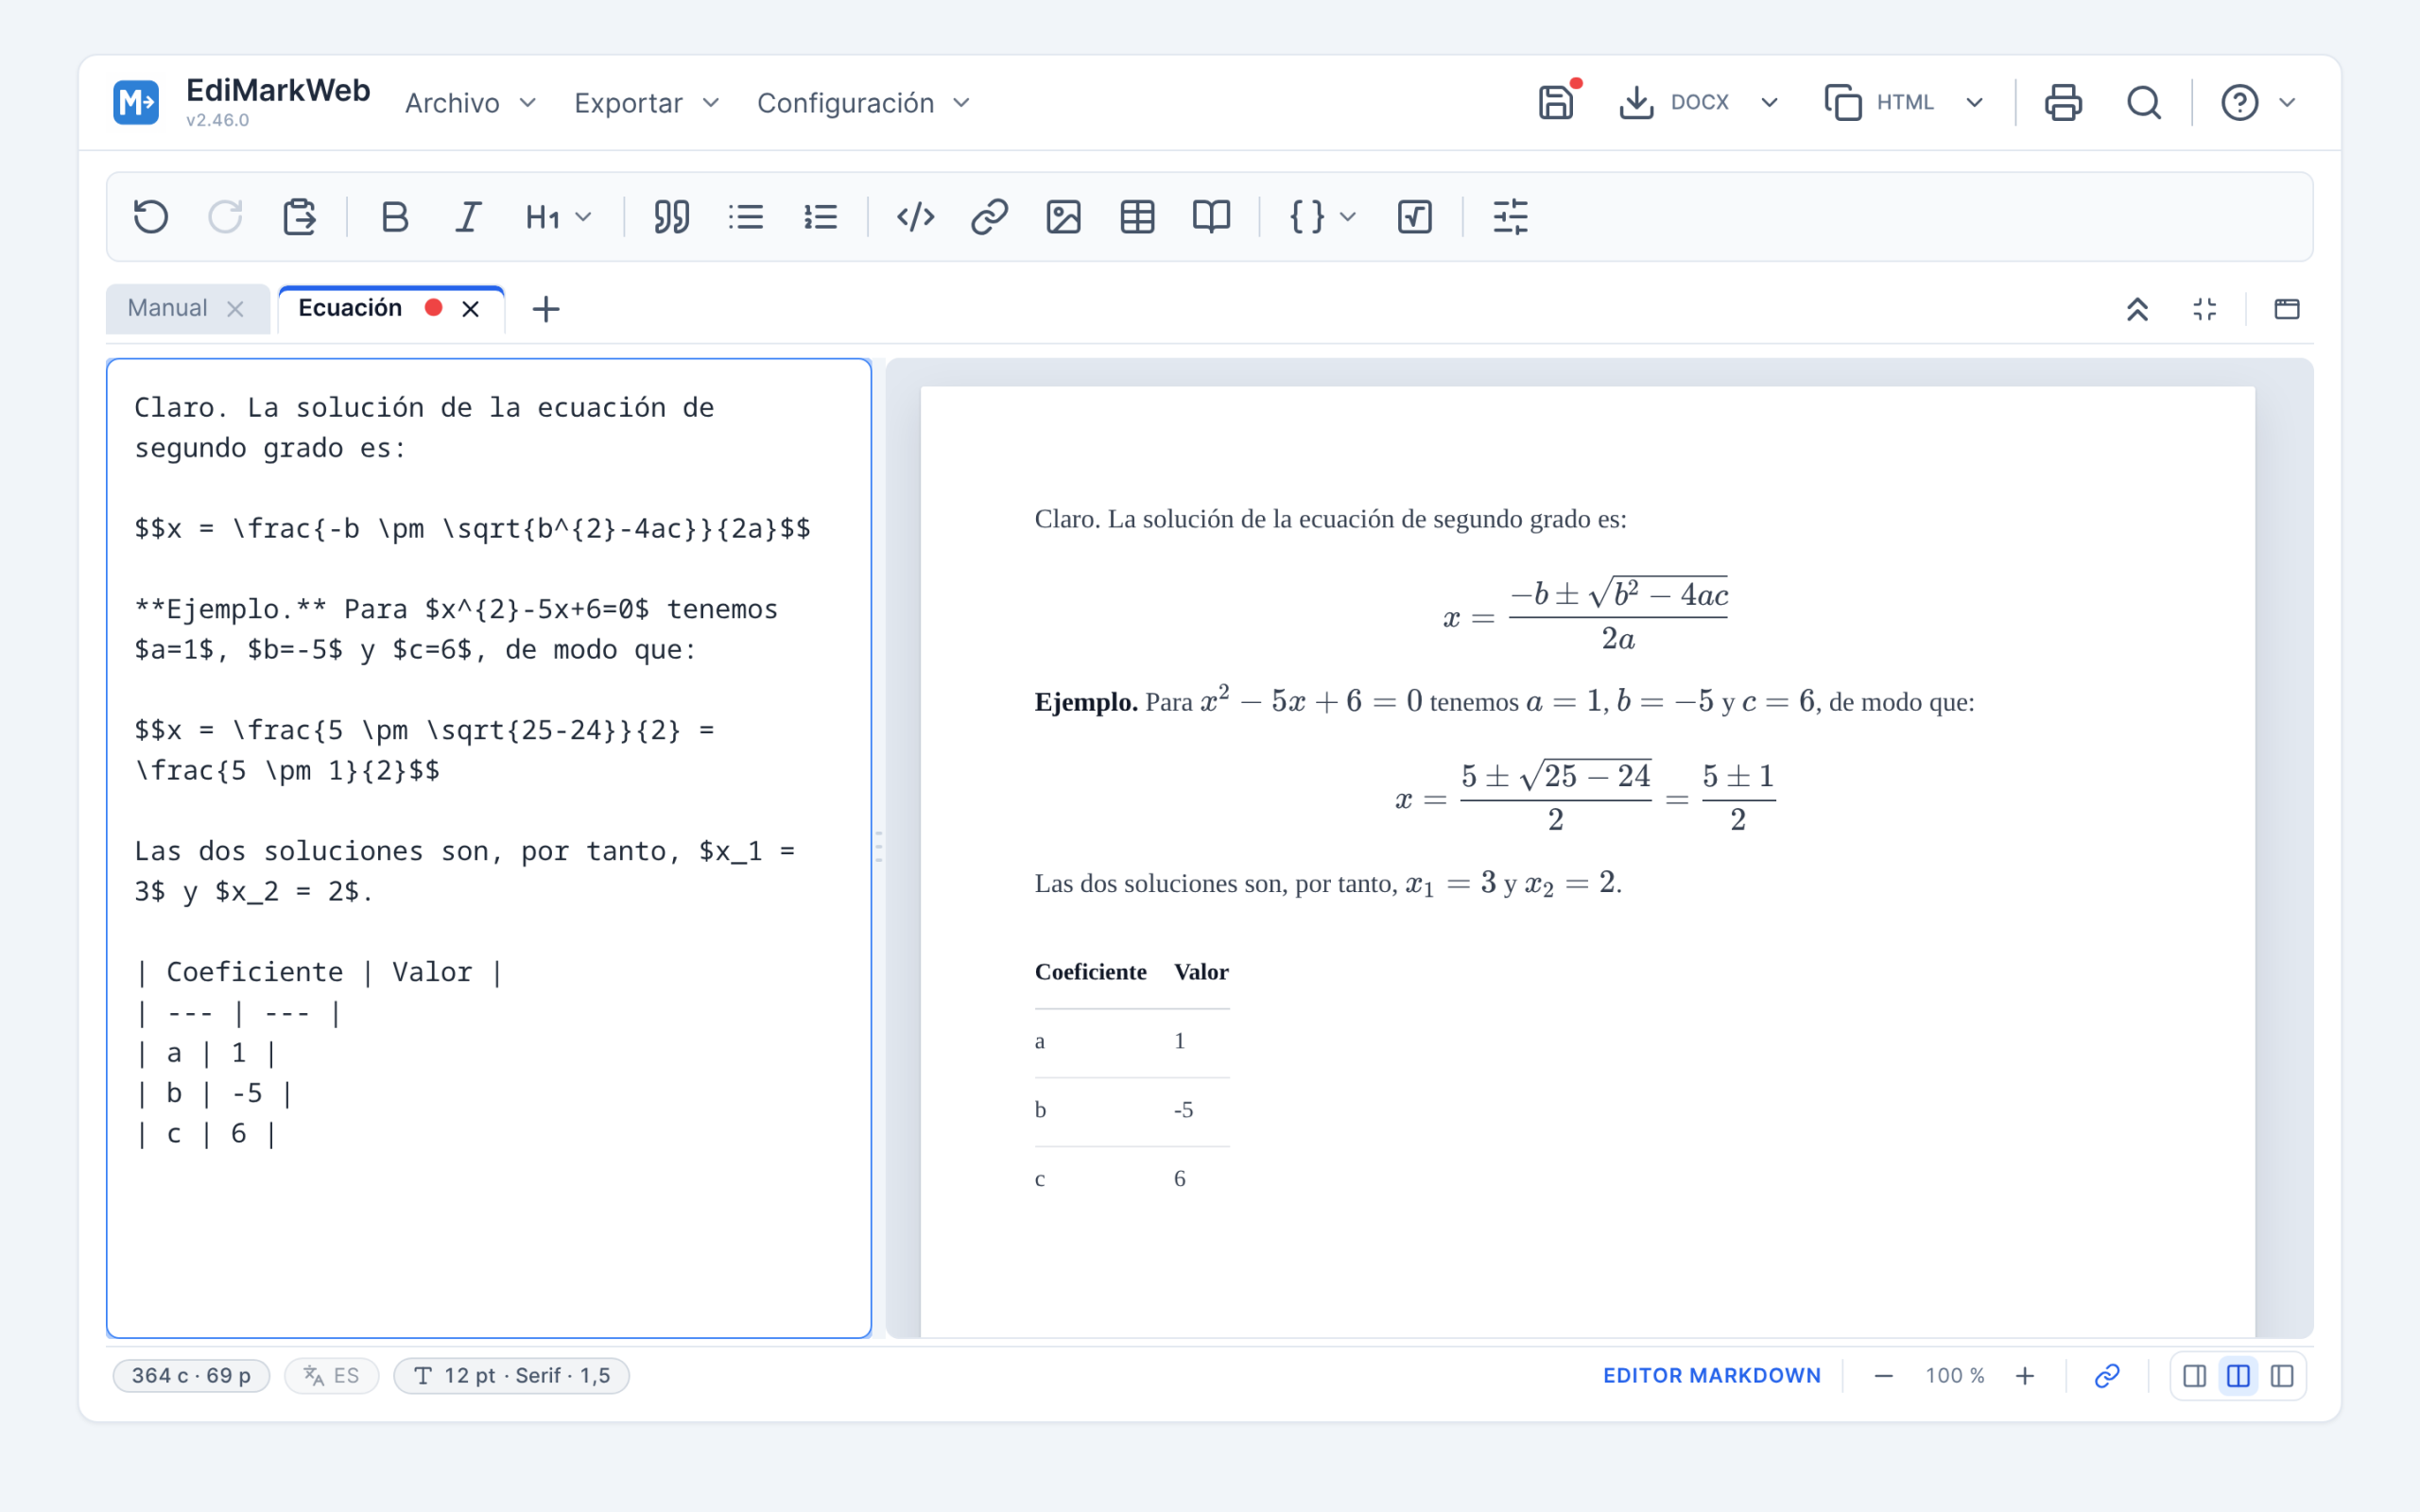
A la izquierda, la respuesta tal como se copia del chat. A la
derecha, lo que se obtiene sin tocar nada más.
El pegado admite algo más que texto plano. El botón
Pegar de la barra de herramientas, o el habitual
Ctrl+V, reconoce también el contenido enriquecido que se
copia de una página web o de un documento de Word, y lo convierte a
Markdown, así como las imágenes copiadas al portapapeles, que quedan
incrustadas en el documento. Y para las respuestas que vienen en LaTeX
completo, con su preámbulo y su \begin{document}, está
Archivo → Pegar LaTeX (Ctrl+Mayús+V), que las
convierte en un documento editable.
En la práctica, la conversación con la IA deja de quedarse en el chat
y se convierte en material de trabajo (los ejercicios resueltos, el
examen, los apuntes de un tema) guardado en un archivo propio, en el
ordenador, y en el formato que haga falta.
La vista previa compone
la página real
El cambio más visible de las últimas versiones está en el panel
derecho, que ha pasado de mostrar una aproximación del documento a
componer la página tal como se va a imprimir. La hoja mide lo que mide
un A4 o una Carta y el texto se reparte en páginas, con su separación
entre una y otra. El corte cae siempre entre dos bloques, nunca a media
línea, como en un procesador de textos.
Con el índice activado, el editor visual lo muestra al principio
de la hoja, con el número de página de cada apartado, y lleva hasta
ellos al pulsarlo. No forma parte del texto: el índice definitivo lo
genera cada formato al exportar.
El aumento se aplica a la página completa, con sus márgenes, en lugar
de reordenar el texto, de modo que el reparto se conserva. Un
interruptor con forma de cadena vincula además el ancho del panel y el
aumento en los dos sentidos: al apartar el separador la hoja crece, y al
modificar la lupa es el separador el que se retira para dejarle sitio.
La página se ve así siempre entera, sin barra de desplazamiento
horizontal.
El reparto es exacto para el PDF y para la impresión, que se generan
a partir de esta misma hoja.
Y no solo texto e imágenes: si el documento lleva un audio o un vídeo
escritos en HTML, incluido un vídeo de YouTube, la hoja los muestra ya
como reproductor, y siguen ahí al corregir sobre el panel visual.
Las fórmulas
Las fórmulas se escriben en LaTeX entre delimitadores, y se admiten
los cuatro habituales: \(...\) y $...$ para
las que van dentro de una línea, \[...\] y
$$...$$ para las que van aparte. Los dos primeros son los
recomendados, porque el dólar también aparece en el texto por sus
propios motivos y ahí puede confundirse con el principio de una fórmula.
La vista previa las compone al momento con KaTeX, mientras se escribe.
Hay tres maneras de ponerlas: el menú de fórmulas del editor Markdown,
que inserta los delimitadores sin tener que recordarlos; una ventana
propia en el editor visual, que muestra el código y el resultado a la
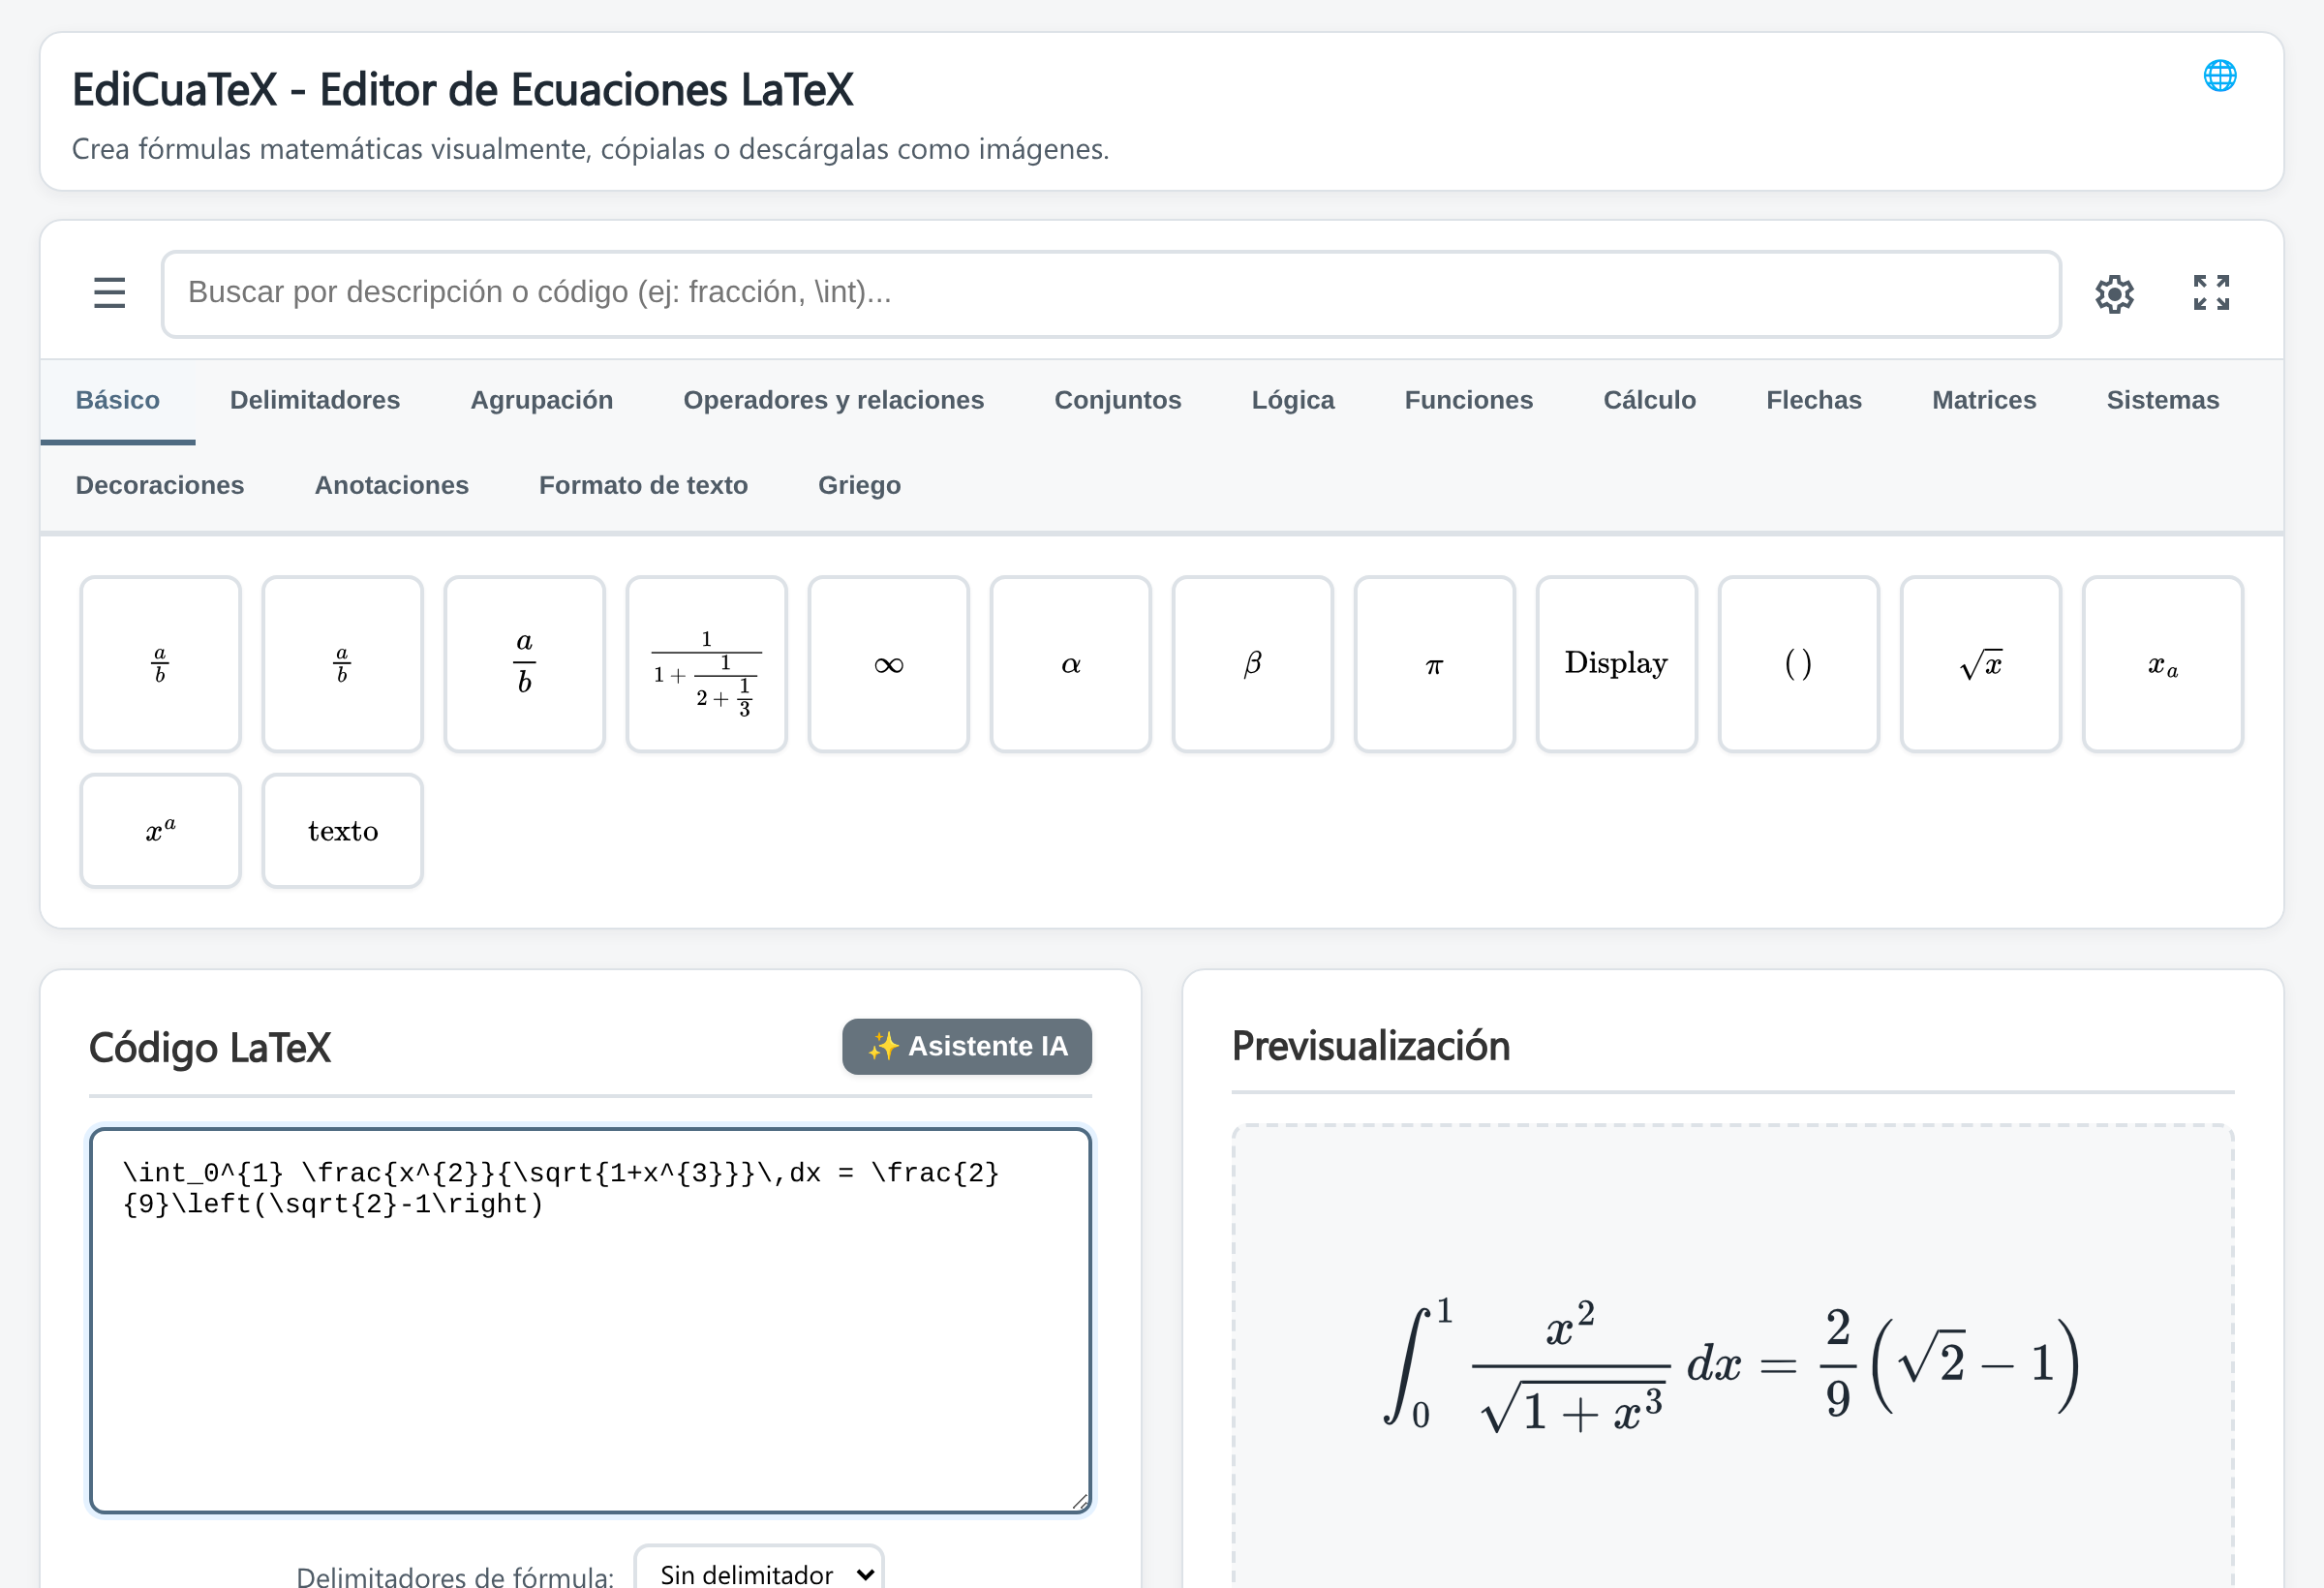
vez y avisa del error si lo hay; y EdiCuaTeX, el editor visual de
ecuaciones, para quien no domine la sintaxis.
EdiCuaTeX se abre desde la propia barra de herramientas. Se elige
el elemento de una galería ordenada por temas y la fórmula construida
aquí se inserta en el documento sin copiar ni pegar nada.
Los formatos de entrada y
de salida
Editores de Markdown hay muchos. Lo que distingue a EdiMarkdown son
los formatos que admite al abrir un documento y los que produce al
exportarlo.
Todo pasa por el mismo punto: se importa el documento, se edita
en Markdown y se exporta al formato que haga falta.
Lo que entra. Además de los archivos Markdown, se
pueden abrir documentos de Word (.docx), de LibreOffice
(.odt), libros digitales (.epub), páginas web
(.html), documentos LaTeX (.tex) y archivos
PDF, que se convierten a Markdown al abrirlos. El PDF es la
incorporación más reciente y tiene apartado propio más abajo. Las
imágenes de los DOCX, ODT y EPUB se extraen del propio archivo, de modo
que no se pierden, y de un EPUB vuelve además el idioma, que el libro
guarda en su envoltorio y no en el texto. Los archivos se pueden
arrastrar sobre la ventana, incluso carpetas enteras: cada documento
compatible se abre en su pestaña y lo demás se ignora.
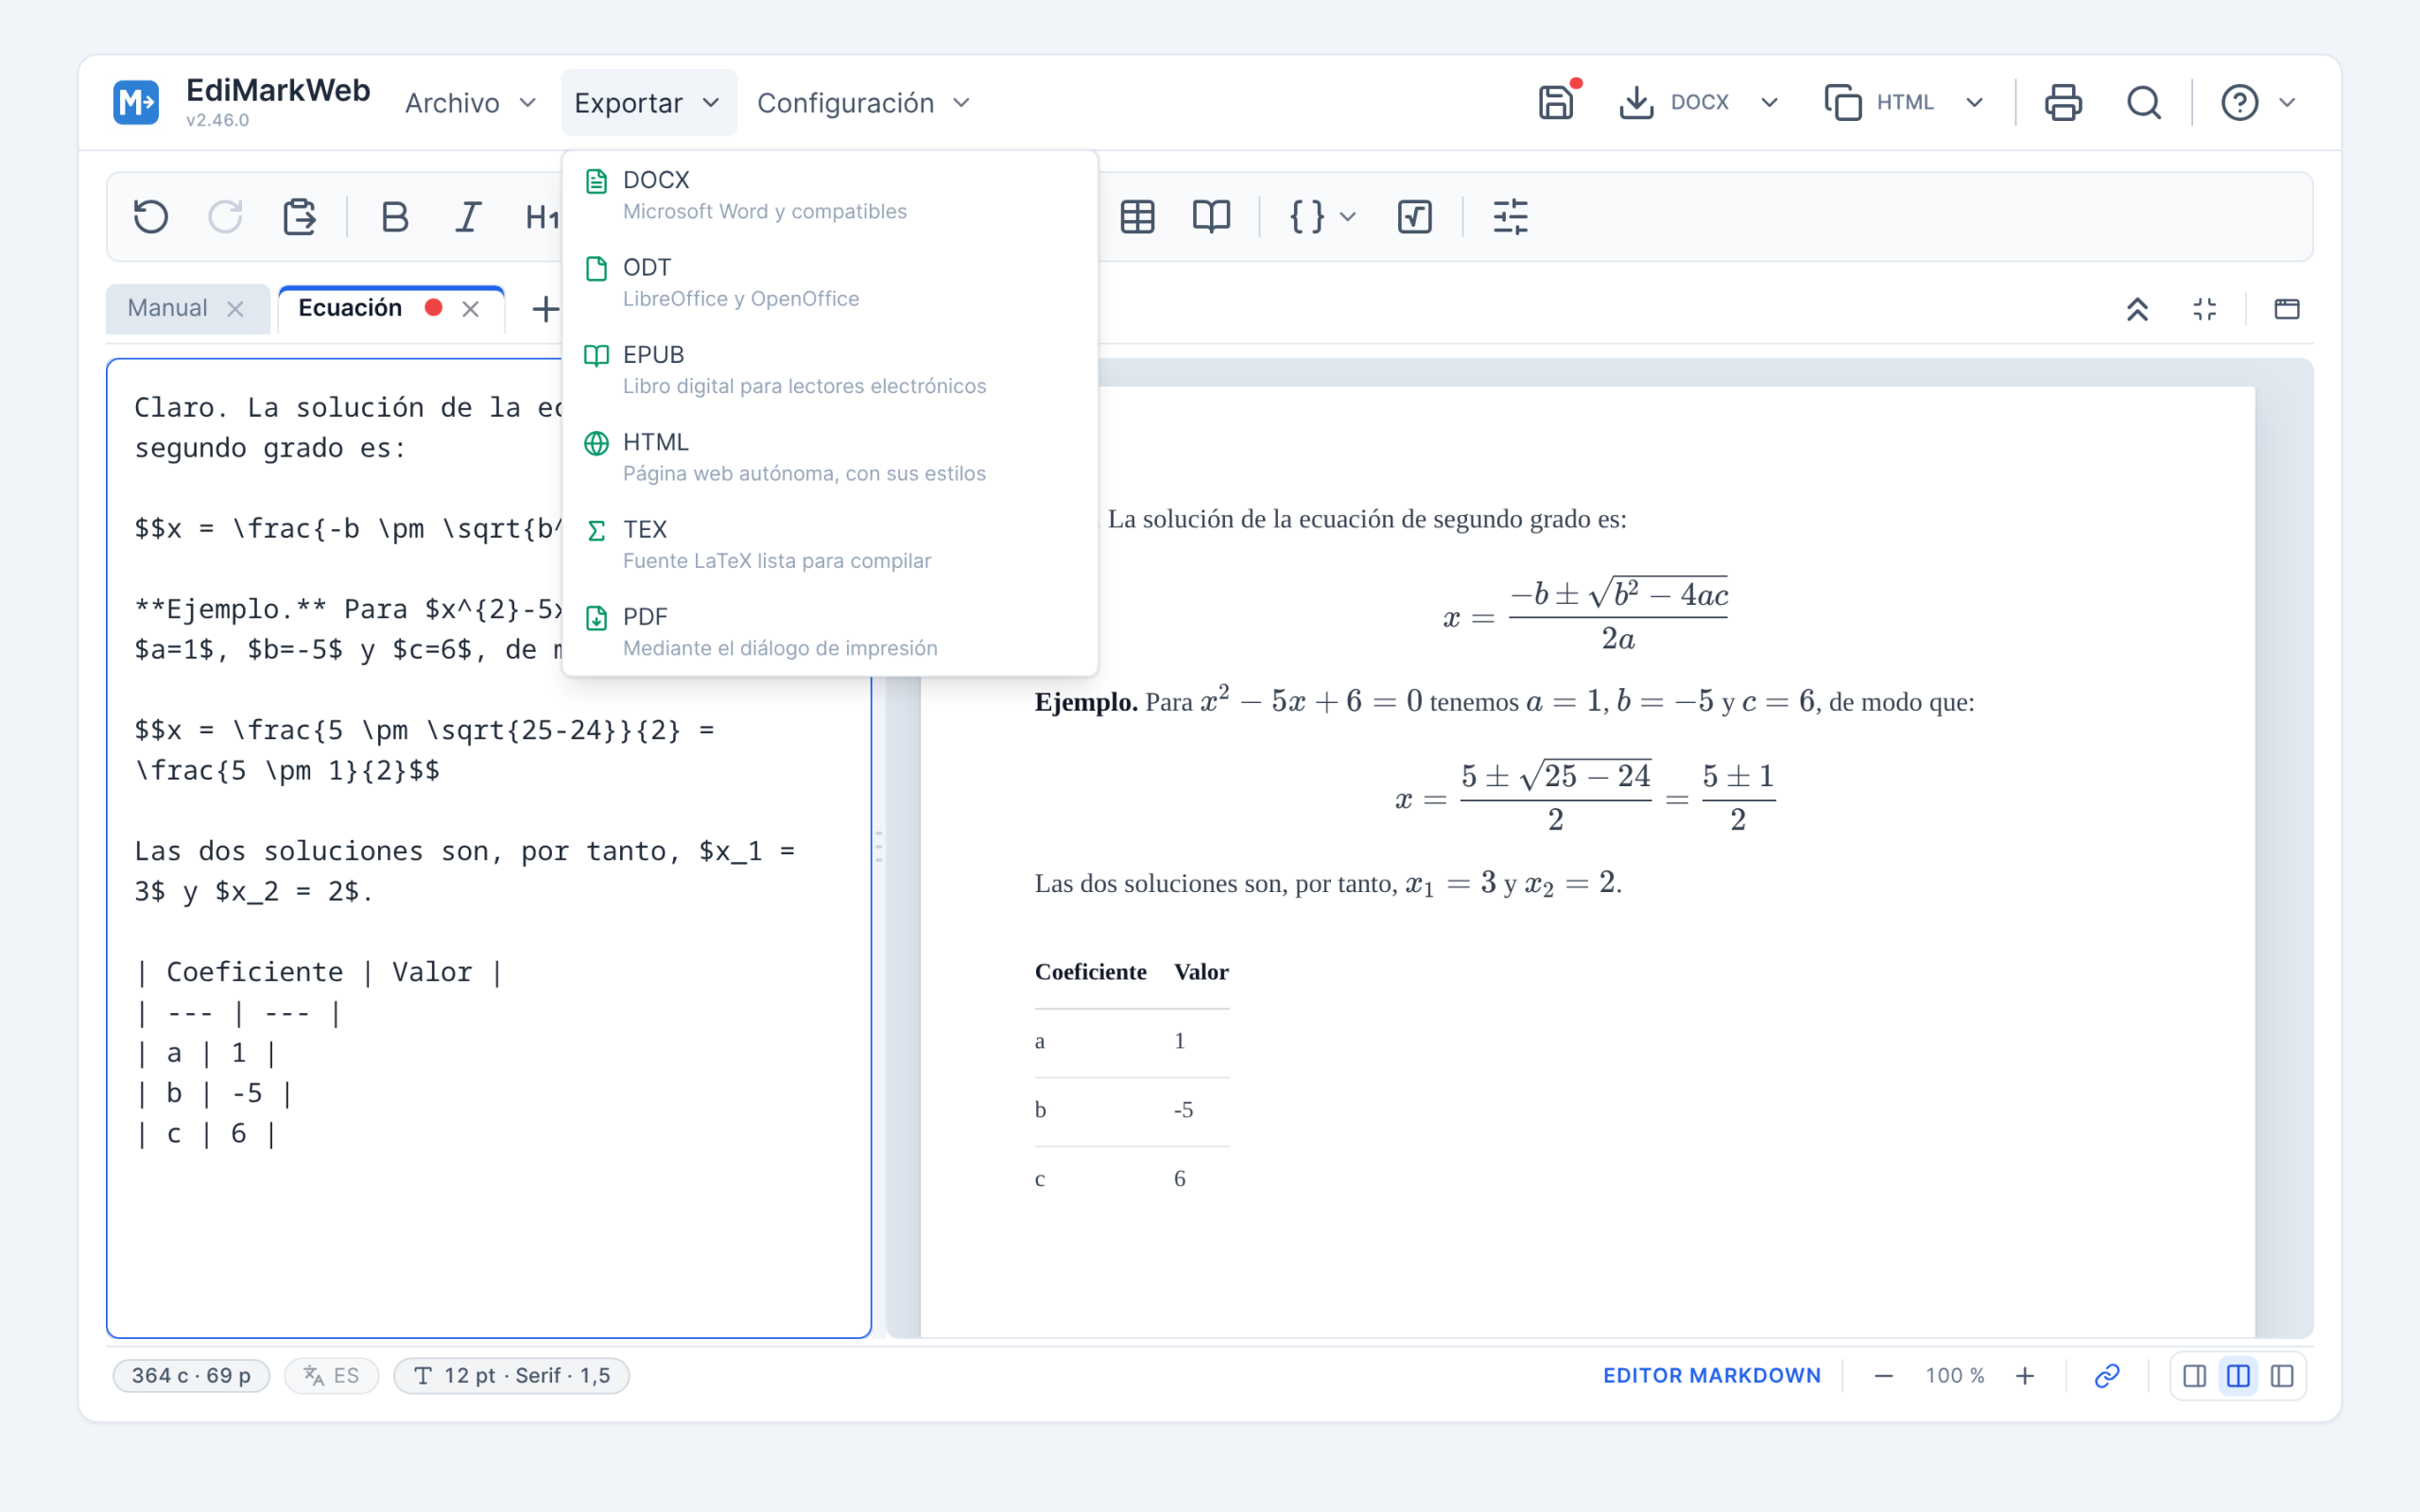
Lo que sale. Del mismo documento se obtiene un DOCX
para quien trabaja con Word, que es también el formato con el que Google
Docs importa y exporta, de modo que el mismo archivo sirve para los dos,
un ODT para LibreOffice, un EPUB que se lee en cualquier lector de
libros electrónicos, una página web autónoma (con los estilos y las
fórmulas dentro del propio archivo, lista para subir a un servidor) o un
.tex preparado para compilar. Y el PDF, que es la sexta
salida del menú: abre el diálogo de impresión del sistema, donde se
elige «Guardar como PDF» como destino. Lo que sale es exactamente lo que
se ve en la hoja, con las fórmulas compuestas, los márgenes del
documento y el texto seleccionable y buscable.
Exportar es un menú propio, entre Archivo y Configuración, con
cada formato explicado bajo su nombre. Archivo, al lado, reúne lo que
trae contenido: abrir, importar, pegar LaTeX.
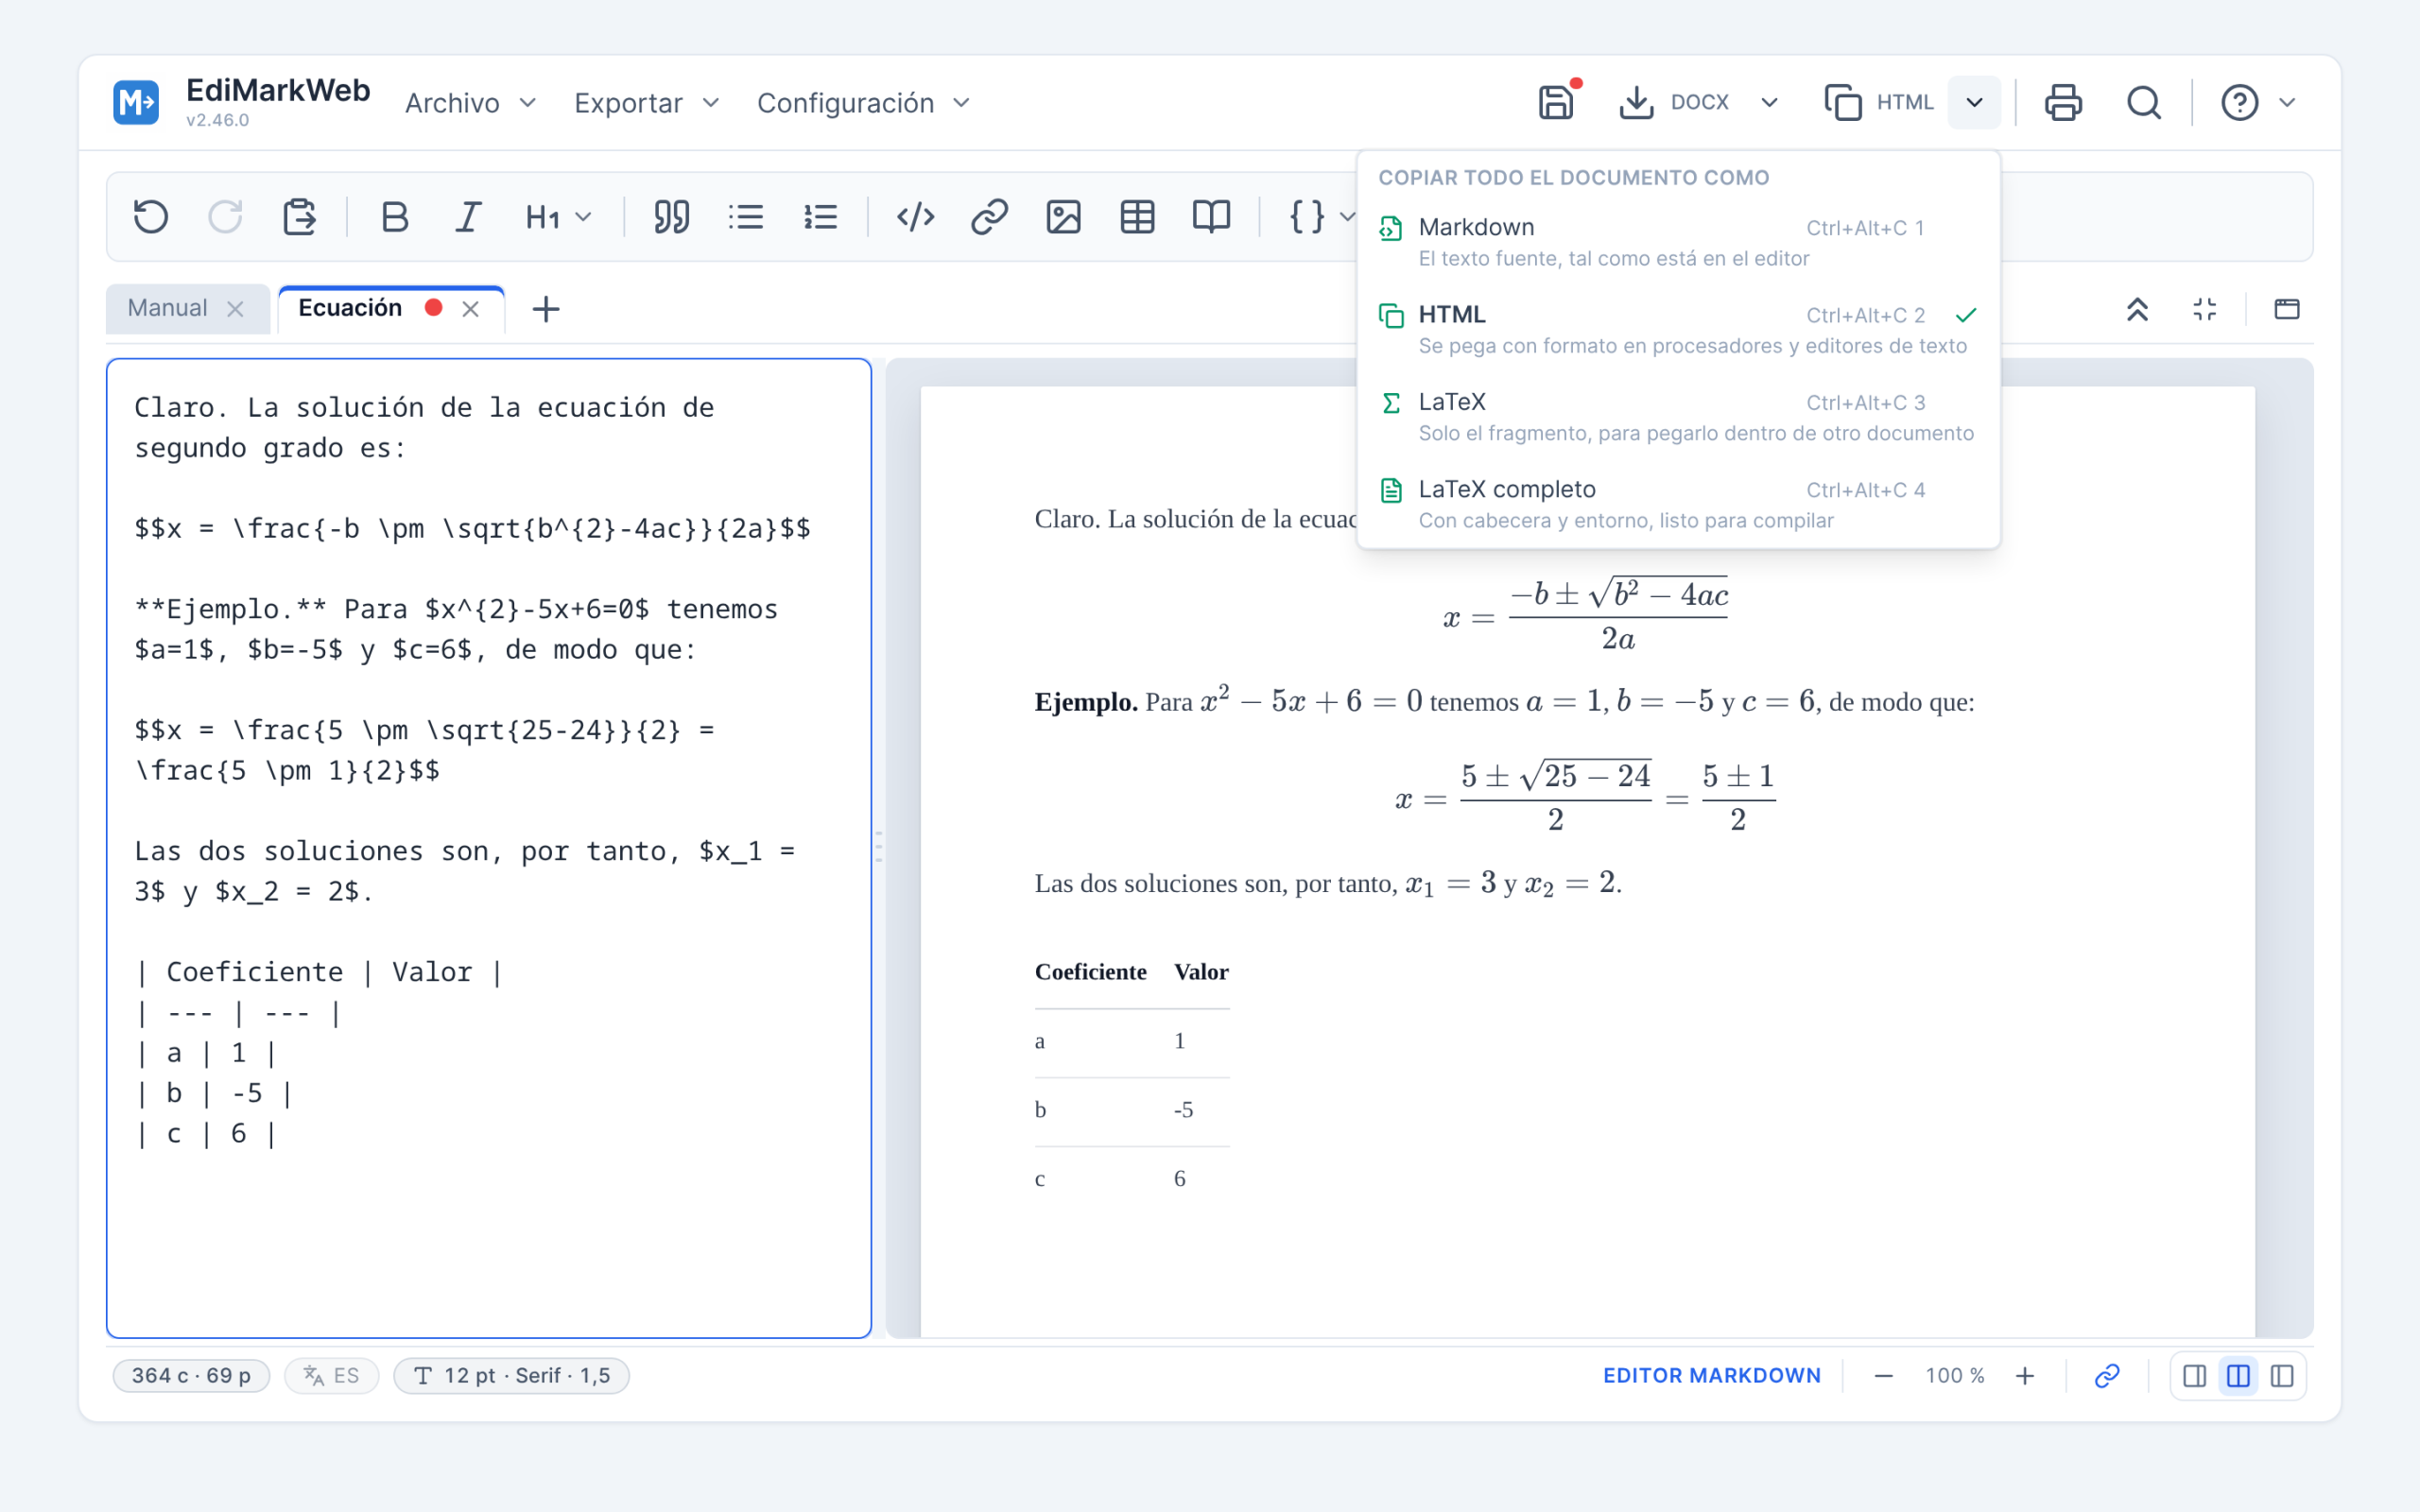
En la barra de arriba, junto al icono de guardar, hay además dos
botones que repiten de un clic el último formato usado, y lo dicen en un
rótulo pequeño: uno exporta a un archivo y el otro copia al
portapapeles.
Lo que no llega a ser archivo. El botón de copiar
hace lo mismo que Exportar con otro destino, el portapapeles, y ofrece
cuatro formatos: Markdown, HTML, LaTeX y LaTeX completo. El útil para el
trabajo diario es el HTML, porque pega el documento con su
formato en Word, LibreOffice, Google Docs o el correo, con los
encabezados, las negritas, las listas y las tablas ya compuestos, sin
pasar por ningún archivo intermedio. Dos advertencias: las fórmulas se
pegan como texto, así que para llevarlas como ecuaciones hay que
exportar a DOCX u ODT, y las imágenes solo viajan si están incrustadas
en el documento.
El botón recuerda el último formato elegido y lo dice a su lado,
de modo que volver a copiar en ese formato es un solo clic.
Importar un PDF
El PDF es el formato en el que circula casi todo el material que ya
está hecho: los apuntes de otros años, las orientaciones de la
Administración, un artículo, un libro de texto. Recuperar ese contenido
para reutilizarlo obligaba hasta ahora a pasar por un servicio externo,
que casi siempre convierte primero a DOCX y devuelve un documento lleno
de cuadros de texto.
EdiMarkdown lo convierte a Markdown en el propio
equipo, sin enviar el archivo a ningún servidor. Se elige el
PDF en Archivo → Importar, o se arrastra sobre la ventana, y
aparece un cuadro que dice cuántas páginas tiene antes de empezar. Se
puede eliminar los encabezados y los pies repetidos, conservar las
imágenes y las fórmulas detectadas, y convertir solo unas páginas
concretas escribiéndolas como 12-20, 35.
La conversión se revisa antes de tocar nada: la vista previa
muestra el principio del documento y el botón de la derecha lo lleva a
una pestaña nueva. Este informe tiene 442 páginas y se han pedido
siete.
Los documentos escaneados, que no llevan texto sino la fotografía de
cada página, se resuelven con reconocimiento óptico de
caracteres. La opción solo aparece cuando el programa detecta
páginas de ese tipo, y entonces dice cuántas son y en qué páginas están.
Viene desactivada, porque descarga un motor de reconocimiento y la
conversión pasa a ser bastante más lenta.
El resultado es Markdown corriente: se corrige, se le cambia el
formato y se vuelve a exportar al formato que haga falta.
Las imágenes del PDF se guardan aparte, como archivos junto al
documento, y no dentro del texto, de modo que un informe con cien
fotografías no llena el almacenamiento del navegador. Las tablas se
importan como tablas, también las de los formularios, que no tienen fila
de títulos.
Las notas al pie llegan como notas. Un PDF guarda la llamada del
texto y la nota del final de la página como dos trozos sin relación; la
importación los reúne en una nota al pie, con su número y su enlace de
vuelta, también cuando la llamada está dentro de una tabla o en un
título. Solo se convierte lo que tiene las dos mitades: un número
elevado sin nota debajo, como el de un metro cuadrado, sigue siendo un
exponente.
Conviene saber qué se puede esperar. El límite es de 50 MB por
archivo, sin límite de páginas; a partir de un centenar el propio cuadro
avisa de que puede tardar minutos, y una barra va diciendo por dónde va,
página a página, para que no parezca detenido. Los PDF con contraseña
hay que desbloquearlos antes.
Con un documento de varios cientos de páginas, venga de un PDF o no,
la aplicación abre el texto y deja la hoja para después: aparece un
aviso con Mostrar la vista previa y el documento está
listo para escribir en él desde el primer momento. Componer la página de
un documento así deja el programa sin responder unos segundos, y al
abrirlo nadie ha pedido esa espera; cuando se pide, un aviso lo advierte
antes de empezar.
Citas y bibliografía
Las citas y la bibliografía amplían el uso del programa más allá de
la preparación de materiales de clase: sirven igualmente para una
memoria, un artículo o un trabajo de fin de grado.
Se carga una biblioteca en BibTeX
(.bib) o CSL JSON (.json),
los dos formatos que exportan Zotero, Mendeley y Google Académico, y a
partir de ahí las citas se insertan desde un cuadro que busca por autor,
título, año o clave. Quien no tenga todavía una biblioteca puede cargar
la de ejemplo, con siete referencias completas, o escribir las suyas a
mano: el formulario admite artículos, libros, capítulos, informes,
páginas web, tesis y comunicaciones, con los campos propios de cada
tipo, y la clave de cita se genera sola con el apellido, el año y una
palabra del título.
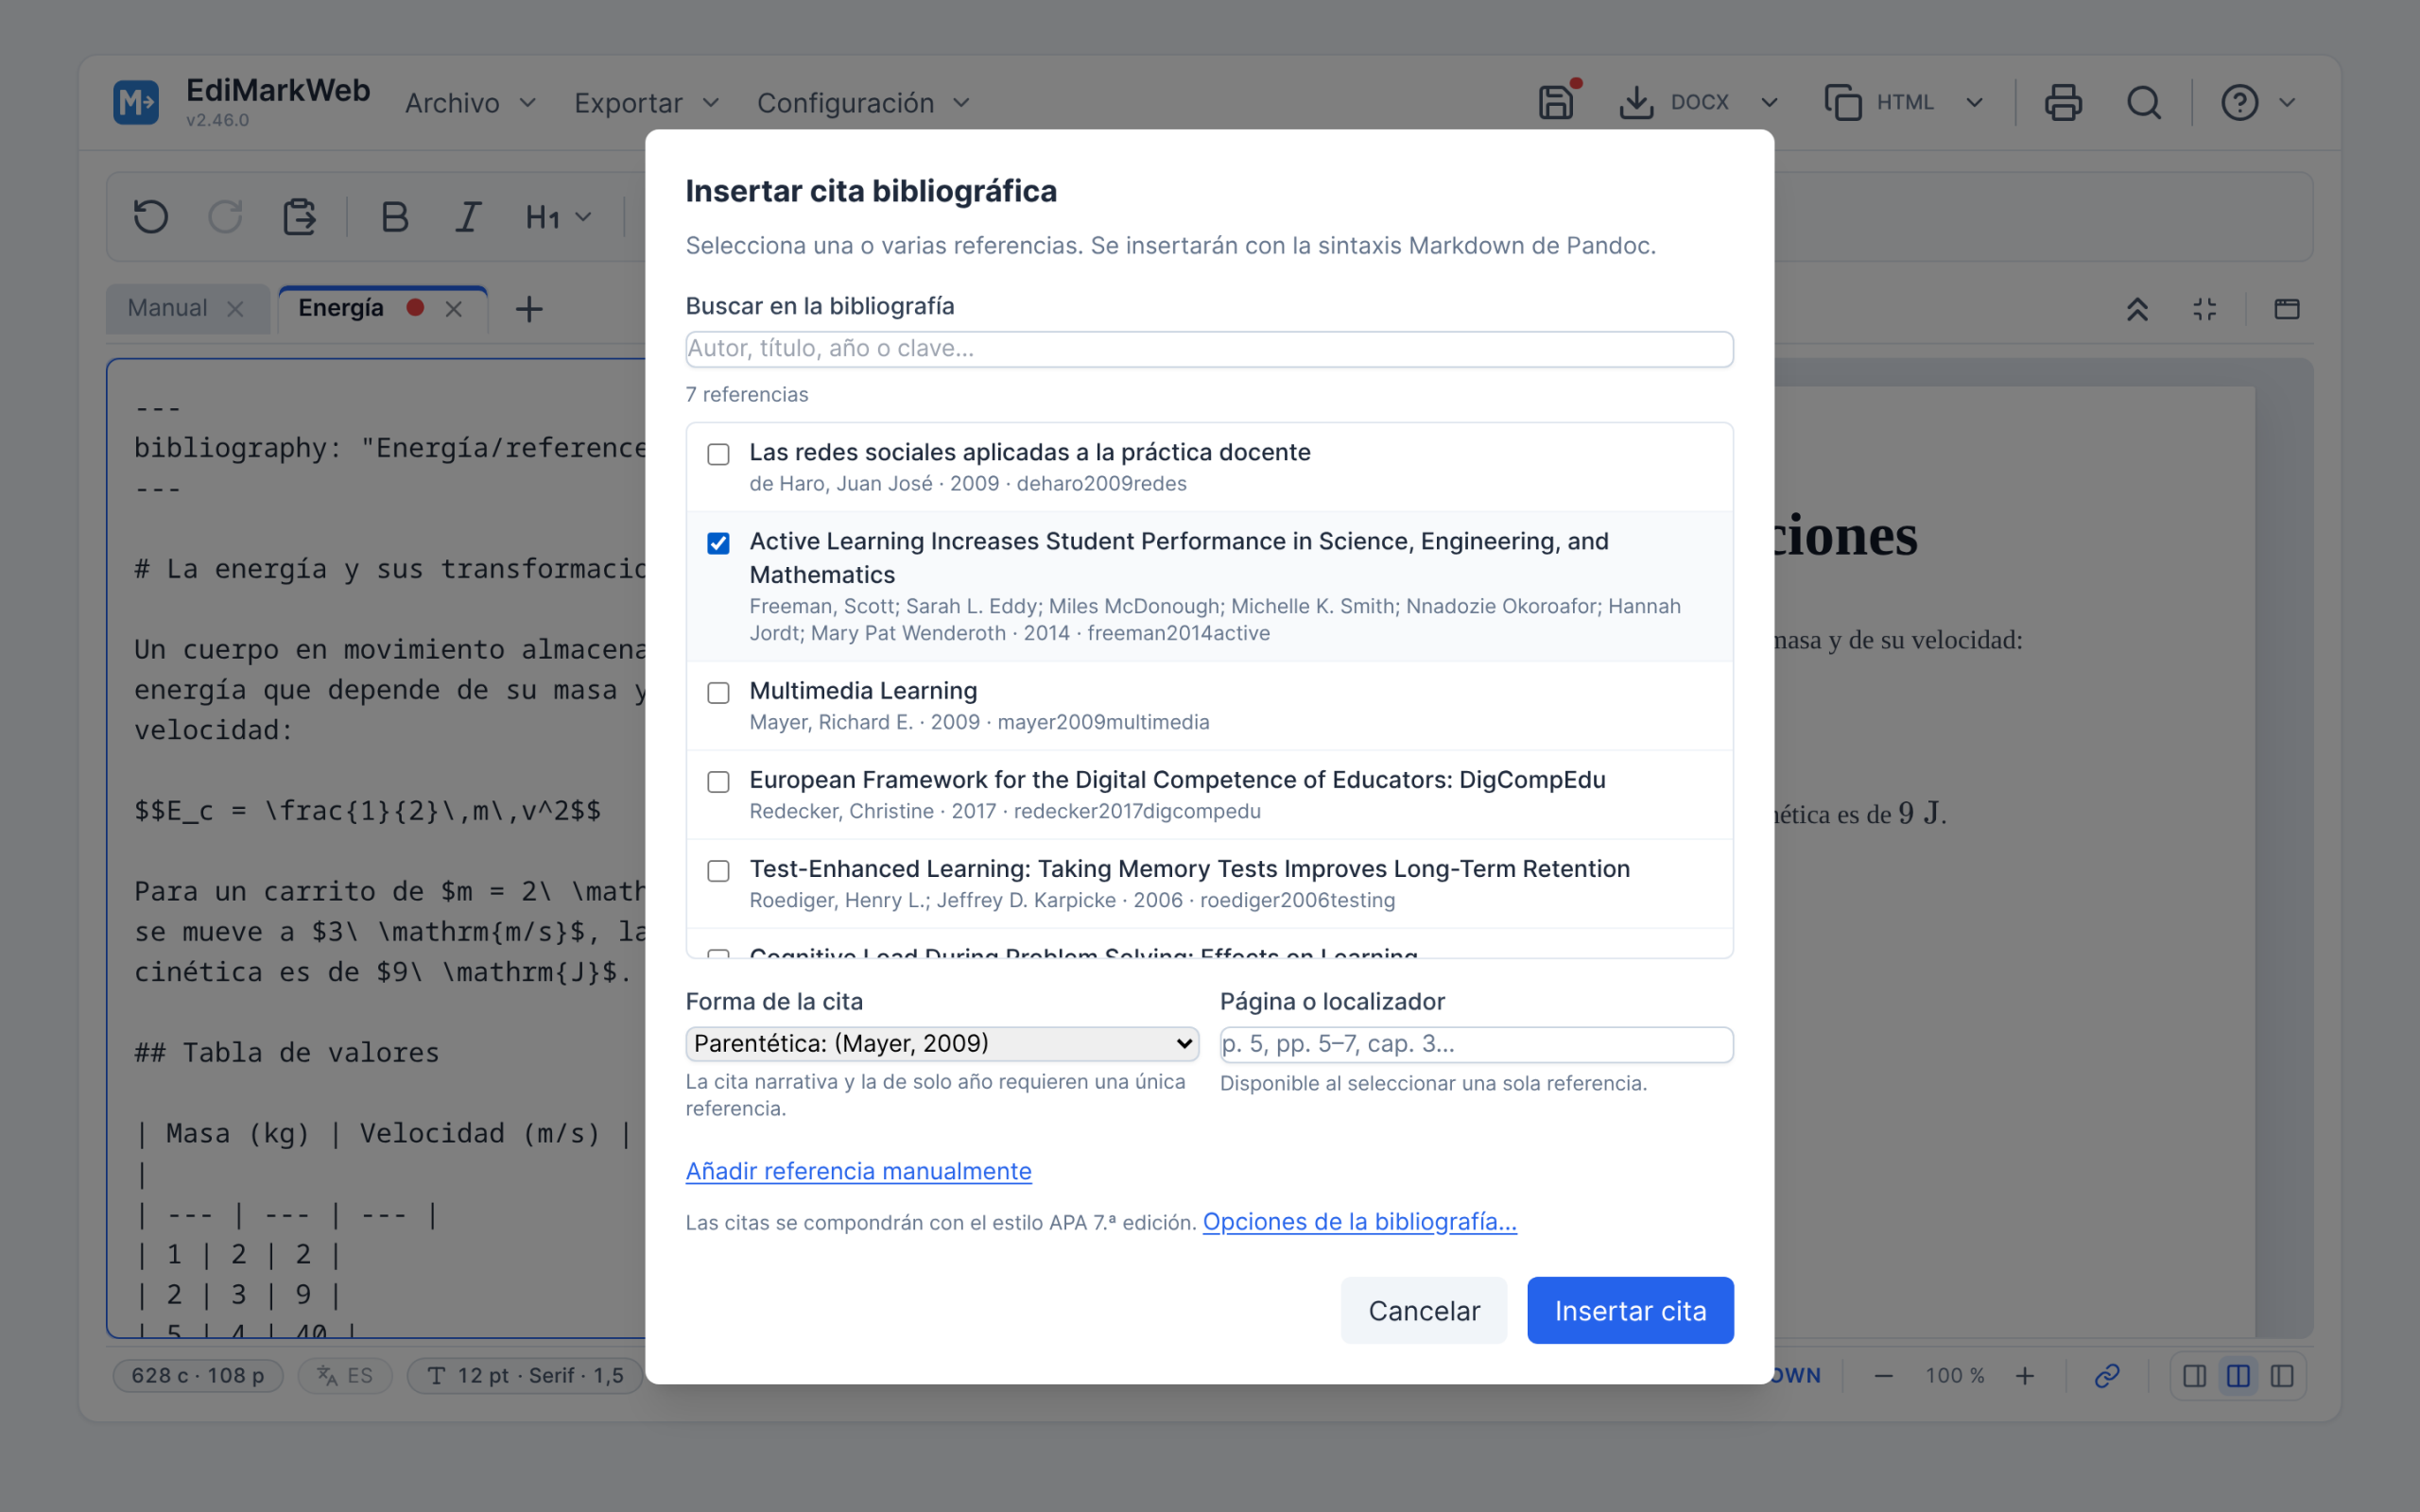
Al pie del cuadro se lee con qué estilo se van a componer las
citas y un enlace lleva a cambiarlo. La forma de la cita puede ser
parentética, narrativa o de solo año, y con una sola referencia se le
puede añadir la página.
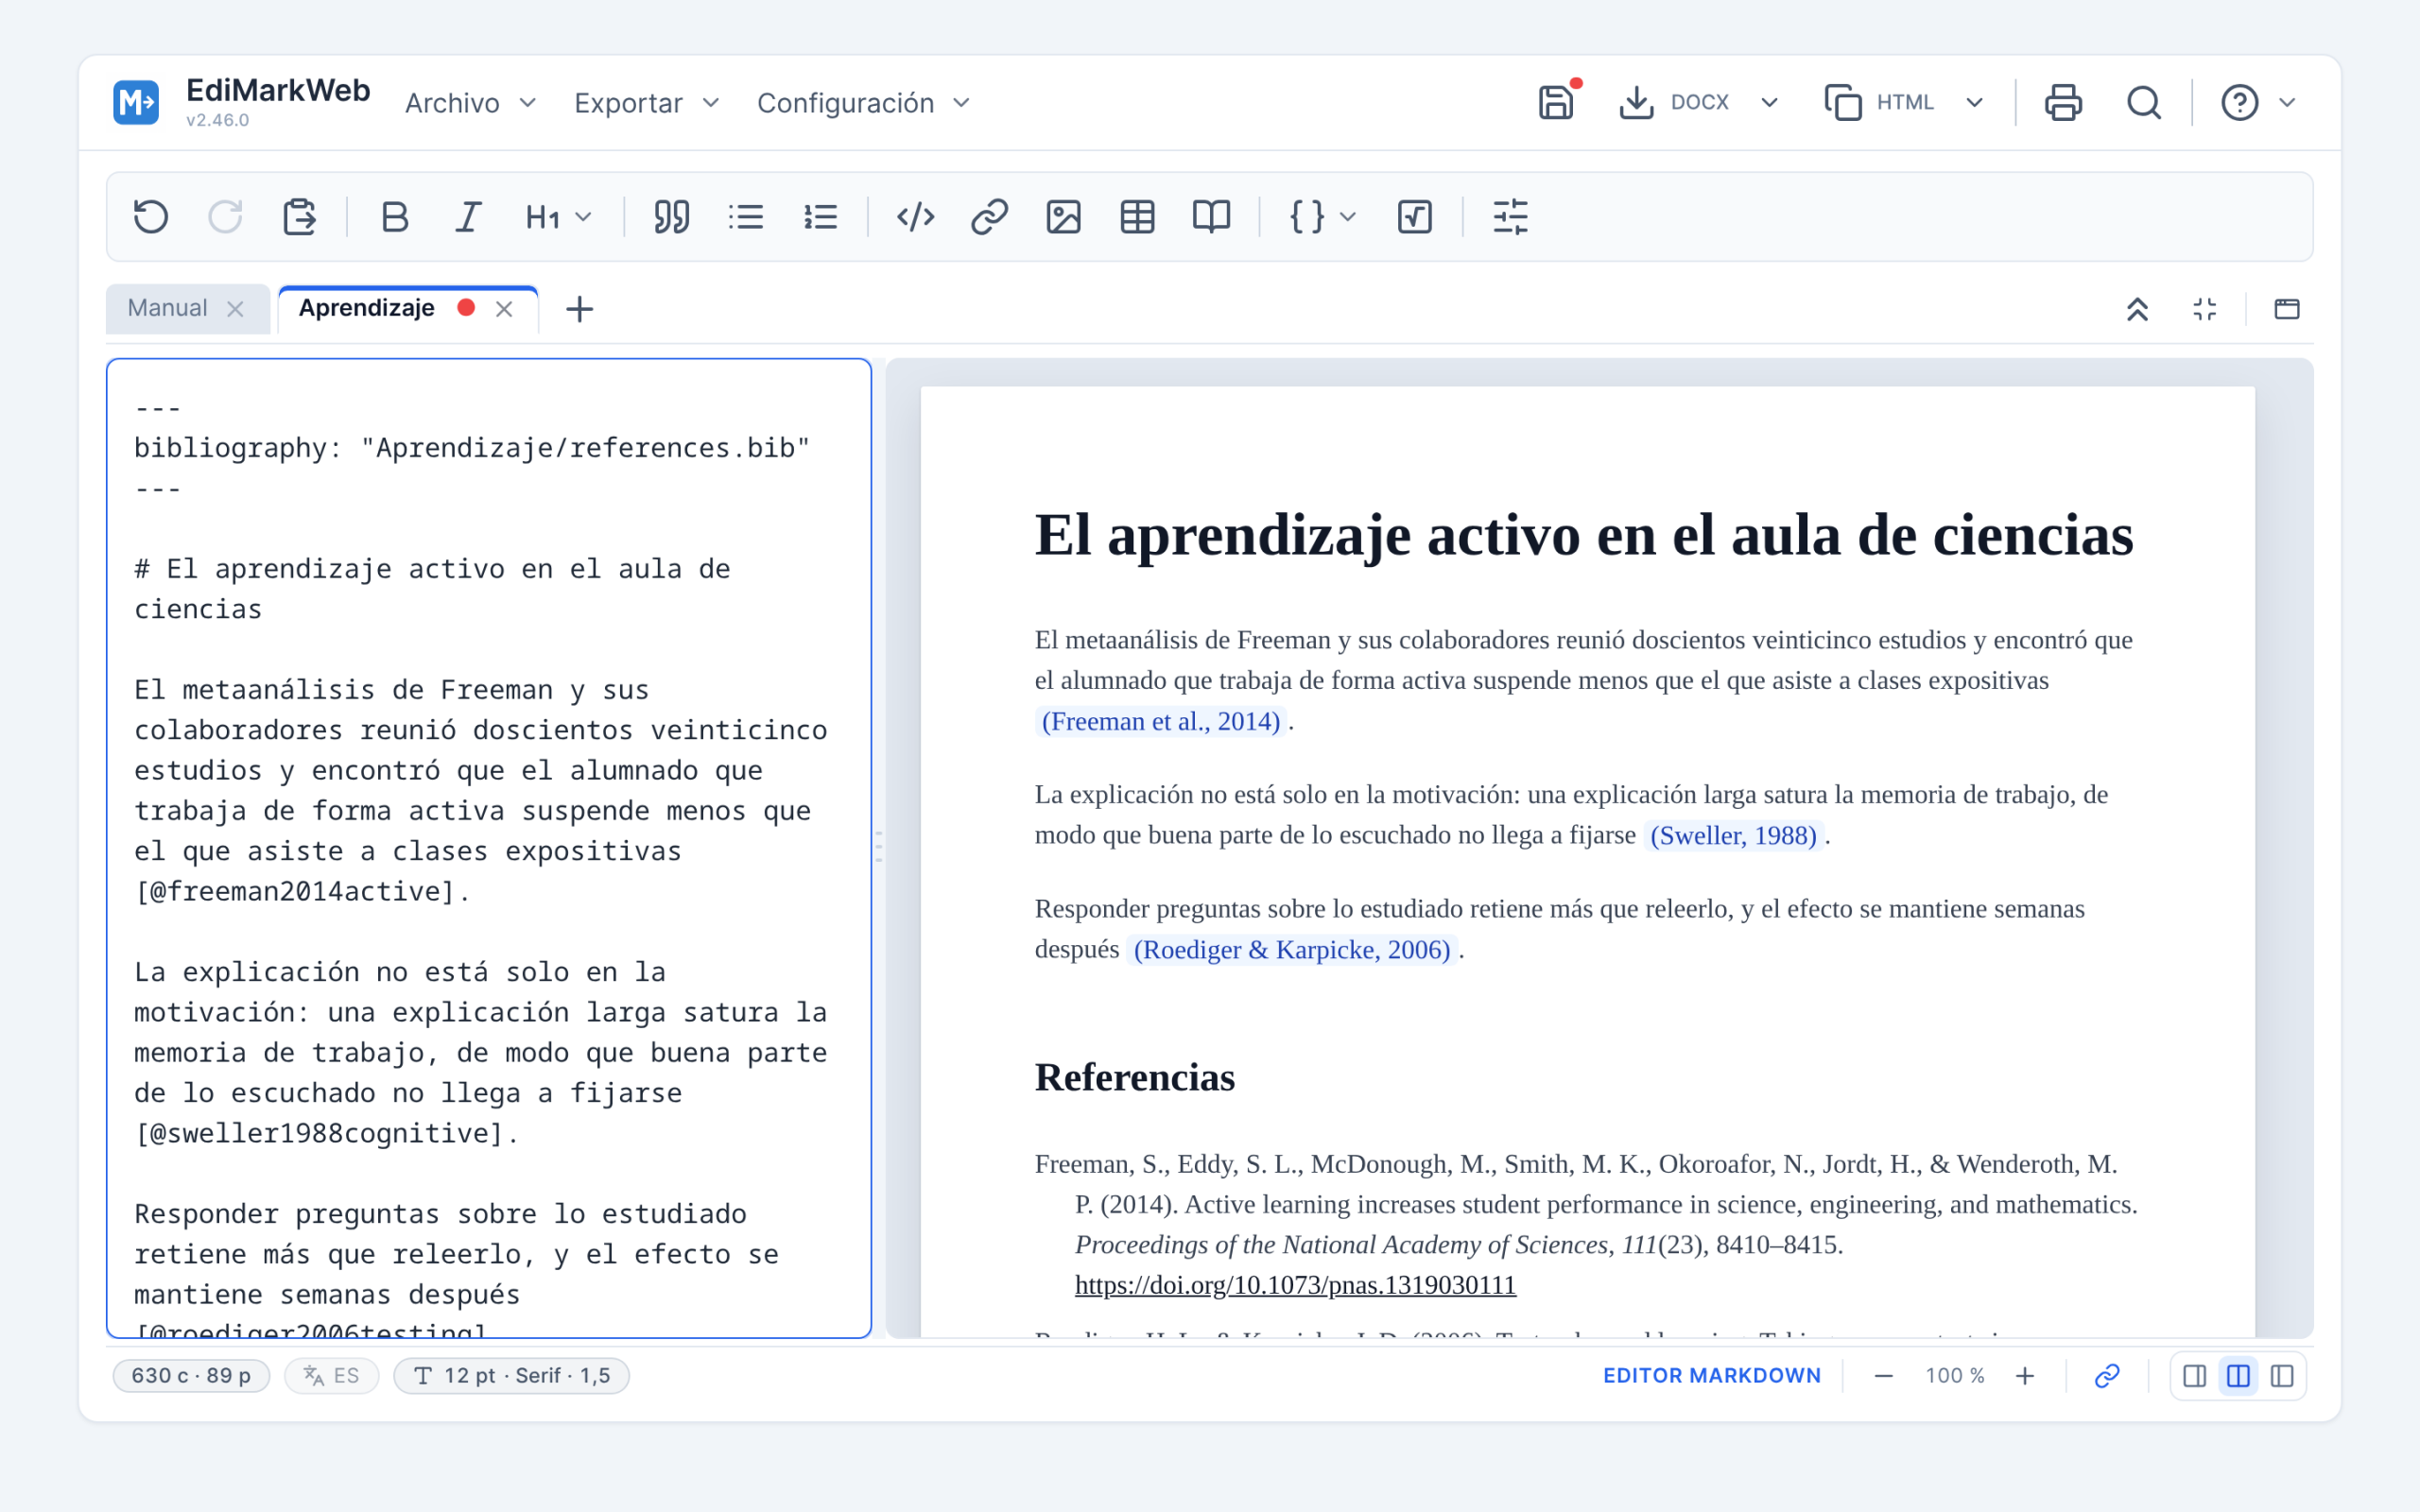
En el texto queda una marca corta, [@freeman2014active],
y de ella salen la cita compuesta y la lista de referencias del final,
ordenada por apellidos. El estilo inicial es APA 7;
también hay Chicago autor-fecha, MLA 9 e IEEE, y se puede cargar un
archivo CSL propio, que es como se ajustan las normas
de una revista o de una universidad concreta.
A la izquierda se escribe la clave; a la derecha aparecen la cita
y las referencias, con la sangría francesa de la norma. Lo mismo sale al
exportar, en los seis formatos.
Al guardar, la biblioteca y el estilo se copian junto al documento,
en su carpeta, y quedan declarados dentro del archivo. Es lo que permite
abrir el mismo trabajo en otro ordenador y que las citas se compongan
igual.
Cada documento, con su
formato
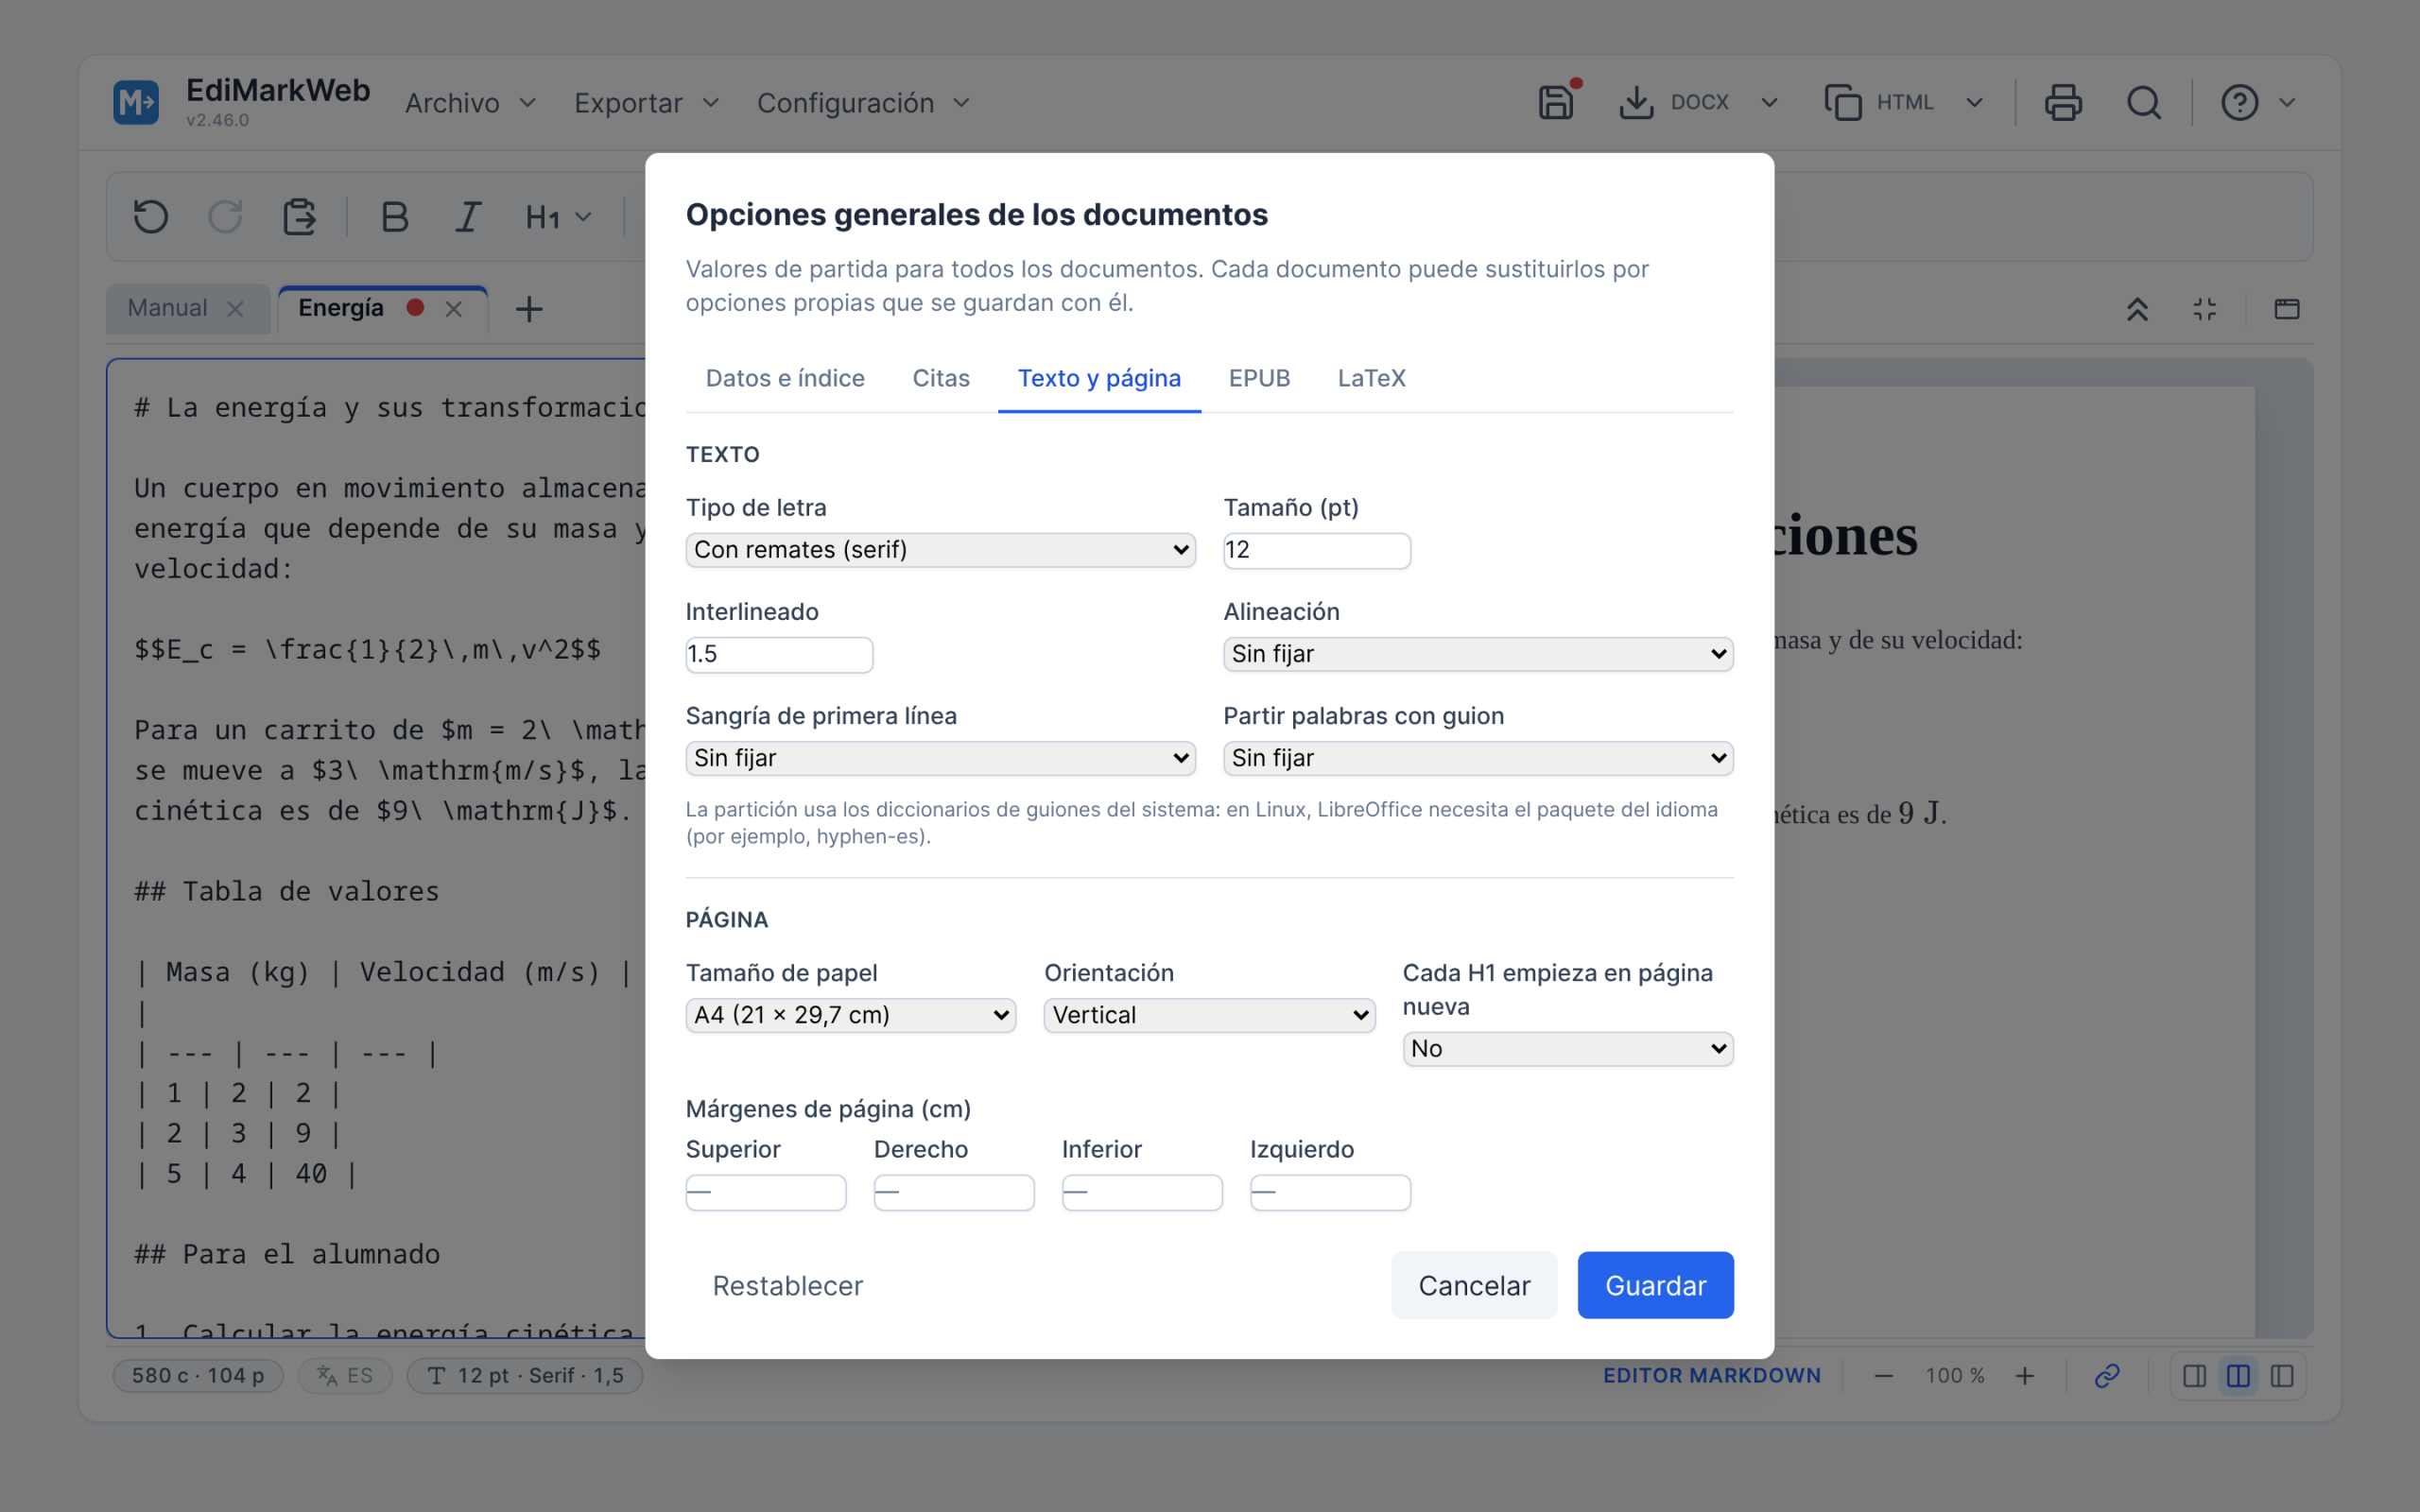
Los ajustes de salida están reunidos en Configuración → Opciones
generales…, que es lo que antes se llamaba opciones de exportación.
Son cinco pestañas: los datos y el índice (idioma, autor, numeración de
apartados, profundidad), el texto y la página, la portada del EPUB, las
citas y, para quien use LaTeX, la clase del documento, sus opciones y un
preámbulo propio.
Estos valores son el punto de partida para todos los documentos y
se recuerdan de una sesión a otra. Lo que fije cada documento manda
sobre ellos.
La pestaña de texto y página reúne lo que suele obligar a retocar el
documento una vez exportado: la alineación, el tipo y el tamaño de
letra, el interlineado, el tamaño de papel, la orientación, los márgenes
de los cuatro lados, la sangría de primera línea y la partición de
palabras con guion. Se aplica a la hoja que se está viendo y a todos los
formatos de salida, de modo que el DOCX y el ODT salen ya con la caja y
la tipografía que se quieren.
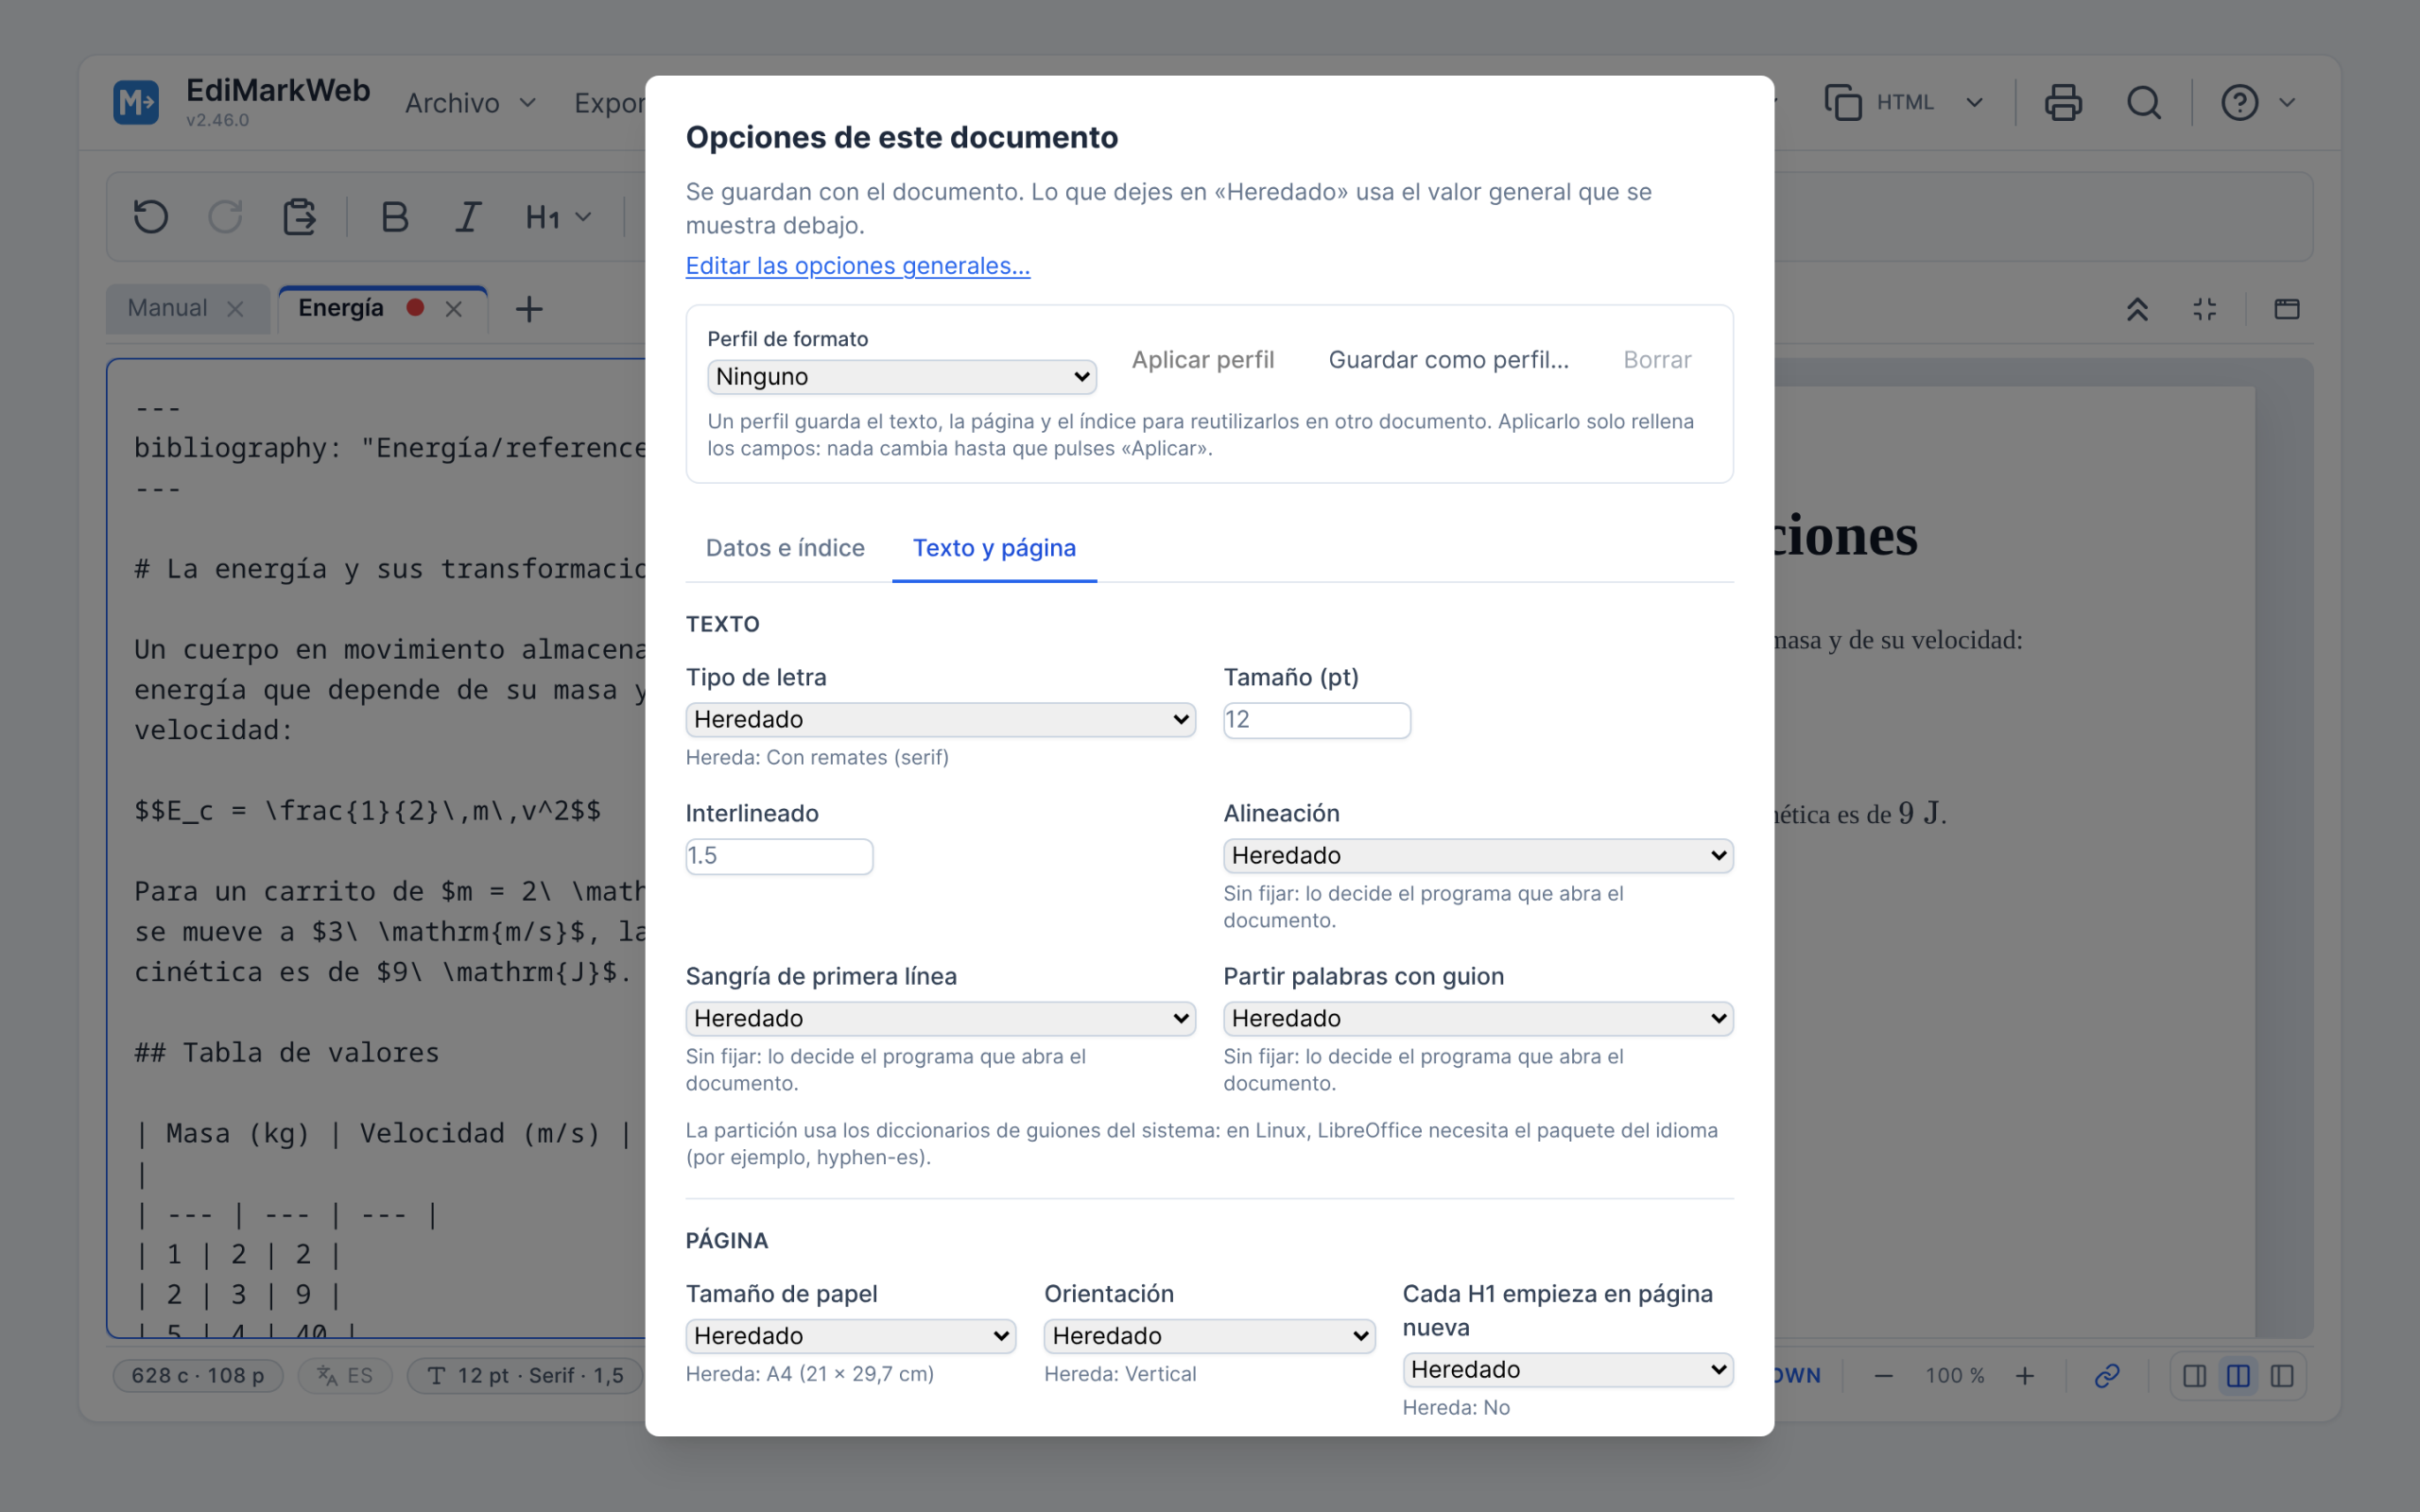
No es necesario que todos los documentos compartan esos ajustes. Cada
uno puede llevar los suyos, junto con su idioma, su autor y su decisión
sobre el índice, en el cuadro Opciones de este
documento, que se abre desde la propia barra de estado. Se
guardan dentro del archivo, en unas líneas de metadatos al principio,
así que viajan con él: un manual quiere índice numerado y una nota de
dos párrafos no, y cada uno lo lleva escrito.
Los ajustes que se repiten se guardan una vez con un nombre
(«TFG», «apuntes») y se aplican después a cualquier documento. Nada
llega al texto hasta que se pulsa Aplicar.
Un detalle que suele dar problemas es el idioma.
Cada documento puede llevar el suyo, guardado dentro del propio archivo,
y todos los formatos de salida lo declaran. Eso es lo que evita que Word
y LibreOffice subrayen en rojo un texto castellano por corregirlo en
inglés, y lo que hace que LaTeX parta bien las palabras.
Las imágenes y la
carpeta del documento
Una imagen se puede insertar de dos maneras: incrustada en el propio
archivo, que se vuelve autónomo pero mucho más pesado, o con ruta
relativa, que es lo recomendado y lo que hace cualquier editor de
Markdown. En ese caso el documento y sus imágenes viajan juntos: al
guardar mi-archivo.md se crea al lado una carpeta
mi-archivo con las imágenes dentro y, si hay bibliografía,
también con ella y con el estilo. Basta conservar los dos para llevarse
el trabajo a otro ordenador.
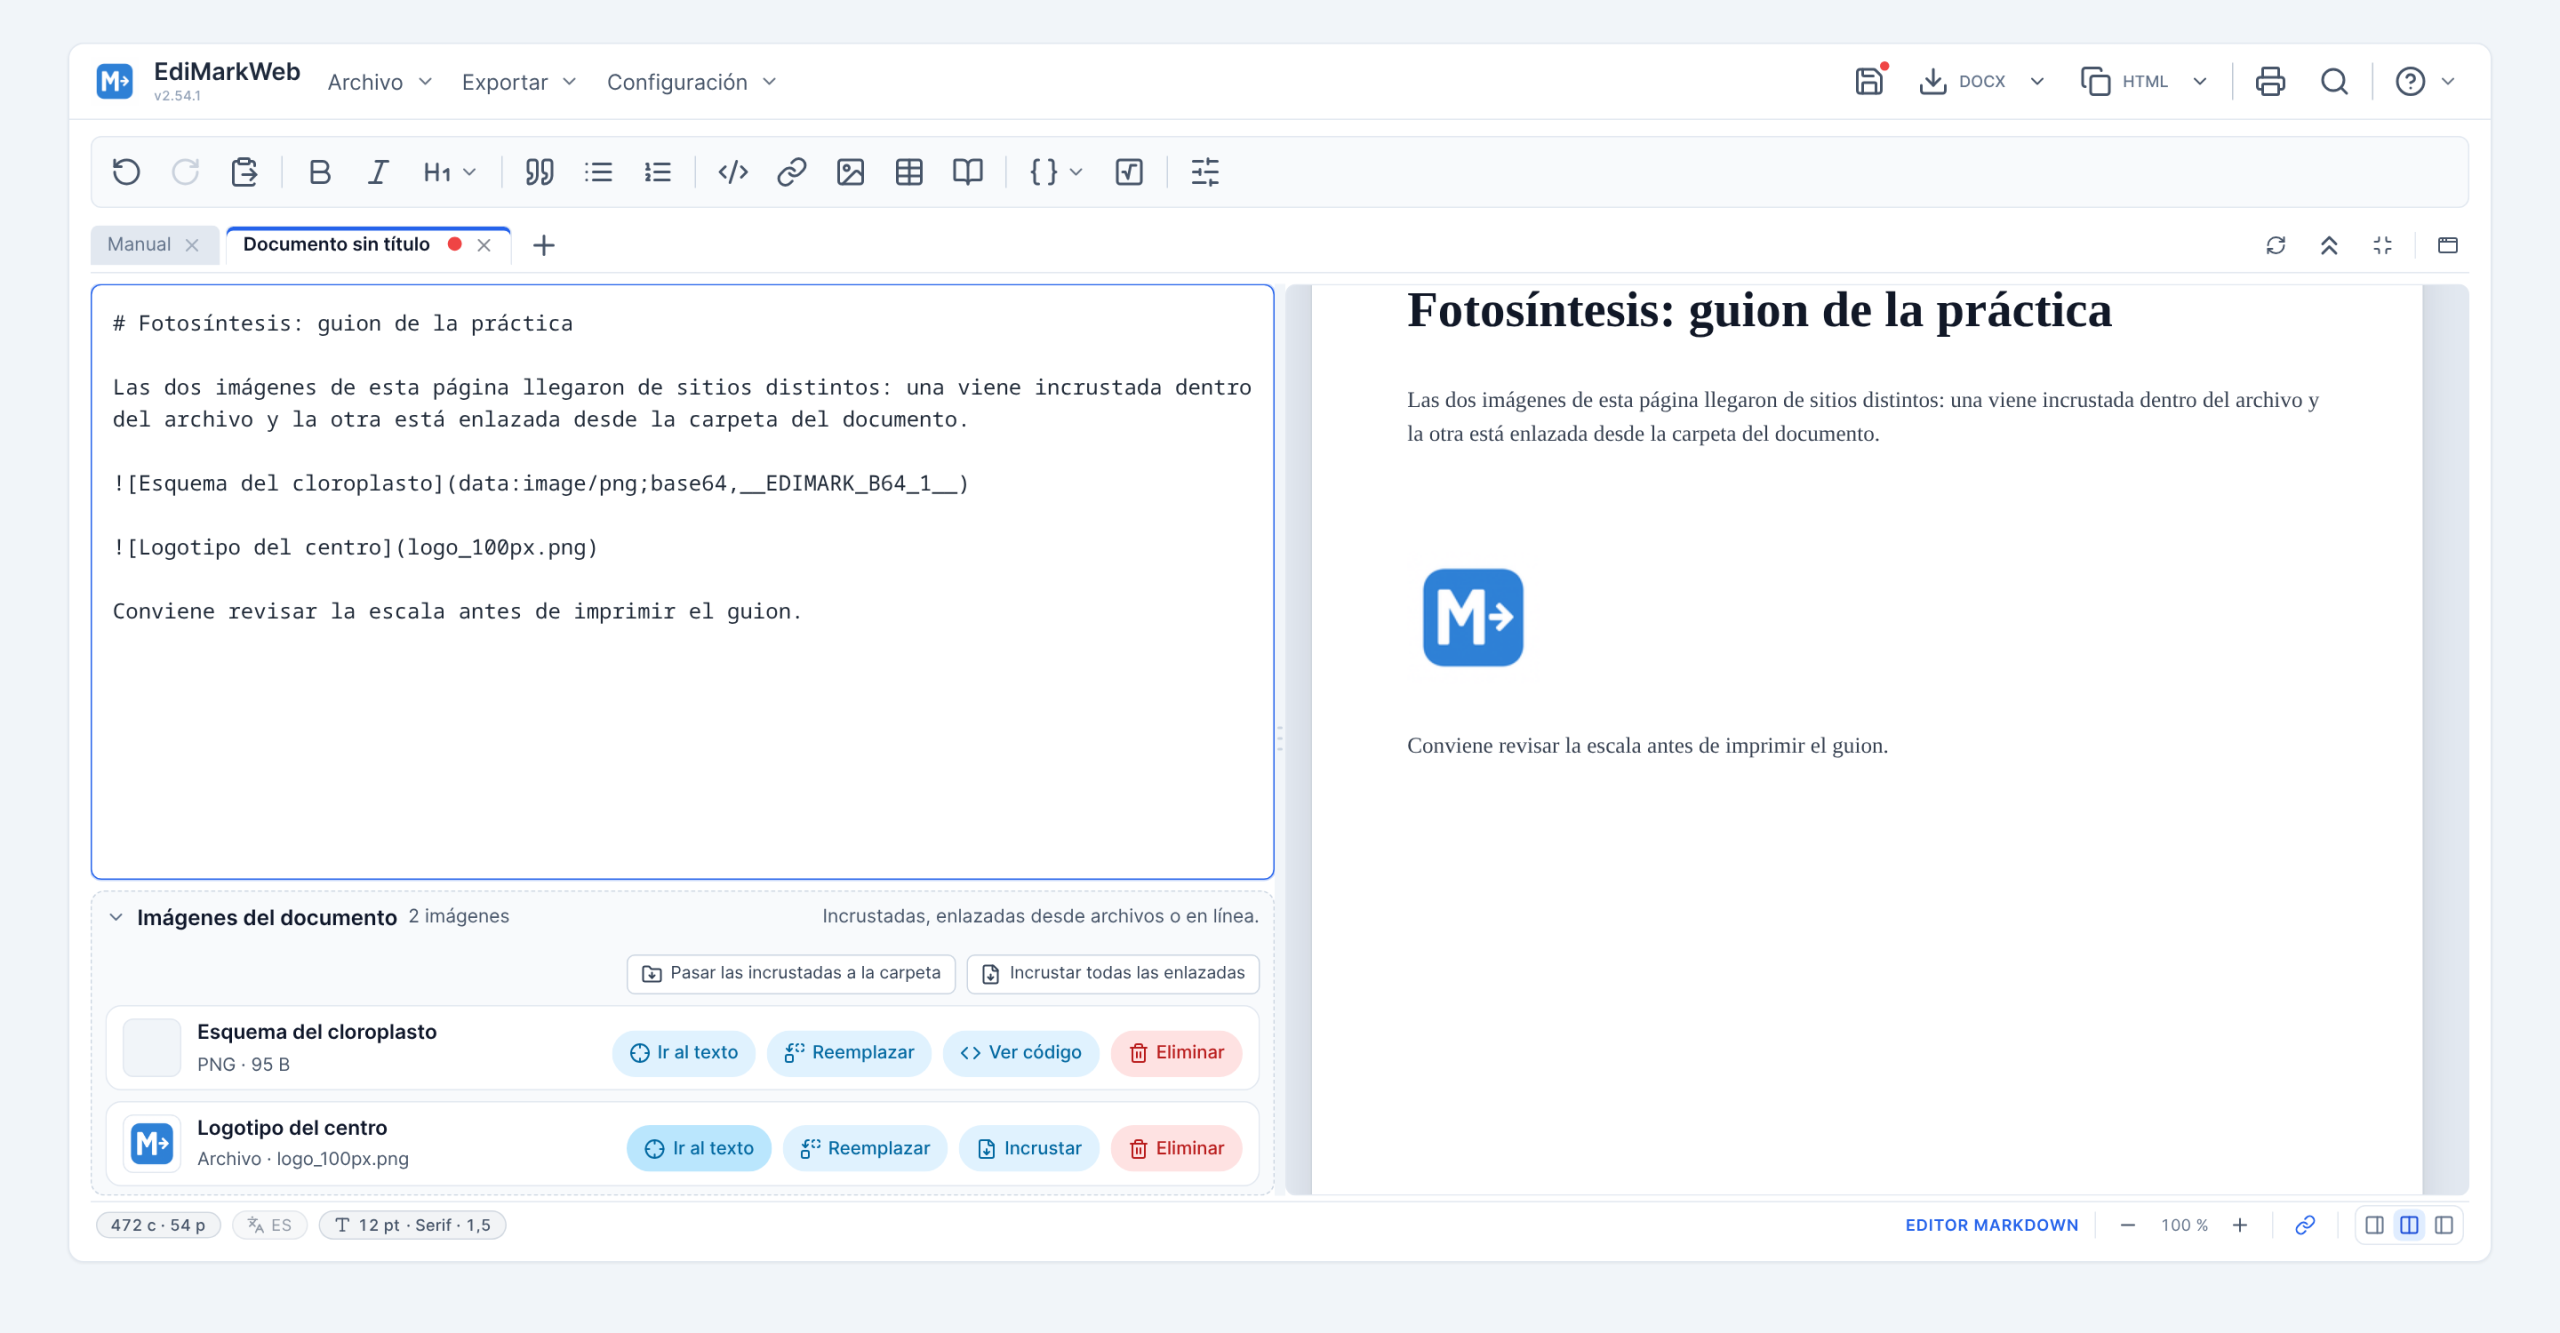
Bajo el editor Markdown, una lista reúne todas las imágenes del
documento, las incrustadas y las enlazadas. Desde ahí se ven, se
reemplazan (por una del disco, del portapapeles o de una dirección web)
y se quitan del texto. Cada una lleva además Ir al
texto, que lleva el cursor hasta donde está escrita y la deja
seleccionada: es la manera de saber a qué párrafo pertenece una imagen
de la lista sin buscarla a mano.
Las dos conversiones —de enlazada a incrustada y al revés— se hacen
sobre una imagen concreta o sobre todas a la vez, con los dos botones
que hay sobre la lista. Cada uno aparece solo mientras quede algo que
convertir en su sentido, así que un documento cuyas imágenes sean todas
de la misma clase enseña uno, o ninguno. Es lo que permite dejar un
.md autónomo para enviarlo por correo, o al contrario,
aligerarlo sacando sus imágenes a la carpeta.
La primera imagen viene incrustada dentro del archivo y la
segunda está enlazada desde la carpeta, de modo que las dos conversiones
tienen algo que hacer y los dos botones generales están a la vista. En
un panel estrecho cada botón se queda en su icono, con su descripción al
pasar el ratón.
En la aplicación de escritorio las imágenes con ruta relativa se
encuentran solas. En el navegador no, porque ninguna página puede leer
una carpeta sin permiso: aparece un aviso con un botón para señalarla y,
hecho una vez, se ven todas.
Lo que queda guardado
Cerrar el programa no pierde el trabajo: los documentos abiertos se
guardan solos y vuelven al arrancar. Eso tiene un coste en espacio que
hasta ahora no se veía, y que se nota sobre todo al importar PDF, porque
un informe largo llega con decenas de imágenes.
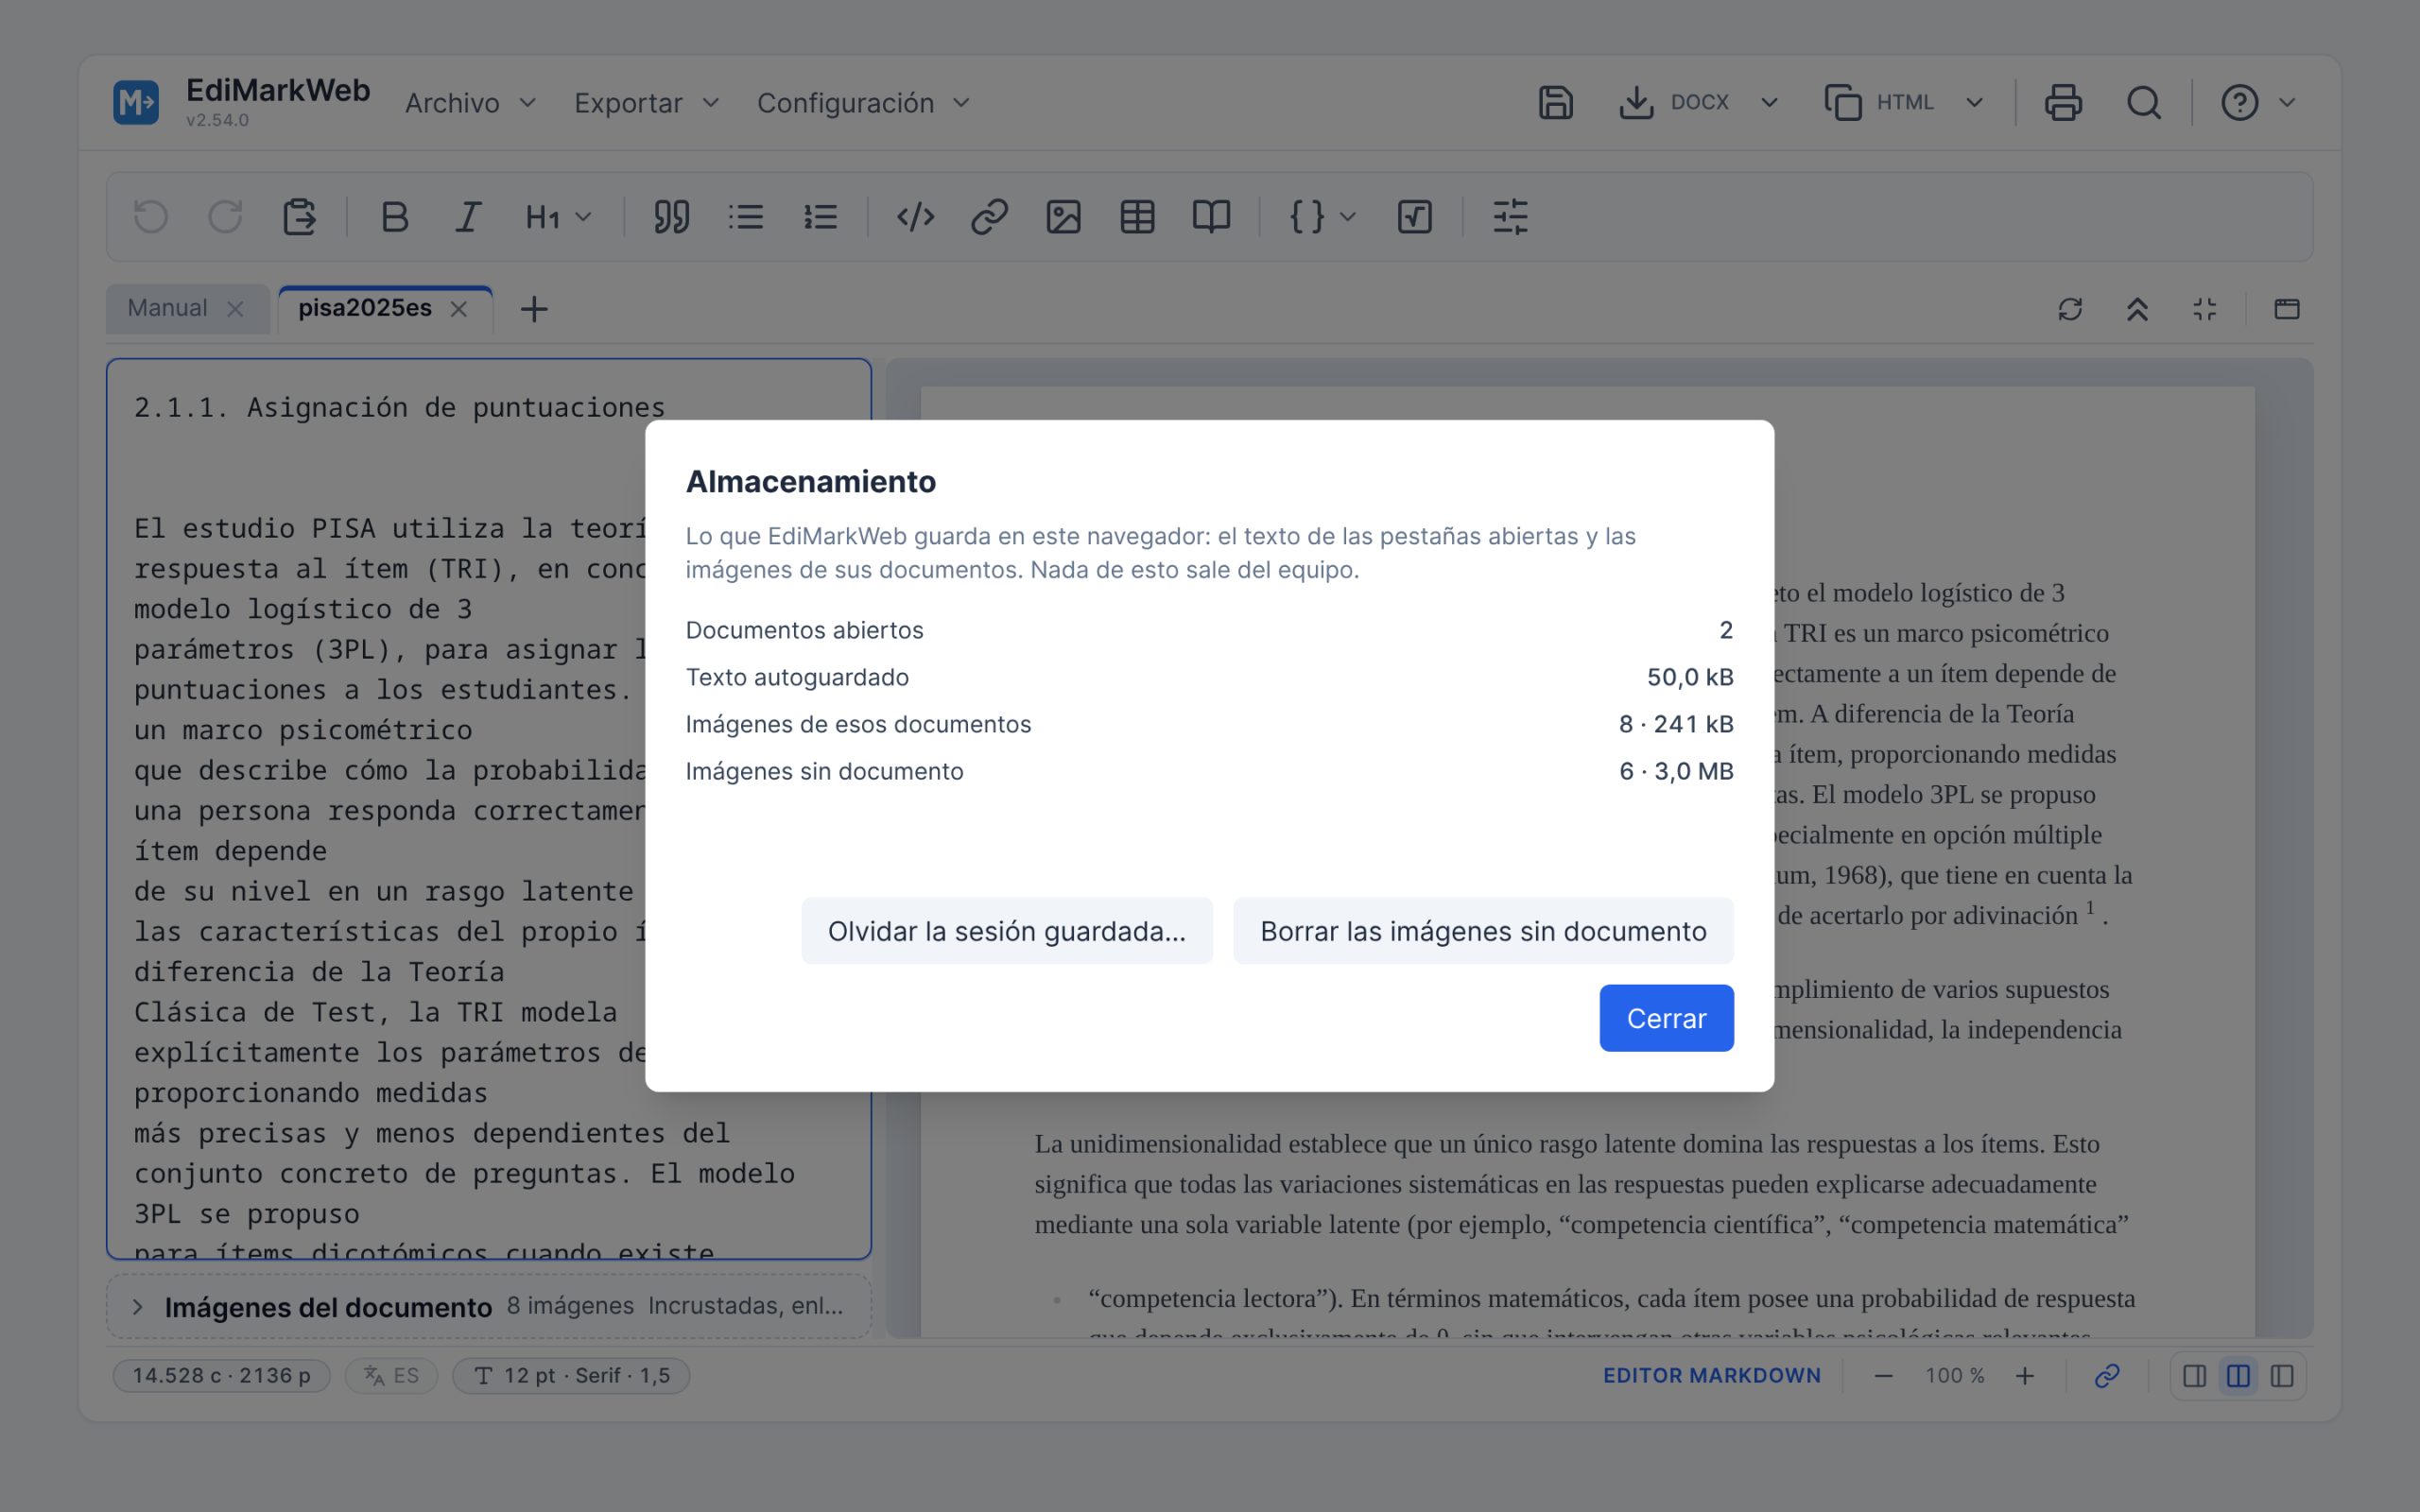
En Configuración → Almacenamiento… se ve cuánto
ocupa cada cosa: los documentos abiertos, su texto y sus imágenes.
Aparte se cuentan las imágenes que ya no pertenecen a ningún documento,
que son las que dejan las pestañas cerradas hace tiempo y las sesiones
anteriores. Se borran solas al abrir el programa, y desde ahí se pueden
borrar en el momento. Todo esto vive en el navegador o en la aplicación,
no en un servidor.
Las cifras de la imagen son las de un informe recién importado,
más lo que había quedado de una sesión anterior. El segundo botón
descarta la sesión guardada, y ninguno de los dos toca los archivos del
disco.
En el navegador o instalado
La versión web no necesita instalación y basta para la mayoría de los
casos. La aplicación de escritorio, para Linux, Windows y macOS, es la
misma (los mismos menús, los mismos atajos, los mismos formatos) y añade
lo que solo puede hacer un programa instalado: abrir los archivos
.md con doble clic, guardar sobre el documento original sin
pasar por la carpeta de descargas, usar el corrector ortográfico del
sistema y funcionar sin conexión, porque lleva dentro
las herramientas de conversión. También avisa cuando hay una versión
nueva y la instala, y vuelve a leer del disco el documento abierto
cuando se ha modificado fuera del programa.
En macOS conviene saber que la aplicación no está firmada con una
cuenta de desarrollador de Apple, que es de pago, así que al abrirla por
primera vez el sistema avisa de que «está dañada y debería moverse a la
papelera». No lo está: es lo que macOS dice de cualquier aplicación sin
firmar descargada de internet. Se resuelve una sola vez arrastrando
EdiMarkdown a la carpeta Aplicaciones y ejecutando en el
Terminal
xattr -dr com.apple.quarantine /Applications/EdiMarkdown.app,
que retira la marca de «descargado de internet» de esa aplicación y no
cambia ningún ajuste del sistema.
En el navegador, con todo, guardar ha dejado de ser una descarga:
Chrome y Edge abren el diálogo del sistema para elegir el nombre y la
carpeta, y recuerdan el archivo, así que la siguiente vez
Ctrl+S escribe encima como en la aplicación de escritorio.
Firefox todavía no admite esa forma de guardar y sigue descargando el
archivo.
Conviene tener presentes algunas limitaciones antes de emplearlo en
un trabajo extenso. El índice de un DOCX o un ODT es un campo que
calcula el procesador de textos, así que el documento se abre con la
lista de apartados pero sin números de página hasta que se actualiza (en
Word, botón derecho sobre el índice y Actualizar campos). En el
EPUB los márgenes son una sugerencia, porque manda el lector de libros.
La partición de palabras necesita los diccionarios de guiones del
sistema. Y el reparto en páginas que se ve en pantalla es exacto para el
PDF y la impresión, pero solo orientativo para Word y para LaTeX, que
componen las líneas a su manera.
La importación de PDF tiene las suyas, propias de un formato pensado
para imprimirse y no para editarse: la detección de tablas, columnas y
fórmulas no es infalible y puede dividir celdas o alterar el orden del
texto, las fórmulas reconocidas se guardan como imágenes y no como
ecuaciones editables, una nota al pie solo se enlaza cuando su llamada y
su texto están en la misma página, y el reconocimiento de un documento
escaneado sufre con las fotografías, las marcas de agua y la resolución
baja. Conviene revisar el resultado, que para eso el cuadro lo muestra
antes de importarlo. En la aplicación de escritorio para Linux, además,
los documentos de más de doscientas páginas se convierten con lentitud;
la versión web no tiene ese problema en ningún sistema.
Para qué sirve en la
práctica
El destinatario natural es el profesorado que prepara materiales con
fórmulas y los tiene que entregar en formatos distintos: los apuntes en
PDF, el examen en Word para el departamento (o en Google Docs, que abre
ese mismo archivo), la misma unidad convertida en página web para el
aula virtual y, si se quiere, en libro digital para leerlo en una
tableta. Todo eso sale de un único archivo de texto que se puede
corregir el curso que viene sin volver a maquetar nada. Con la
bibliografía se añade un trabajo que hasta ahora se hacía en otra parte:
la memoria, el artículo o el trabajo de fin de grado, con sus citas y su
lista de referencias en la norma que se exija.
Sirve también para lo contrario: recuperar el material que ya existe.
Un documento de Word de hace años, o un PDF del que no se conserva el
original, se abre aquí, se convierte en texto limpio y vuelve a salir
por el formato que se necesite. Y, sobre todo, para conservar lo que ha
respondido la inteligencia artificial, en un archivo propio y en un
formato que se pueda entregar.
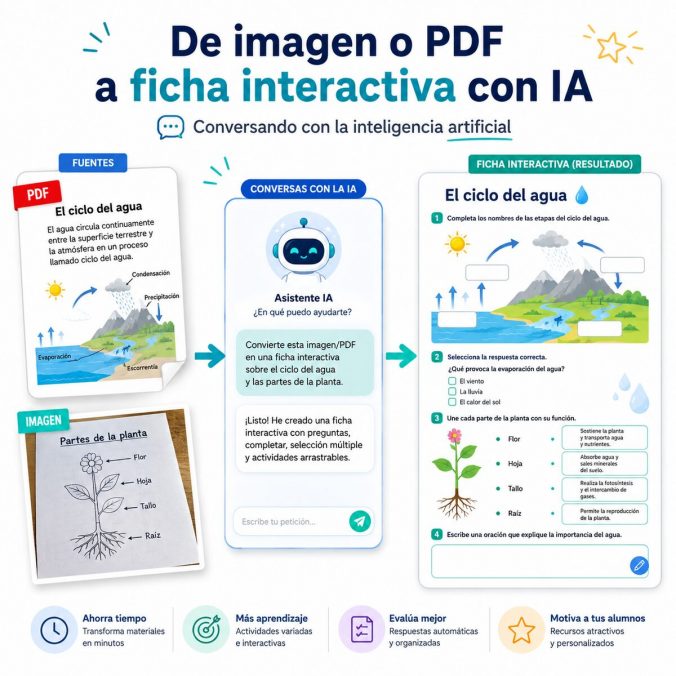
Hacer una ficha interactiva a partir de un PDF tiene dos partes. Una
es decidir qué se pregunta. La otra es colocar los campos: abrir el
documento, dibujar una caja encima de cada línea de puntos, ajustar el
tamaño, escribir la solución, repetirlo veinte veces y descubrir al
final que un campo tapa el enunciado siguiente.
Desde la versión 1.29, OpenWorksheets puede hacer
ese trabajo por nosotros. No con un botón dentro de la aplicación, sino
desde la conversación con la inteligencia artificial que ya usemos: se
le dice dónde está el PDF y ella lo abre, lee la página, coloca los
campos donde tocan, mira cómo ha quedado y guarda la
ficha lista para abrir en el editor. Y no solo convertir: si no partimos de ningún documento, podemos pedirle la ficha entera sobre un tema, y la escribe sobre hojas en blanco.
«Convierte en ficha interactiva de OpenWorksheets este PDF:
energia.pdf»
Este artículo explica qué es lo que hace posible eso (un servidor
MCP), qué se le puede pedir, qué hace falta para instalarlo y, sobre
todo, dónde están sus límites, que los tiene.
Pódcast del artículo realizado por Gemini Notebook
Qué es un servidor MCP
Una IA de las de conversar sabe redactar preguntas, pero no puede
abrir un archivo de nuestro disco ni escribir uno. Vive dentro de su
ventana de chat. El MCP (Model Context
Protocol, «protocolo de contexto del modelo») es el estándar que le
da manos: un programa pequeño que se instala en el ordenador y le ofrece
a la IA una lista de operaciones concretas que puede ejecutar.
El servidor MCP de OpenWorksheets ofrece las operaciones propias para
fabricar una ficha: abrir un PDF, leer el texto de una página
con las coordenadas de cada línea, colocar campos de
respuesta, tapar una zona, ver el resultado y guardar el paquete
.owpkg. La IA decide qué preguntar y dónde ponerlo; el
servidor hace el trabajo material y le dice cuándo se está
equivocando.
Que sea un programa local tiene una consecuencia práctica: el
archivo no se sube a ningún servicio. El PDF se abre en nuestro
ordenador, las páginas se dibujan ahí y la ficha se guarda ahí, sin
pasar por ninguna web de conversión.
Conviene no confundir eso con privacidad total, porque no lo es. La
IA con la que hablamos sí ve el contenido: para colocar
los campos necesita el texto de las páginas, y para comprobar el
resultado necesita mirar la imagen de la ficha. Ambas cosas viajan a los
servidores de quien preste el servicio (Anthropic, OpenAI, Google,
etc.), igual que si pegásemos el documento en el chat. Con datos
personales del alumnado, o con material que no deba salir del centro,
hay que tenerlo presente. La única forma de que no salga nada es usar un
modelo que corra en el propio ordenador, con LM Studio, aunque de
momento lo usa muy poca gente, sobre todo porque necesita de un
ordenador muy potente para poder funcionar de forma fluida.
Formas de hacer una ficha
Sobre un documento propio. Es el caso para el que
nació. Partimos de un PDF o de una imagen (un examen antiguo, una ficha
fotocopiada, un esquema) y los campos se colocan encima, cada uno en su
sitio, respetando el diseño original. El alumnado ve el documento de
siempre, pero relleno de huecos que podrá completar y que se corrigen
solos.
Desde cero, sobre hojas en blanco. Le decimos el tema, el nivel y cuántos ejercicios, y la ficha se escribe entera: enunciado, campo de respuesta, separación y salto de página cuando hace falta. Es lo mismo que ya permitía la opción Crear una ficha con IA de la aplicación, la de copiar un prompt y pegar la respuesta, pero sin copiar ni pegar nada y con una diferencia importante: el servidor valida el formato sobre la marcha, así que si algo viene mal, la IA se entera al momento y lo corrige, en lugar de entregarnos un archivo que no abre.
Las dos formas se mezclan: se puede partir de un PDF y añadir al
final tres preguntas nuevas sobre hoja en blanco.
La vista previa es lo que lo hace fiable
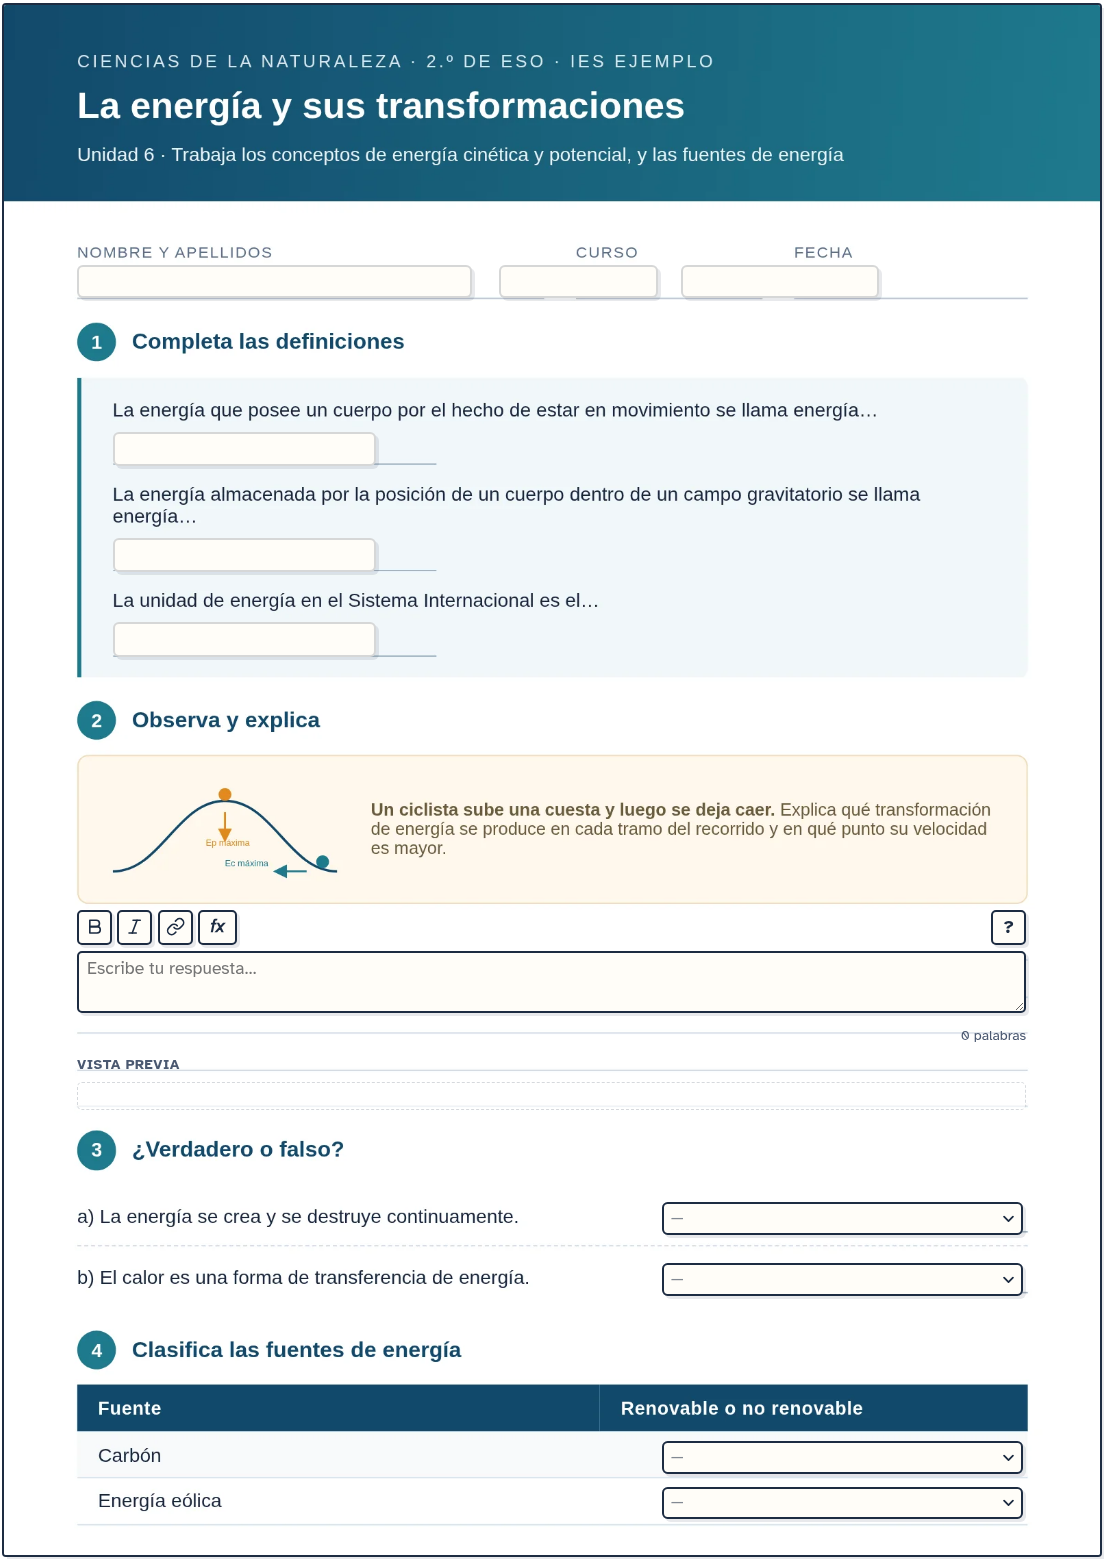
Una IA colocando cajas sobre una página, a ciegas, se puede equivocar. Si pone el campo dos centímetros por debajo de donde iba, tapa media palabra del enunciado, deja a la vista la solución impresa en el margen. Por eso el paso importante no es colocar, sino comprobar: el servidor monta la página con el mismo visor que verá el alumnado y le devuelve a la IA una captura de cómo ha quedado, con el contorno y el número de cada campo dibujados encima. Con esa imagen delante, la IA corrige lo que esté desplazado antes de guardar nada.
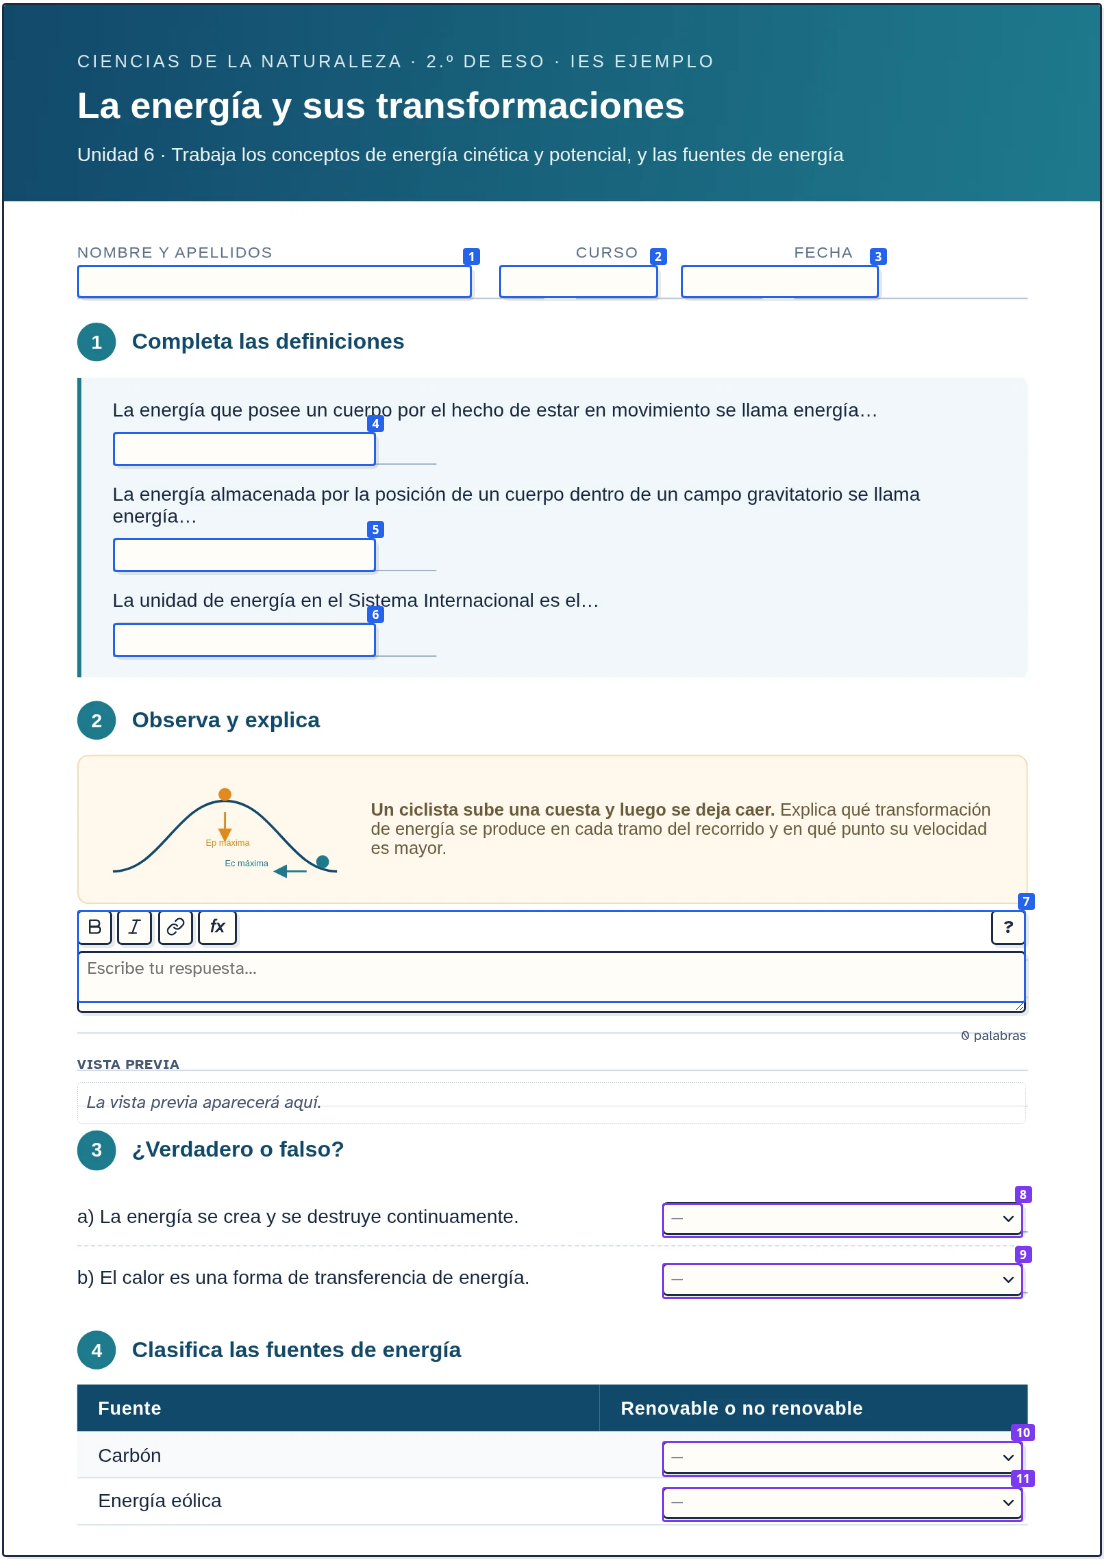
Lo que ve la IA después de colocar los campos: la ficha real
montada con el visor del alumnado, con el contorno y el número de cada
campo añadidos encima. Esta ficha se ha hecho para el artículo con el
propio servidor, a partir de un PDF de una hoja.
Qué se le puede pedir
Todo en lenguaje normal, en la conversación, sin tocar la
aplicación:
«Convierte en ficha interactiva de OpenWorksheets este
PDF»
«Crea una ficha interactiva de OpenWorksheets con 10 ejercicios
y nivel de 1.º de ESO sobre la célula»
«El ejercicio 5 prefiero que lo cambies por una pregunta de
respuesta múltiple, en lugar de verdadero o falso»
«Tapa las soluciones que están impresas al pie de la
página»
«Enséñame la página 3 antes de guardar»
Los tipos de campo que sabe colocar son casi todos: respuesta corta,
numérica, fórmula, respuesta larga, opción única y múltiple,
desplegable, verdadero/falso, huecos en el texto, huecos dibujados sobre
el documento, casillas, tabla editable, emparejar, ordenar, arrastrar a
zonas y grabación de voz.
Qué hace falta
1. Una IA instalada en el ordenador. Esto no se puede hacer desde la web de ChatGPT, de Claude ni de Gemini: el navegador no puede instalar ni ejecutar nada en nuestro equipo. Hacen falta las aplicaciones de escritorio o herramientas de terminal como Claude Code o Codex CLI. Y en las aplicaciones de escritorio de ChatGPT y de Claude no vale el chat de siempre: hay que pedírselo desde su pestaña de código (Codex en ChatGPT, Claude Code en Claude), que es la parte que puede trabajar con archivos y programas. También sirven LM Studio, Antigravity, Cursor y VS Code.
2. Node.js 18 o superior y un navegador basado en
Chromium (Chrome, Chromium o Edge). Node es lo que ejecuta el
servidor; el navegador, que trabaja sin abrirse ni verse, es lo que
dibuja las páginas del PDF y monta la vista previa. Es probable que ya
estén instalados; si falta alguno, la propia IA puede
encargarse de instalarlo o guiarnos en el proceso.
3. El servidor, instalado una sola vez. Hay que
destacar que no lo instalamos nosotros, lo instala la
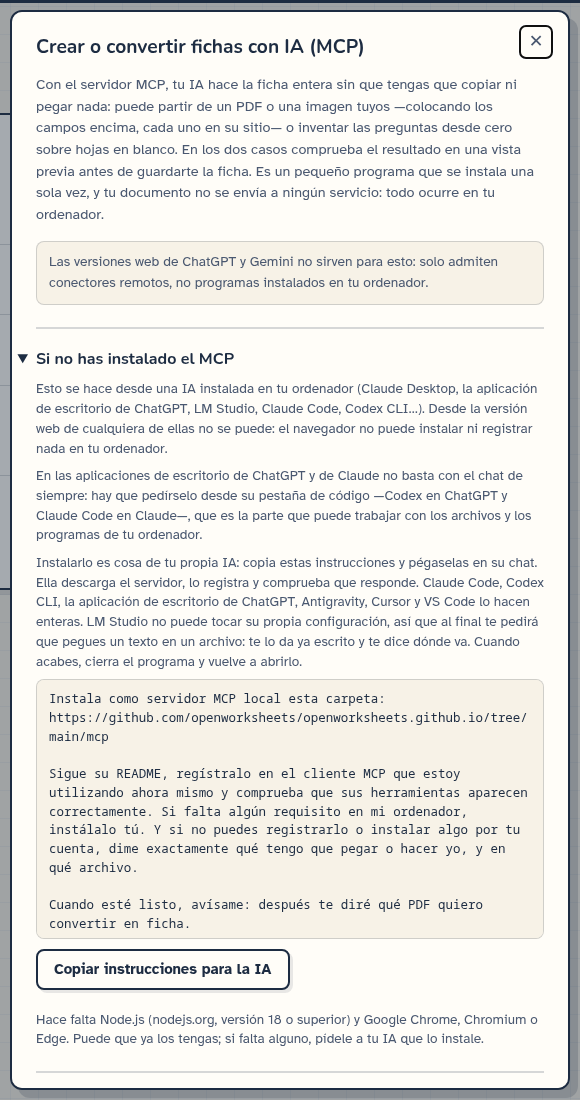
IA. En el editor de OpenWorksheets, en Archivo → Crear o
convertir fichas con IA (MCP), hay un prompt para copiar y pegarle
en su chat. Ella descarga la carpeta, la registra en su propia
configuración y comprueba que responde. Claude Code, Codex CLI, la
aplicación de escritorio de ChatGPT, Antigravity, Cursor y VS Code lo
pueden hacer; LM Studio no puede tocar su configuración, así que al
final nos dará escrito el texto que hay que pegar y nos dirá en qué
archivo va. Aunque si tenemos alguna de las IA anteriores, le podemos
decir que nos lo instale en LM Studio.
El diálogo del editor con las instrucciones que se le pegan a la
IA para que instale el servidor.
Para actualizarlo, hacemos lo mismo, escribimos en el chat: «Actualiza el servidor MCP de OpenWorksheets a la última versión y dime en cuál se ha quedado».
Límites que conviene conocer antes de empezar
Un PDF escaneado da mucho más trabajo. Si la página
es una fotografía, sin capa de texto, no hay coordenadas que leer y la
IA tiene que colocar los campos mirando la imagen y afinando por
aproximación. Sale, pero cuesta varias vueltas. Con un PDF generado
desde un procesador de textos, en cambio, es más sencillo.
Las respuestas las propone la IA. En preguntas
cerradas suele acertar; en las abiertas, y en cualquier cosa que dependa
de un criterio nuestro, hay que revisar la ficha antes de repartirla. La
ficha se abre en el editor como cualquier otra y podremos corregir lo
que haga falta.
No sustituye al editor, lo alimenta. Lo que devuelve
la IA es un .owpkg normal, que se abre en OpenWorksheets,
se retoca, se le puede modificar la puntuación y las opciones de
corrección, y se comparte como siempre.
Para qué sirve esto realmente
El cuello de botella de las fichas interactivas nunca ha sido la
falta de material: el profesorado tiene carpetas llenas de PDF buenos.
El cuello de botella es el rato de trabajo mecánico que separa ese PDF
del material interactivo, y que hace que muchos no lleguen a dar el
paso. Eso es exactamente lo que esto quita de en medio.
Con la ventaja de que no cambia el resto: la ficha resultante es una ficha de OpenWorksheets como cualquier otra, sin cuentas, sin servidores, sin depender de ninguna plataforma.
La misma ficha sin las marcas de trabajo: así la abre el
alumnado. El documento original se conserva intacto; los campos se
corrigen solos.
Cualquier persona que trabaje con documentación acumula un fondo de
textos que consulta una y otra vez: normativa, actas, memorias, apuntes,
artículos. Preguntarle a una inteligencia artificial sobre ese material
choca siempre con el mismo muro: hay que subirlo a algún sitio, o
pegarlo en la conversación, o confiar en que el modelo lo recuerde de su
entrenamiento, cosa que no ocurre.
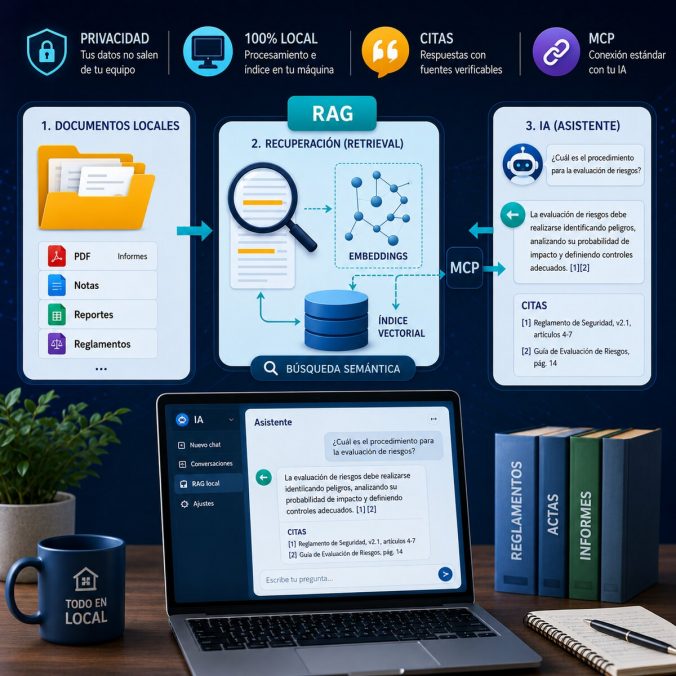
Este artículo explica qué es un RAG (Retrieval Augmented
Generation, en español «generación aumentada por recuperación»),
qué es el protocolo MCP (Model Context Protocol, en español
«protocolo de contexto del modelo») que hace posible esa conexión, cómo
funciona el conjunto y cómo montarlo sin escribir una línea de
código.
Si solo quieres las instrucciones, ve directamente a la guía rápida del final: reúne las tres
que hacen falta, listas para copiar y pegar. El resto del artículo
explica qué hace cada una y por qué, que es lo que permite juzgar si el
resultado es bueno.
El código está publicado: el sistema completo que se
describe aquí, con un fondo documental de ejemplo ya indexado, está en
github.com/jjdeharo/cuadernos-rag,
con licencia libre. Quien prefiera verlo antes de leer nada más, puede
empezar por ahí.
Pódcast del artículo realizado por Gemini Notebook
Qué es un RAG
Un buscador colocado delante de una inteligencia artificial.
Un modelo de lenguaje, que es el programa que hay detrás de ChatGPT,
Claude o Gemini, no puede leer mil páginas cada vez que recibe una
pregunta porque no caben en una consulta y, aunque lo hiciese,
resultaría lento y costoso. Lo que hace un RAG es localizar primero los
pocos fragmentos que hacen falta para responder a esa pregunta concreta,
y entregar solo eso. El modelo no aprende los documentos ni los
memoriza: los consulta, como haría cualquiera con un libro delante, e
indica de dónde ha salido cada afirmación.
La consecuencia práctica es doble. Por un lado, deja de haber límite
de volumen: da igual que el fondo documental sean quinientas páginas o
veinte mil, porque en cada consulta solo viajan unos pocos fragmentos.
Por otro, y más importante, cada respuesta puede citar su fuente. En
materia normativa o técnica, una respuesta sin fuente no tiene ningún
valor.
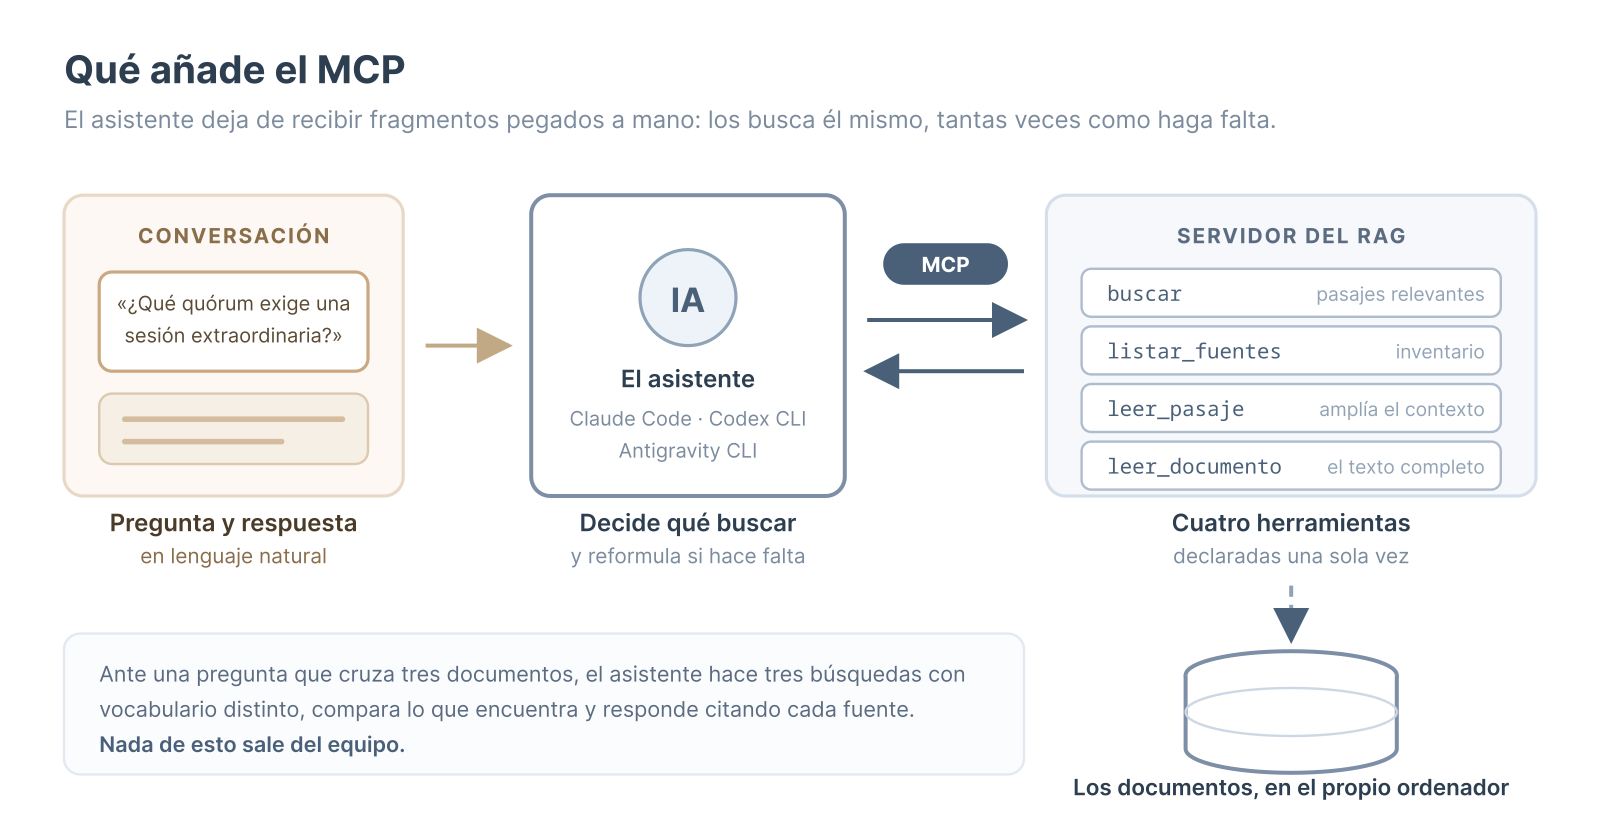
Qué es el MCP
El servidor declara sus herramientas una vez y cualquier
asistente compatible puede usarlas.
Un RAG, por sí solo, es una herramienta de línea de comandos: se le
hace una pregunta y devuelve fragmentos. Útil, pero incómodo.
MCP son las siglas de Model Context Protocol, un estándar
abierto propuesto por Anthropic a finales de 2024 y adoptado después por
los demás asistentes. Resuelve un problema muy concreto: cómo permitir
que una IA use herramientas externas sin que haya que programar una
integración distinta para cada combinación de herramienta y asistente.
Con MCP, quien construye la herramienta la describe una sola vez, y
cualquier asistente compatible sabe cómo usarla.
Aplicado a un RAG, el cambio es importante, ya que en lugar de
ejecutar búsquedas a mano y pegar los resultados en una conversación, el
asistente busca por su cuenta, tantas veces como necesite. Ante una
pregunta que cruza tres documentos distintos, hace tres búsquedas con
vocabulario distinto, compara lo que encuentra y responde citando cada
fuente. El fondo documental deja de ser un archivo aparte y pasa a estar
dentro de la conversación.
Un servidor MCP no es más que un programa que declara qué sabe hacer.
En el caso de un RAG documental, cuatro operaciones bastan: buscar
pasajes, listar los documentos disponibles, ampliar el contexto de un
pasaje concreto y recorrer un documento entero. El asistente decide
cuándo usar cada una.
Conviene añadir una instrucción que gobierne su uso, porque sin ella
el asistente tenderá a responder de memoria. Basta con una regla
explícita: no afirmar nada que no proceda de una búsqueda, buscar varias
veces reformulando con el vocabulario propio de cada fuente, citar
siempre el identificador del pasaje, y decir con claridad cuándo el
fondo documental no cubre la pregunta.
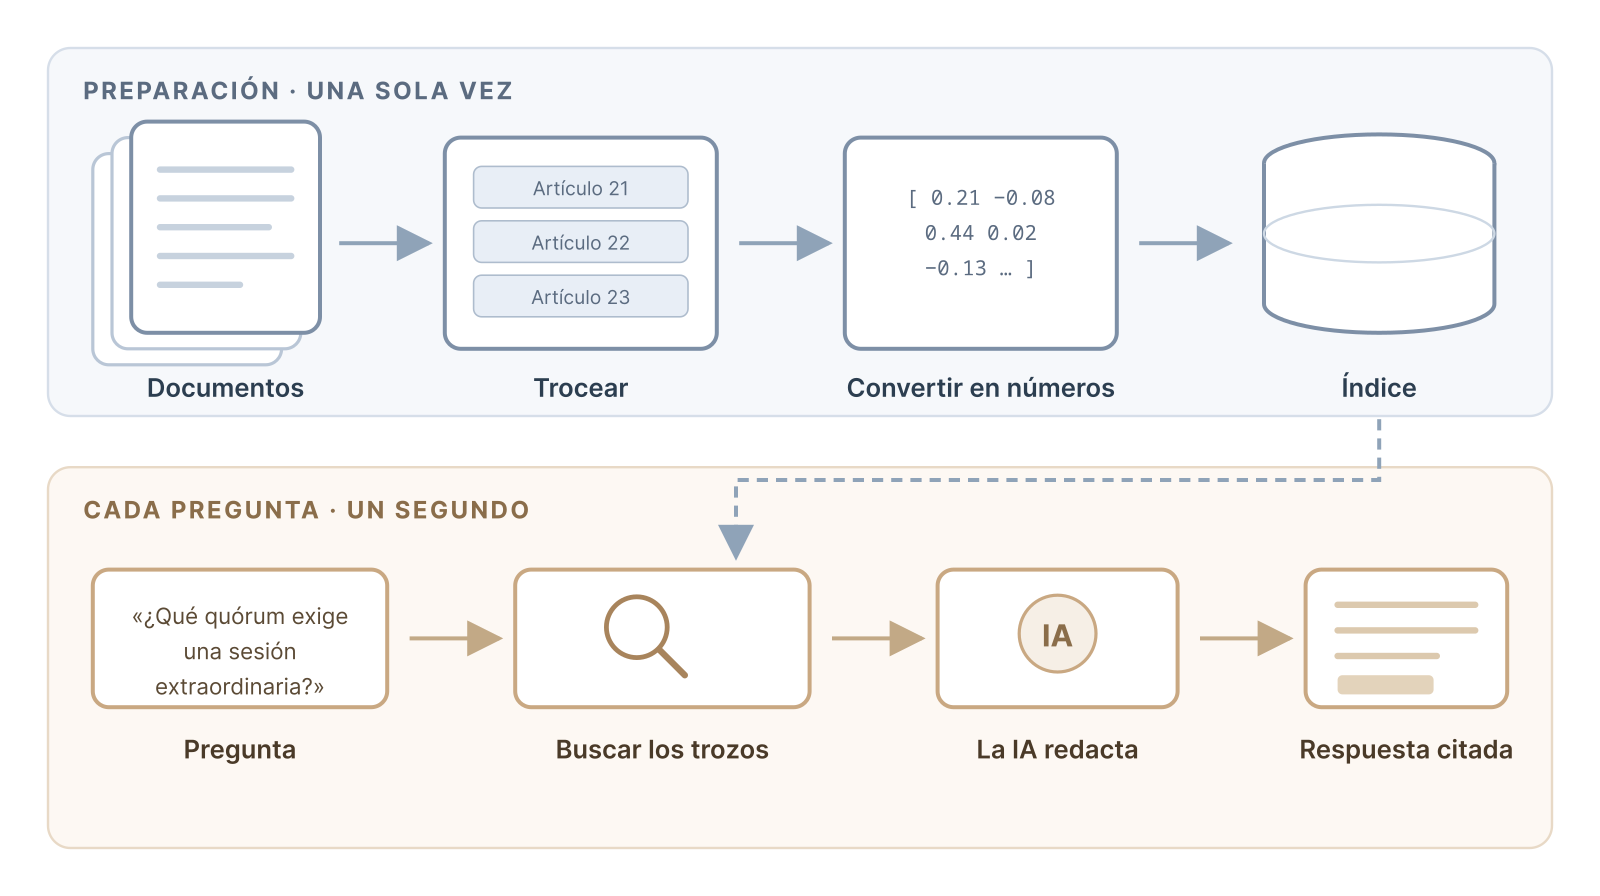
Cómo funciona por dentro
Arriba, la preparación: se hace una vez. Abajo, lo que ocurre en
cada pregunta: dura un segundo.
Son cuatro piezas, y solo la última tiene que ver con la inteligencia
artificial tal y como la entiende la mayoría.
Convertir a texto. PDF, páginas web, documentos de
Word, audio transcrito: todo tiene que acabar siendo texto plano. Un PDF
no guarda un texto, guarda dónde va cada letra en la página; al leerlo
hay que reconstruir el orden, y en tablas o en textos a dos columnas se
falla a menudo. Es la pieza menos vistosa y la que estropea el resultado
con más frecuencia.
Trocear. Consiste en partir cada documento en
fragmentos manejables y, aunque parezca un detalle de poca importancia,
es lo que más determina la calidad final. Un troceado rudimentario corta
cada mil palabras sin atender a dónde cae el corte, mientras que uno
cuidadoso respeta la estructura del texto: en una norma, por ejemplo, un
fragmento por artículo. La diferencia se aprecia en cuanto se formula
una consulta concreta, porque en el primer caso llega un trozo que
empieza a mitad de un artículo y se interrumpe antes de acabar el
siguiente, mientras que en el segundo llega el artículo completo, con su
título.
Convertir cada fragmento en números. De esto no se
encarga un asistente de los que conversan, sino un programa mucho más
pequeño, entrenado para una sola tarea: no redacta ni responde nada,
solo lee un texto y devuelve números. A cada fragmento le asigna una
lista de más de mil números que funciona como unas coordenadas: igual
que una latitud y una longitud sitúan un lugar en un mapa, esos números
sitúan el fragmento en un espacio donde la posición depende del
significado. Los textos que hablan de lo mismo quedan cerca unos de
otros, aunque estén escritos con palabras distintas; los que hablan de
cosas diferentes quedan lejos.
A partir de ahí, buscar deja de ser comparar palabras y pasa a ser
medir distancias. La pregunta se convierte también en un punto de ese
mapa, y el sistema devuelve los fragmentos que han quedado más cerca.
Por eso una consulta como «¿cuánta gente hace falta para que la reunión
sea válida?» encuentra un párrafo que habla del «quorum de
constitución», sin que compartan una sola palabra.
Buscar y citar. La búsqueda por significado es muy
eficaz y tiene un punto ciego: los nombres propios y las referencias
exactas. Ante una consulta por un artículo numerado o por unas siglas,
falla, porque esas expresiones no significan nada, solo nombran. Por eso
se hacen dos búsquedas a la vez (la de significado y la literal, por
palabras) y se combinan los resultados. Después, un segundo modelo igual
de mudo, llamado reranker, relee los mejores candidatos junto a
la pregunta y los reordena. De ahí salen los fragmentos que se entregan
al asistente, cada uno con su procedencia.
Todo esto ocurre en el propio ordenador, y conviene distinguir las
tres piezas que intervienen, porque en la jerga a las tres se las llama
«modelos» y no son lo mismo:
El conversor a números, o modelo de
embeddings, que traduce cada fragmento a su lista de coordenadas.
Ocupa unos dos gigabytes.
El reordenador, o reranker, que afina la
lista de candidatos que ha devuelto la búsqueda. Ocupa algo más de
uno.
El asistente, Claude, ChatGPT, Gemini, que es el
que redacta la respuesta final.
Los dos primeros viven en el disco, se descargan una vez y funcionan
sin conexión y sin coste. Mientras se consulta, además, se cargan en memoria: conviene tener unos cuatro gigabytes de RAM libres, aparte de los tres y medio que ocupan en el disco. Es un gasto que solo dura lo que dura la consulta, porque un sistema bien montado los suelta cuando pasan unos minutos sin preguntas. No conversan ni generan texto: entra un texto
y sale un resultado numérico. Solo el tercero es lo que la mayoría llama
«una IA», y no ve el fondo documental entero, sino los pocos fragmentos
que la búsqueda le pone delante. Ningún documento sale del equipo.
Cómo montarlo sin saber
programar
Hacen falta dos cosas: los documentos y un asistente que trabaje
dentro del ordenador, con permiso para escribir programas y ejecutarlos.
Hoy hay tres opciones equivalentes, y todas están disponibles tanto en
el terminal como en una aplicación de escritorio, para quien prefiera no
escribir órdenes:
Claude, de Anthropic: la orden claude
en el terminal, o la aplicación de escritorio, que reúne tres modos:
conversación, Claude Code y Cowork.
Codex, de OpenAI: la orden codex en el
terminal, o su aplicación de escritorio, disponible para macOS, Windows
y Linux.
Antigravity, de Google: un entorno de escritorio
propio y la orden agy en el terminal, que desde junio de
2026 sustituye al anterior Gemini CLI.
Cualquiera de ellas sirve, y se instalan en un minuto. Lo único que
importa es que el asistente pueda leer y escribir ficheros en las
carpetas del equipo y ejecutar órdenes en él.
Esas tres son las que montan el sistema, y para eso
conviene un modelo potente. Pero una vez montado, quien lo consulta a
diario puede ser otro, y ahí entra una cuarta posibilidad: un modelo
instalado en el propio ordenador. LM Studio es el
camino sencillo, una aplicación de escritorio para Windows, macOS y
Linux con una tienda de modelos integrada, que además reconoce el
servidor del RAG igual que lo haría cualquier asistente comercial.
llama.cpp es la alternativa para quien no quiera
aplicación gráfica, con algo más de soltura técnica a cambio.
Merece la pena por una razón concreta. Con un asistente comercial, los documentos no salen del equipo, pero los pocos fragmentos que la búsqueda selecciona viajan con cada pregunta. Para normativa pública da igual; para un expediente o unas actas con nombres propios, no. Con un modelo local no sale nada: ni los documentos, ni los fragmentos, ni las preguntas. El precio es real, eso sí: sin una tarjeta gráfica potente, la respuesta tarda decenas de segundos, y los modelos que caben en un ordenador corriente citan con menos rigor. Para material sensible compensa; para material público, el asistente de siempre responde mejor y antes.
Conviene comprobar un detalle en las modalidades que trabajan dentro
de una máquina virtual aislada, como el modo Cowork: si esa máquina es
remota, los documentos salen del ordenador, que es justo lo que se
pretendía evitar. Las versiones que operan directamente sobre las
carpetas locales no plantean ese problema.
A partir de ahí basta con encargar el trabajo. La instrucción que
sigue está escrita para el asistente, no para quien la copia: no hace
falta entender cada línea, porque cada una le pide una decisión técnica
concreta y le impide tomar el atajo de cobrar por el servicio o de subir
el material a algún sitio.
Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.
Esa última petición es la más importante de todas, y conviene no
saltársela: obliga al asistente a enseñar cómo piensa partir los
documentos antes de ponerse a trabajar, que es donde se decide casi
todo. Basta con leer su propuesta y comprobar que respeta la estructura
del material (los artículos de una norma, los puntos del orden del día
de un acta, los capítulos de un informe) en lugar de cortar cada tantas
palabras.
Las tres condiciones finales también merecen explicación. La de las
citas separa una herramienta de consulta de un generador de respuestas
plausibles. La de la memoria evita el descuido más caro de todos: un
servidor que carga los dos modelos nada más arrancar y se queda con tres
gigabytes ocupados aunque nadie pregunte nada, multiplicado por cada
programa que lo tenga conectado. Y la del indexado incremental evita un error frecuente: una
primera versión que rehace el trabajo entero cada vez que se añade o
corrige un documento, con tres cuartos de hora de cálculo en cada
ocasión.
La alternativa a construirlo desde cero es partir de algo que ya
funciona. El código de un sistema así, con todo lo descrito, está
publicado en github.com/jjdeharo/cuadernos-rag
bajo licencia libre. Incluye, a modo de ejemplo, un fondo documental de
quince normas y guías sobre uso ético y legal de la IA en educación (el
RGPD, la LOPDGDD, el reglamento europeo de inteligencia artificial,
guías de la Agencia Española de Protección de Datos, marcos de la
UNESCO), ya indexado y listo para consultar. Ese ejemplo concreto
importa poco: lo aprovechable es la estructura, que sirve igual para
actas municipales, bibliografía académica o documentación técnica de una
empresa.
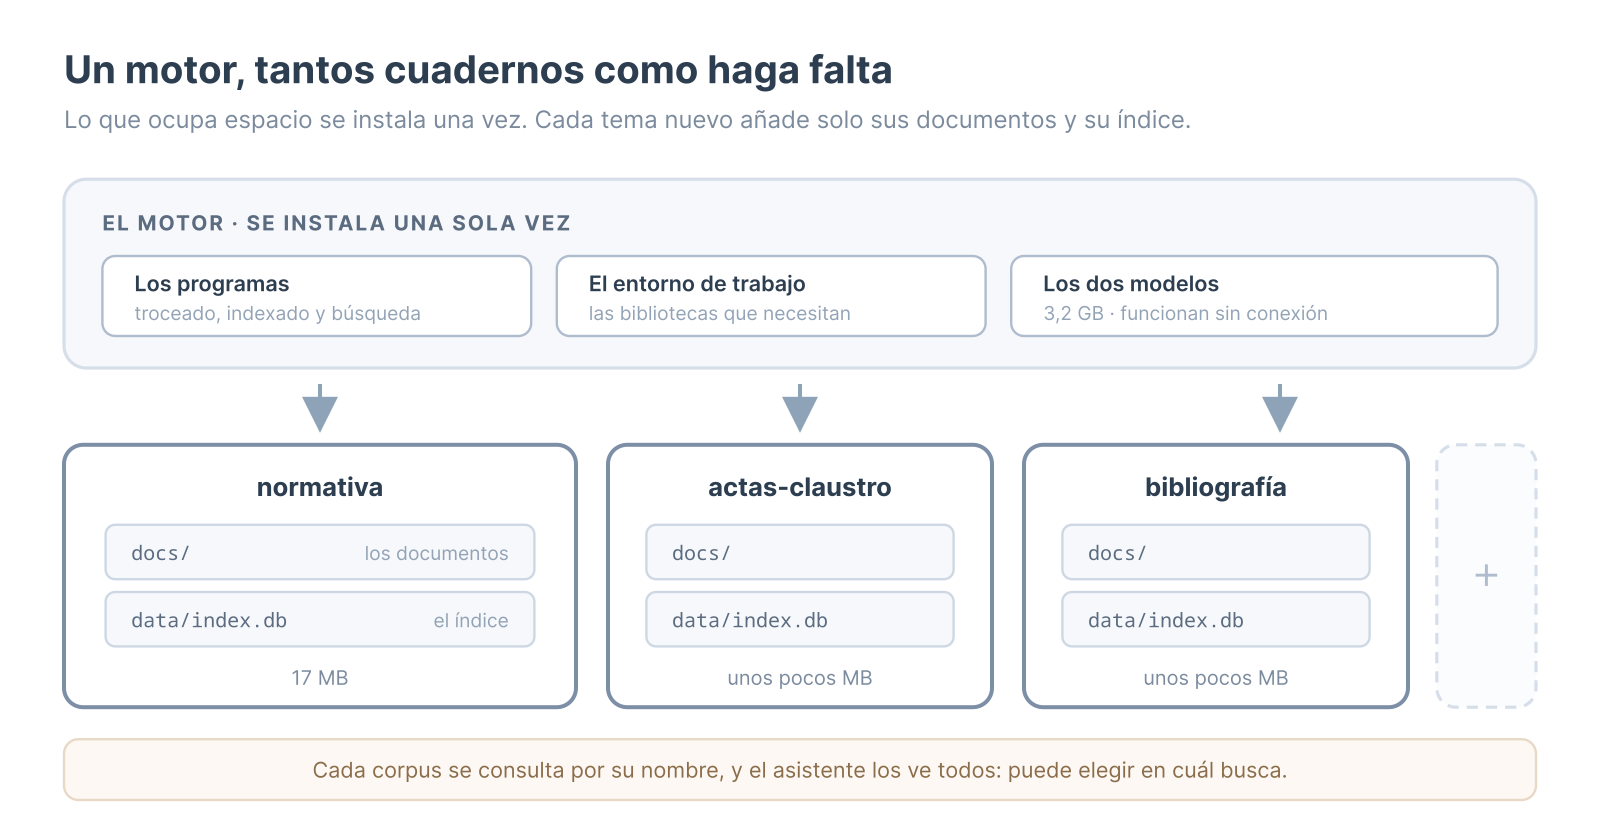
Añadir nuevos cuadernos
El motor y los modelos se instalan una sola vez; cada tema añade
solo sus documentos y su índice.
Esta es la parte que suele quedar sin explicar, y es la que convierte
un experimento en una herramienta de uso diario.
Quien viene de Gemini Notebook está acostumbrado a tener un cuaderno
por tema: uno de normativa, otro de actas, otro con la bibliografía de
un curso. Aquí funciona igual, y con una ventaja: lo que ocupa espacio,
que son los programas y los dos modelos, más de tres gigabytes, se
instala una sola vez y lo comparten todos los cuadernos. Cada tema nuevo
añade únicamente sus documentos y su índice, unos pocos megabytes. No
hay límite de cuadernos ni cuota que agotar.
Crear uno nuevo no exige tocar nada por dentro: basta con pedírselo
al asistente en la misma conversación de siempre, indicando dónde están
los documentos y qué nombre quieres darle. Él prepara la carpeta,
convierte los PDF a texto, repara las palabras que la maquetación parte
con guiones, descarta lo que no sea texto aprovechable y construye el
índice. Un cuaderno de unos cuantos PDF está listo en unos minutos.
La instrucción, otra vez escrita para el asistente y no para quien la
copia:
Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.
Lo importante es la primera condición. Sin ella, el asistente puede
ponerse a instalarlo todo de nuevo, con otra copia de los modelos, y el
ordenador acaba con tres gigabytes repetidos por cada cuaderno.
Añadir documentos a un cuaderno que ya existe es todavía más simple:
se dejan los ficheros nuevos y se pide que lo actualice. Aquí importa
una de las condiciones que se le exigieron al montarlo, la del indexado
incremental: el sistema guarda una huella de cada documento y solo
procesa los que han cambiado, así que incorporar un PDF cuesta el tiempo
de ese PDF, alrededor de un minuto por cada cien mil caracteres, y no el
del fondo entero. Sin esa condición, añadir una circular de dos folios
obligaría a rehacerlo todo.
Al preguntar, con un solo cuaderno no hace falta decir cuál; con
varios, se nombra el que interesa. El asistente los ve todos y, si la
pregunta lo pide, puede buscar en el que corresponda.
Cuándo montar un RAG
Con poco material no hace falta montar nada.
Los modelos actuales procesan cientos de miles de palabras de una sola vez. Por debajo de unas trescientas páginas, basta con dejar los documentos en una carpeta y pedirle al asistente que los lea directamente. Buscando por su cuenta, acierta más que cualquier RAG, porque puede leer, releer y afinar la búsqueda tantas veces como haga falta. Entre trescientas y mil quinientas páginas hay una zona intermedia: el material cabe, pero se relee entero en cada pregunta, y eso resulta lento y caro en una consulta diaria, por lo que se aconseja montar el RAG. Por encima de mil quinientas páginas ya no cabe, y el RAG deja de ser opcional.
El criterio es el volumen de texto, no el número de archivos.
Cincuenta circulares de dos folios no llegan a cien páginas; tres
memorias anuales pueden superar las mil.
Guía rápida
Las tres instrucciones, sin explicaciones. Se pegan tal cual en
Claude, Codex o Antigravity, sustituyendo lo que va entre ángulos.
1. Montar el primer cuaderno. Una sola vez.
Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.
2. Crear otro cuaderno, reutilizando lo ya
instalado.
Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.
3. Añadir documentos a un cuaderno que ya existe. Lo
más frecuente con el tiempo.
Añade estos documentos al cuaderno <nombre>:
<carpeta o lista de ficheros>

- Trátalos igual que los que ya están: mismo troceado
  y misma limpieza.
- Aprovecha el indexado incremental: procesa solo lo
  nuevo, sin rehacer el índice entero.
- Al terminar, dime qué has añadido y qué documentos
  contiene ahora el cuaderno.
En los tres casos conviene leer lo que responde antes de dejarle
continuar. Si su plan no respeta la estructura de los documentos (los
artículos de una norma, los puntos del orden del día de un acta), es el
momento de decírselo, porque de ese detalle depende la calidad de todas
las respuestas posteriores.
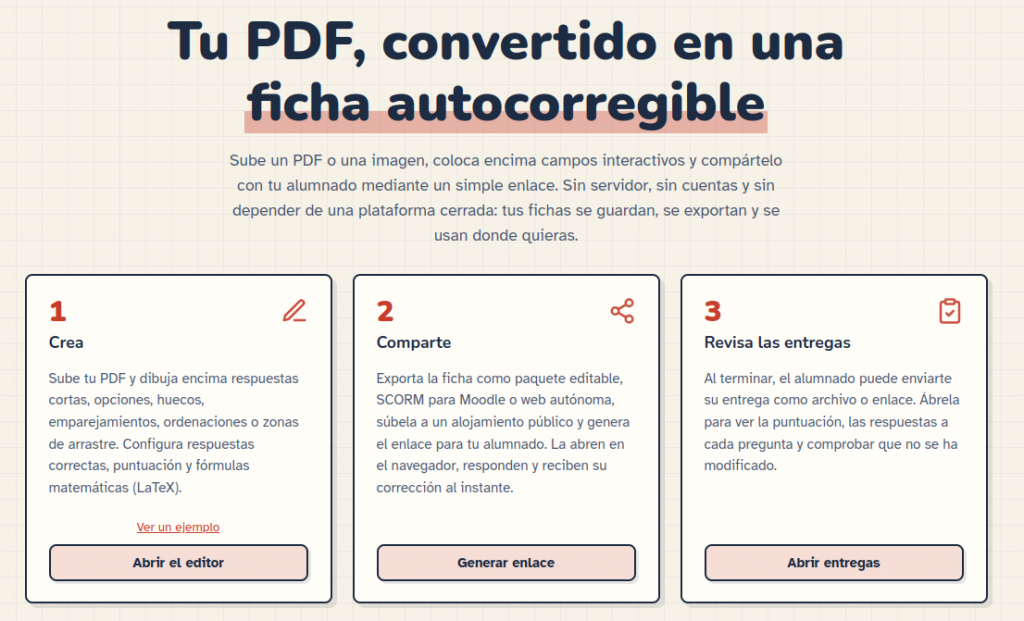
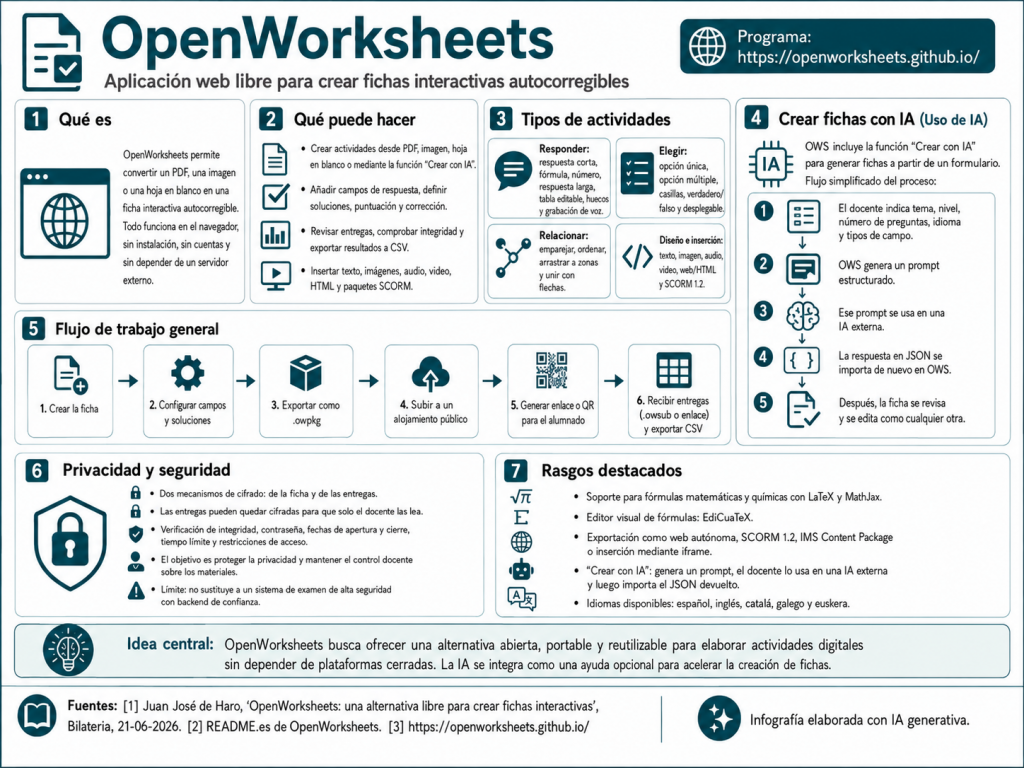
OpenWorksheets (OWS) es una aplicación web libre para crear fichas interactivas y autocorregibles a partir de un PDF, una imagen o una hoja en blanco.
Pantalla inicial de OpenWorksheets
El profesorado prepara su ficha, coloca encima los campos de respuesta y define las soluciones. Después, el alumnado la resuelve desde el navegador y el docente puede revisar las entregas, ver la puntuación y exportar los resultados.
OWS tiene como bandera la libertad, privacidad, portabilidad y reutilización sin depender de una plataforma cerrada. No necesita cuentas de usuario ni servidores externos, ya que todo funciona en el navegador del profesorado y en el del alumnado. La comunicación entre ambos se realiza mediante archivos de entrega cifrados, que tienen extensión .owsub (OpenWorksheets submissions) o a través de una URL (también cifrada) que se envía directamente al docente.
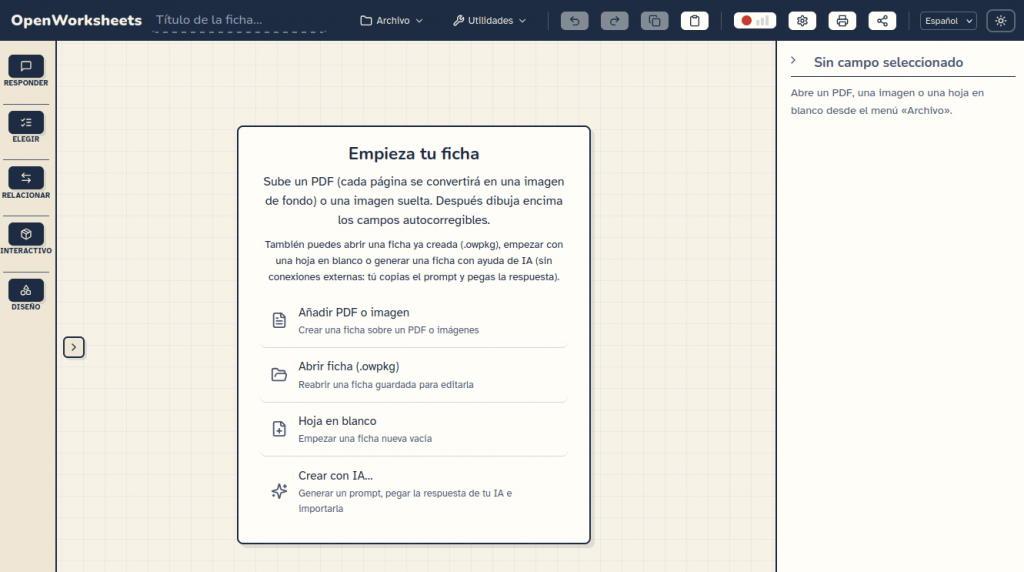
Pantalla inicial del editor con las diferentes formas de crear una ficha.
Las formas que tenemos para crear una ficha (proyecto) son:
Añadir PDF o imagen, esta es la forma habitual. Podemos abrir un PDF o una imagen para dibujar encima los campos autocorregibles de forma que podemos aprovechar documentos ya existentes.
Abrir una ficha ya creada con extensión .owpkg (OpenWorksheets package). Podremos continuar trabajando en un proyecto guardado anteriormente.
Comenzar con una hoja en blanco sobre la cual podremos crear nuestra ficha.
Crear con IA (prompt) permite producir una ficha a partir de una página en blanco con los parámetros que definamos (nivel, tema, tipos de campos deseados, etc.). Se utilizan los tipos de campo que pueden generarse automáticamente; quedan fuera los que dependen directamente de recortes o zonas del PDF. OWS generará un prompt que podremos pegar en nuestra IA de cabecera. No hay que instalar nada.
Crear o convertir fichas con IA (MCP). Es el camino más potente y el único que puede partir de un documento propio: instalando el servidor MCP de OpenWorksheets, la IA abre nuestro PDF o nuestra imagen, coloca los campos encima, cada uno en su sitio, y nos enseña el resultado antes de guardarlo. También puede inventar la ficha entera desde cero sobre hojas en blanco. El archivo no se sube a ningún servicio, lo abre nuestro propio ordenador, aunque la IA sí ve el contenido de las páginas para poder trabajar. Requiere instalar un programa una sola vez, y se explica en un artículo aparte.
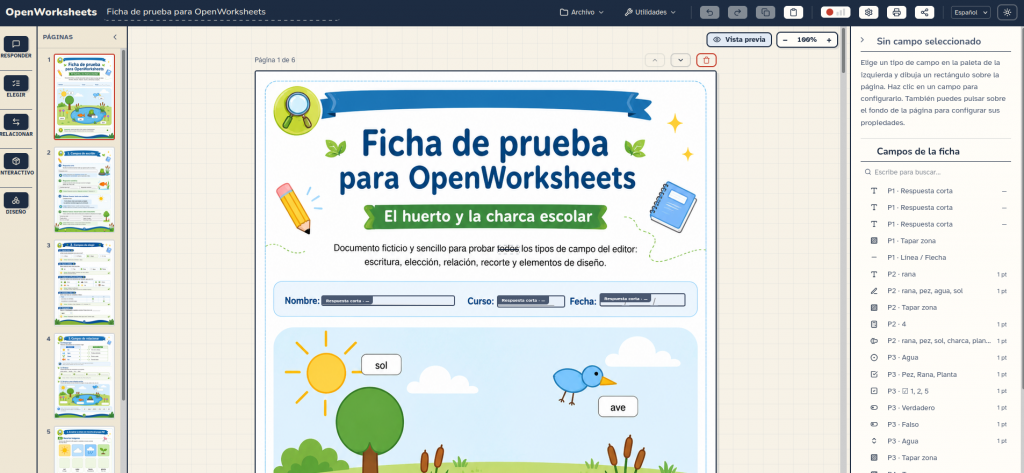
Un proyecto abierto (ficha). En la parte izquierda accedemos a los botones para crear campos, las miniaturas y a la derecha la lista de todos los campos y sus propiedades cuando se selecciona uno.
Además, las fichas pueden guardarse como archivo propio (.owpkg), exportarse como página web autónoma y compartirse mediante enlace (previa subida a la nube obteniendo un enlace público), como web incrustada en otra o integrarse en Moodle y otros LMS mediante SCORM 1.2.
La aplicación admite muchos tipos de respuesta: texto corto, respuesta numérica, fórmulas matemáticas o químicas, verdadero/falso, opción única o múltiple, desplegables, huecos, tablas editables, emparejamientos, ordenar elementos, arrastrar a zonas, unir con flechas, respuesta larga y grabación de voz. También permite insertar imágenes, audio, vídeo, contenido HTML, paquetes de eXeLearning, IMS CP y SCORM.
Como profesor de matemáticas y ciencias, soy especialmente sensible a la posibilidad de crear fórmulas. Cualquier texto de la ficha puede incluir fórmulas LaTeX. Además, el editor de fórmulas de elaboración propia, EdiCuaTeX, se integra de forma natural para permitir la edición visual sin conocimientos de LaTeX, tanto en la parte del profesorado como en la del alumnado. No obstante, soy consciente de que una gran parte del profesorado no usará nunca fórmulas en sus fichas, por ese motivo se pueden desactivar en la configuración de la ficha.
OpenWorksheets también incorpora opciones de seguridad y privacidad: cifrado de la ficha, cifrado de entregas, verificación de integridad, restricciones de acceso, tiempo límite y supervisión ligera durante la realización. Un semáforo de seguridad indica su nivel en la barra superior.
Flujo de trabajo
El flujo de trabajo más habitual es compartir la ficha mediante un enlace o código QR:
El profesor crea la actividad en el editor a partir de un PDF, una imagen, IA o una hoja en blanco.
Añade los campos de respuesta y configura las soluciones, la puntuación y las opciones de corrección.
Exporta la ficha como paquete .owpkg.
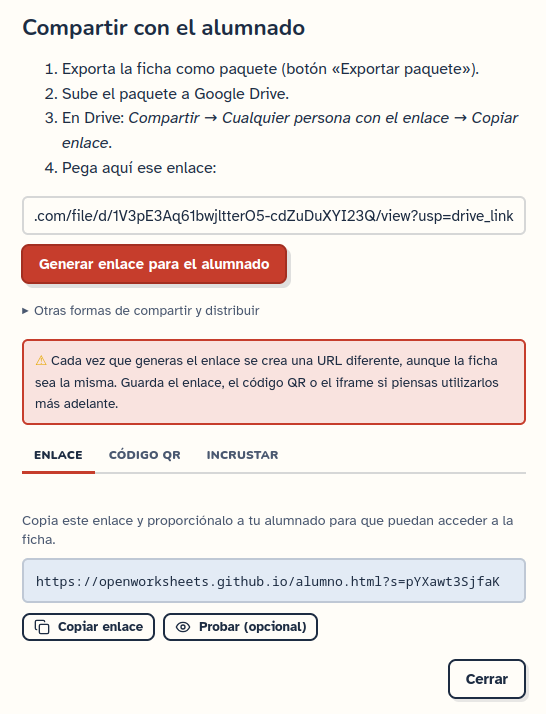
Sube ese paquete a Google Drive o a otro alojamiento público.
En Google Drive, activa la opción Cualquier persona con el enlace y copia la URL pública del archivo.
Pega esa URL en OpenWorksheets para generar el enlace final del alumnado.
Comparte ese enlace con los estudiantes.
El alumnado abre la ficha en el navegador, la completa y entrega sus respuestas mediante archivo o enlace de entrega.
El docente abre las entregas en OpenWorksheets, comprueba su integridad, revisa las respuestas, ajusta las correcciones manuales si las hay y exporta los resultados a CSV.
Además de este flujo principal, OpenWorksheets permite otras formas de uso:
Exportar la ficha como página web autónoma, para publicarla a través de una página web.
Integrarla en Moodle u otro LMS mediante SCORM 1.2.
Exportarla como IMS Content Package.
Embeberla en otra página mediante un iframe.
Cuadro de diálogo para compartir una ficha. Antes se tiene que subir la ficha a un servicio público de almacenamiento como Google Drive.
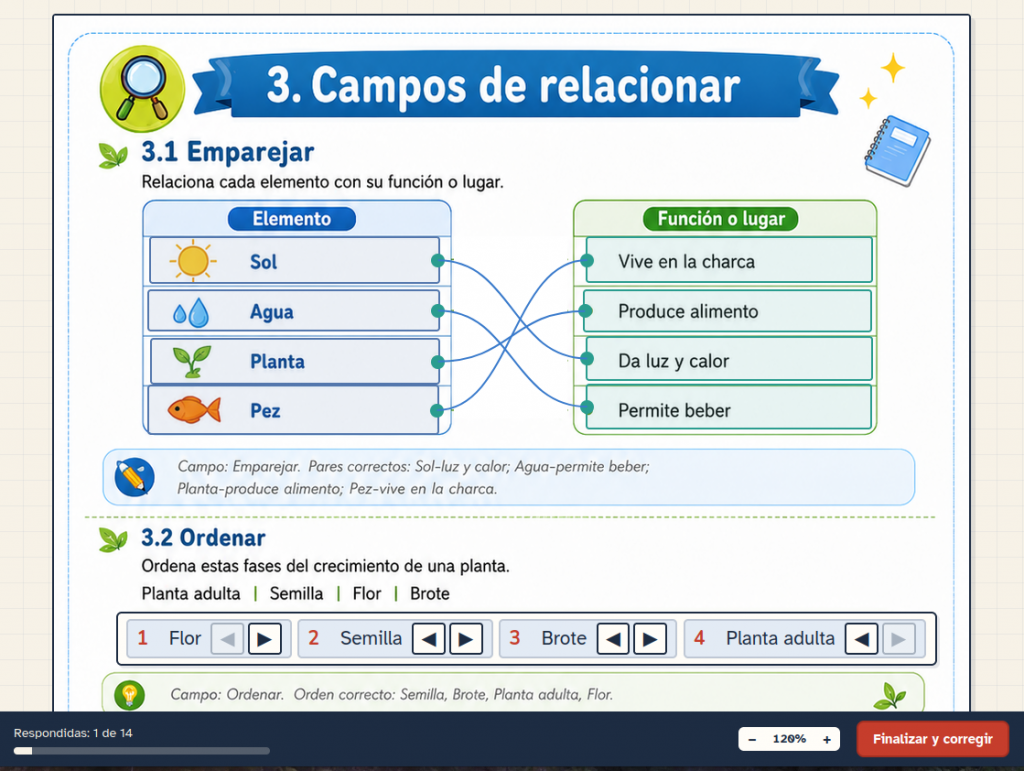
Una ficha tal como la ve el alumnado. En la esquina inferior derecha tiene la opción de finalizarla.
OpenWorksheets permite crear, compartir y corregir fichas interactivas con un enfoque abierto, portable y respetuoso con la privacidad. La intención es que el profesorado pueda conservar el control sobre sus materiales y utilizarlos en distintos contextos, sin depender de una plataforma cerrada.
Puedes ver una descripción de las posibilidades más completa en la página de las características del programa.
Nota: Este artículo tiene nivel 4 en el marco MIAE.
Sería insensato, y contradictorio en sí mismo, pensar que es posible hacer lo que hasta ahora nunca se ha hecho por procedimientos que no sean totalmente nuevos.






Comentarios recientes