Blog sobre educación

Mes: agosto 2026

EdiMarkWeb: escribir en Markdown y convertir a cualquier formato

La preparación de materiales suele exigir un mismo contenido en formatos distintos: el documento de Word que pide el departamento, el PDF que se entrega al alumnado y, en ocasiones, la página web del aula virtual. Cuando el texto incluye fórmulas, la conversión de un formato a otro deja de ser inmediata y obliga a repasar y rehacer el resultado en cada paso.

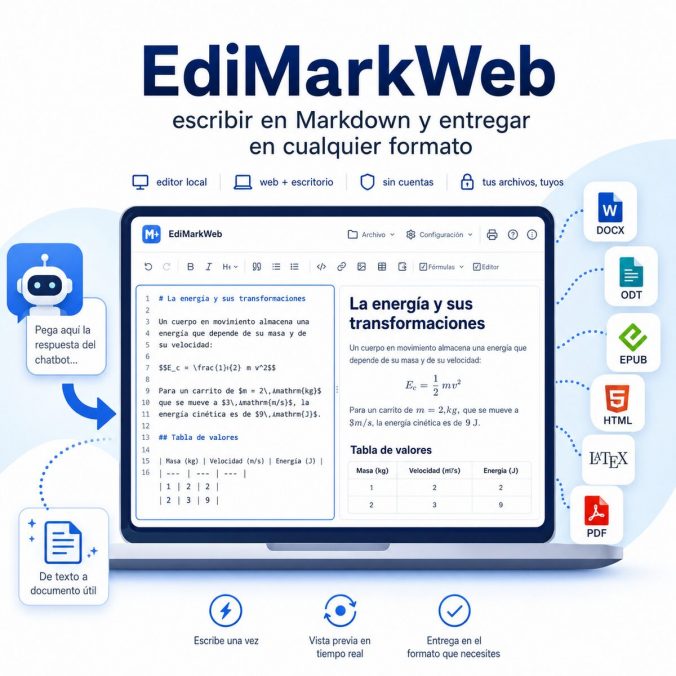
EdiMarkWeb es un editor de Markdown pensado para ese trabajo: se escribe una sola vez, o se pega directamente lo que ha respondido un chatbot, se ve el resultado mientras se escribe y se exporta a DOCX, ODT, EPUB, HTML, LaTeX o PDF según convenga. Funciona en el navegador, sin instalar nada, y también como aplicación de escritorio para Linux, Windows y macOS. En los dos casos el documento no sale del equipo: no hay cuentas, ni servidores, ni subida de archivos a ningún sitio.

Pódcast del artículo realizado por Gemini Notebook

Markdown y los dos editores

Markdown es texto corriente con unas pocas marcas: almohadillas para los encabezados, asteriscos para la negrita, guiones para las listas. Se aprende en unos minutos y tiene una ventaja de fondo: el archivo es texto plano, de modo que se abre en cualquier ordenador, también dentro de veinte años, sin depender de la versión del programa con que se escribió.

La pantalla se divide en dos paneles. A la izquierda, el editor Markdown, con el texto y sus marcas. A la derecha, el editor visual, con el documento ya compuesto. Los dos están sincronizados y los dos se pueden editar, de modo que se puede corregir sobre el texto acabado, como en un procesador, y ver cómo cambia el Markdown de la izquierda. La barra de herramientas cubre lo habitual (encabezados, listas, citas, enlaces, imágenes, tablas, bloques de código) y trabaja en cualquiera de los dos.
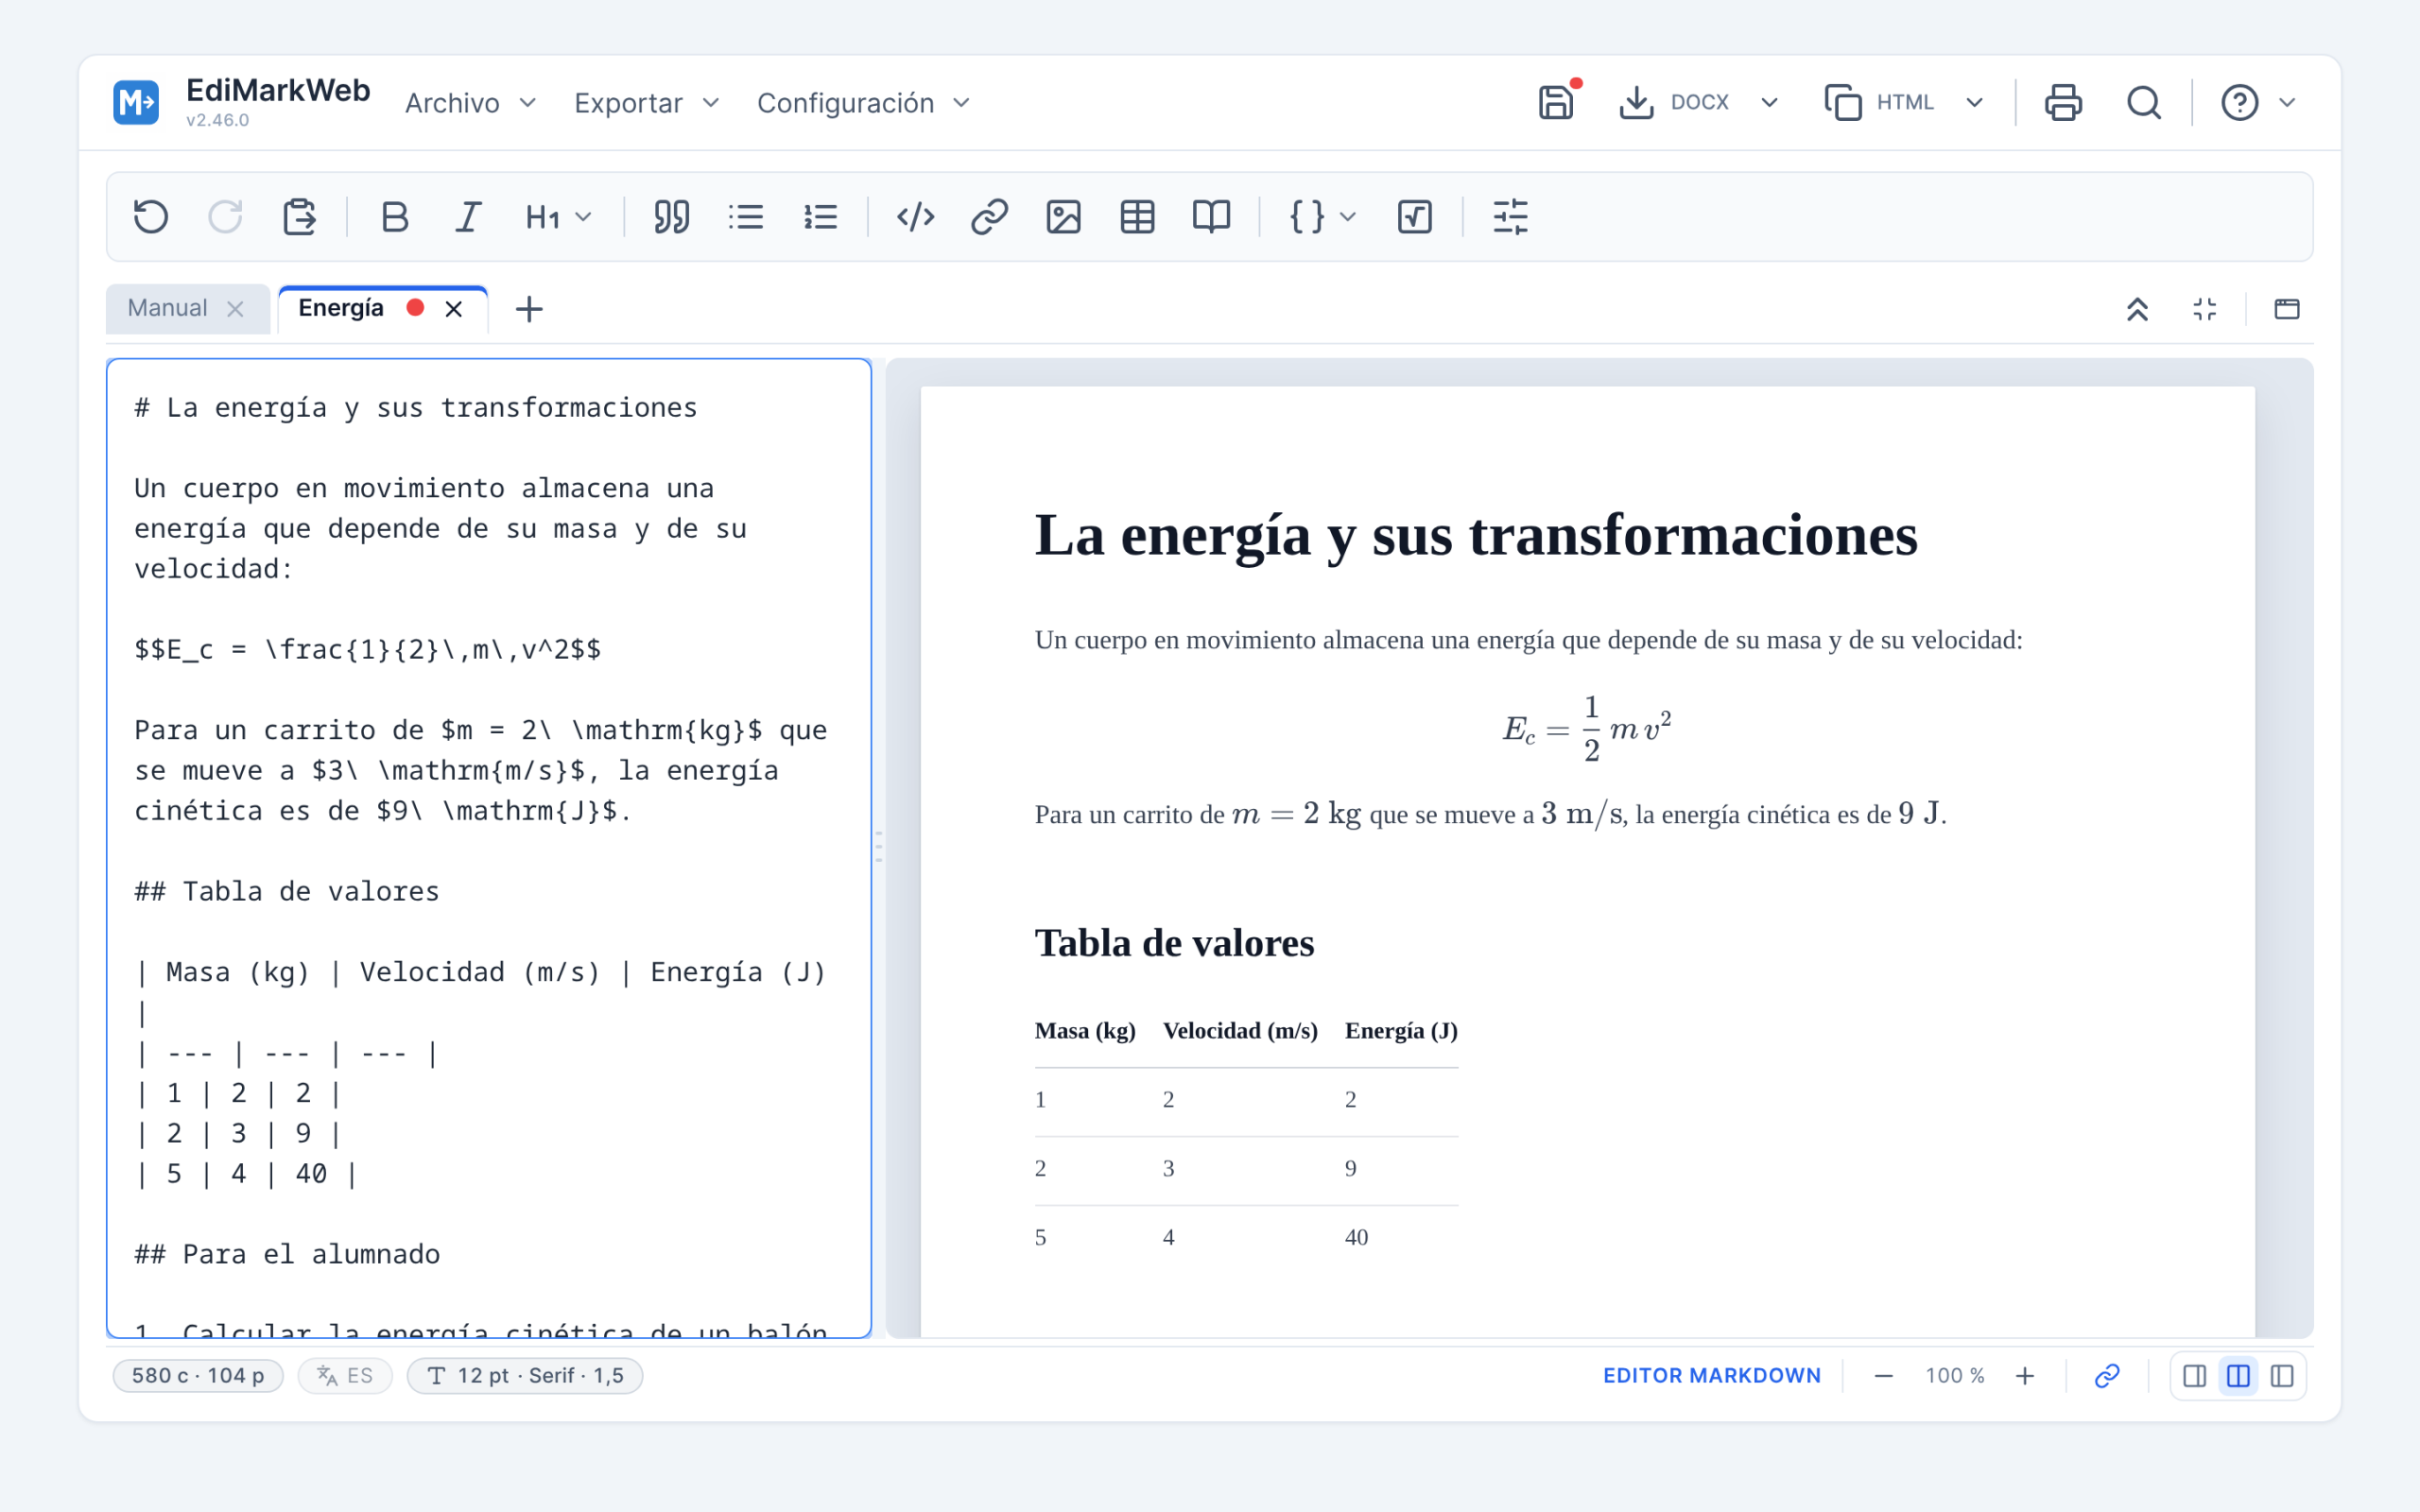
Bajo los paneles, una barra de estado reúne lo que se consulta a diario: el número de caracteres y palabras, el idioma del documento, un resumen de cómo va a salir (tamaño de letra, tipo e interlineado), la lupa y los tres botones que reparten la pantalla entre un panel, los dos o el otro.

Los documentos se organizan en pestañas, cada una con su archivo, y se guardan solas: si se cierra el navegador por accidente, al volver está todo. Y si queda algo sin guardar, avisa antes de cerrar la pestaña.

El Markdown de la IA, directamente al documento

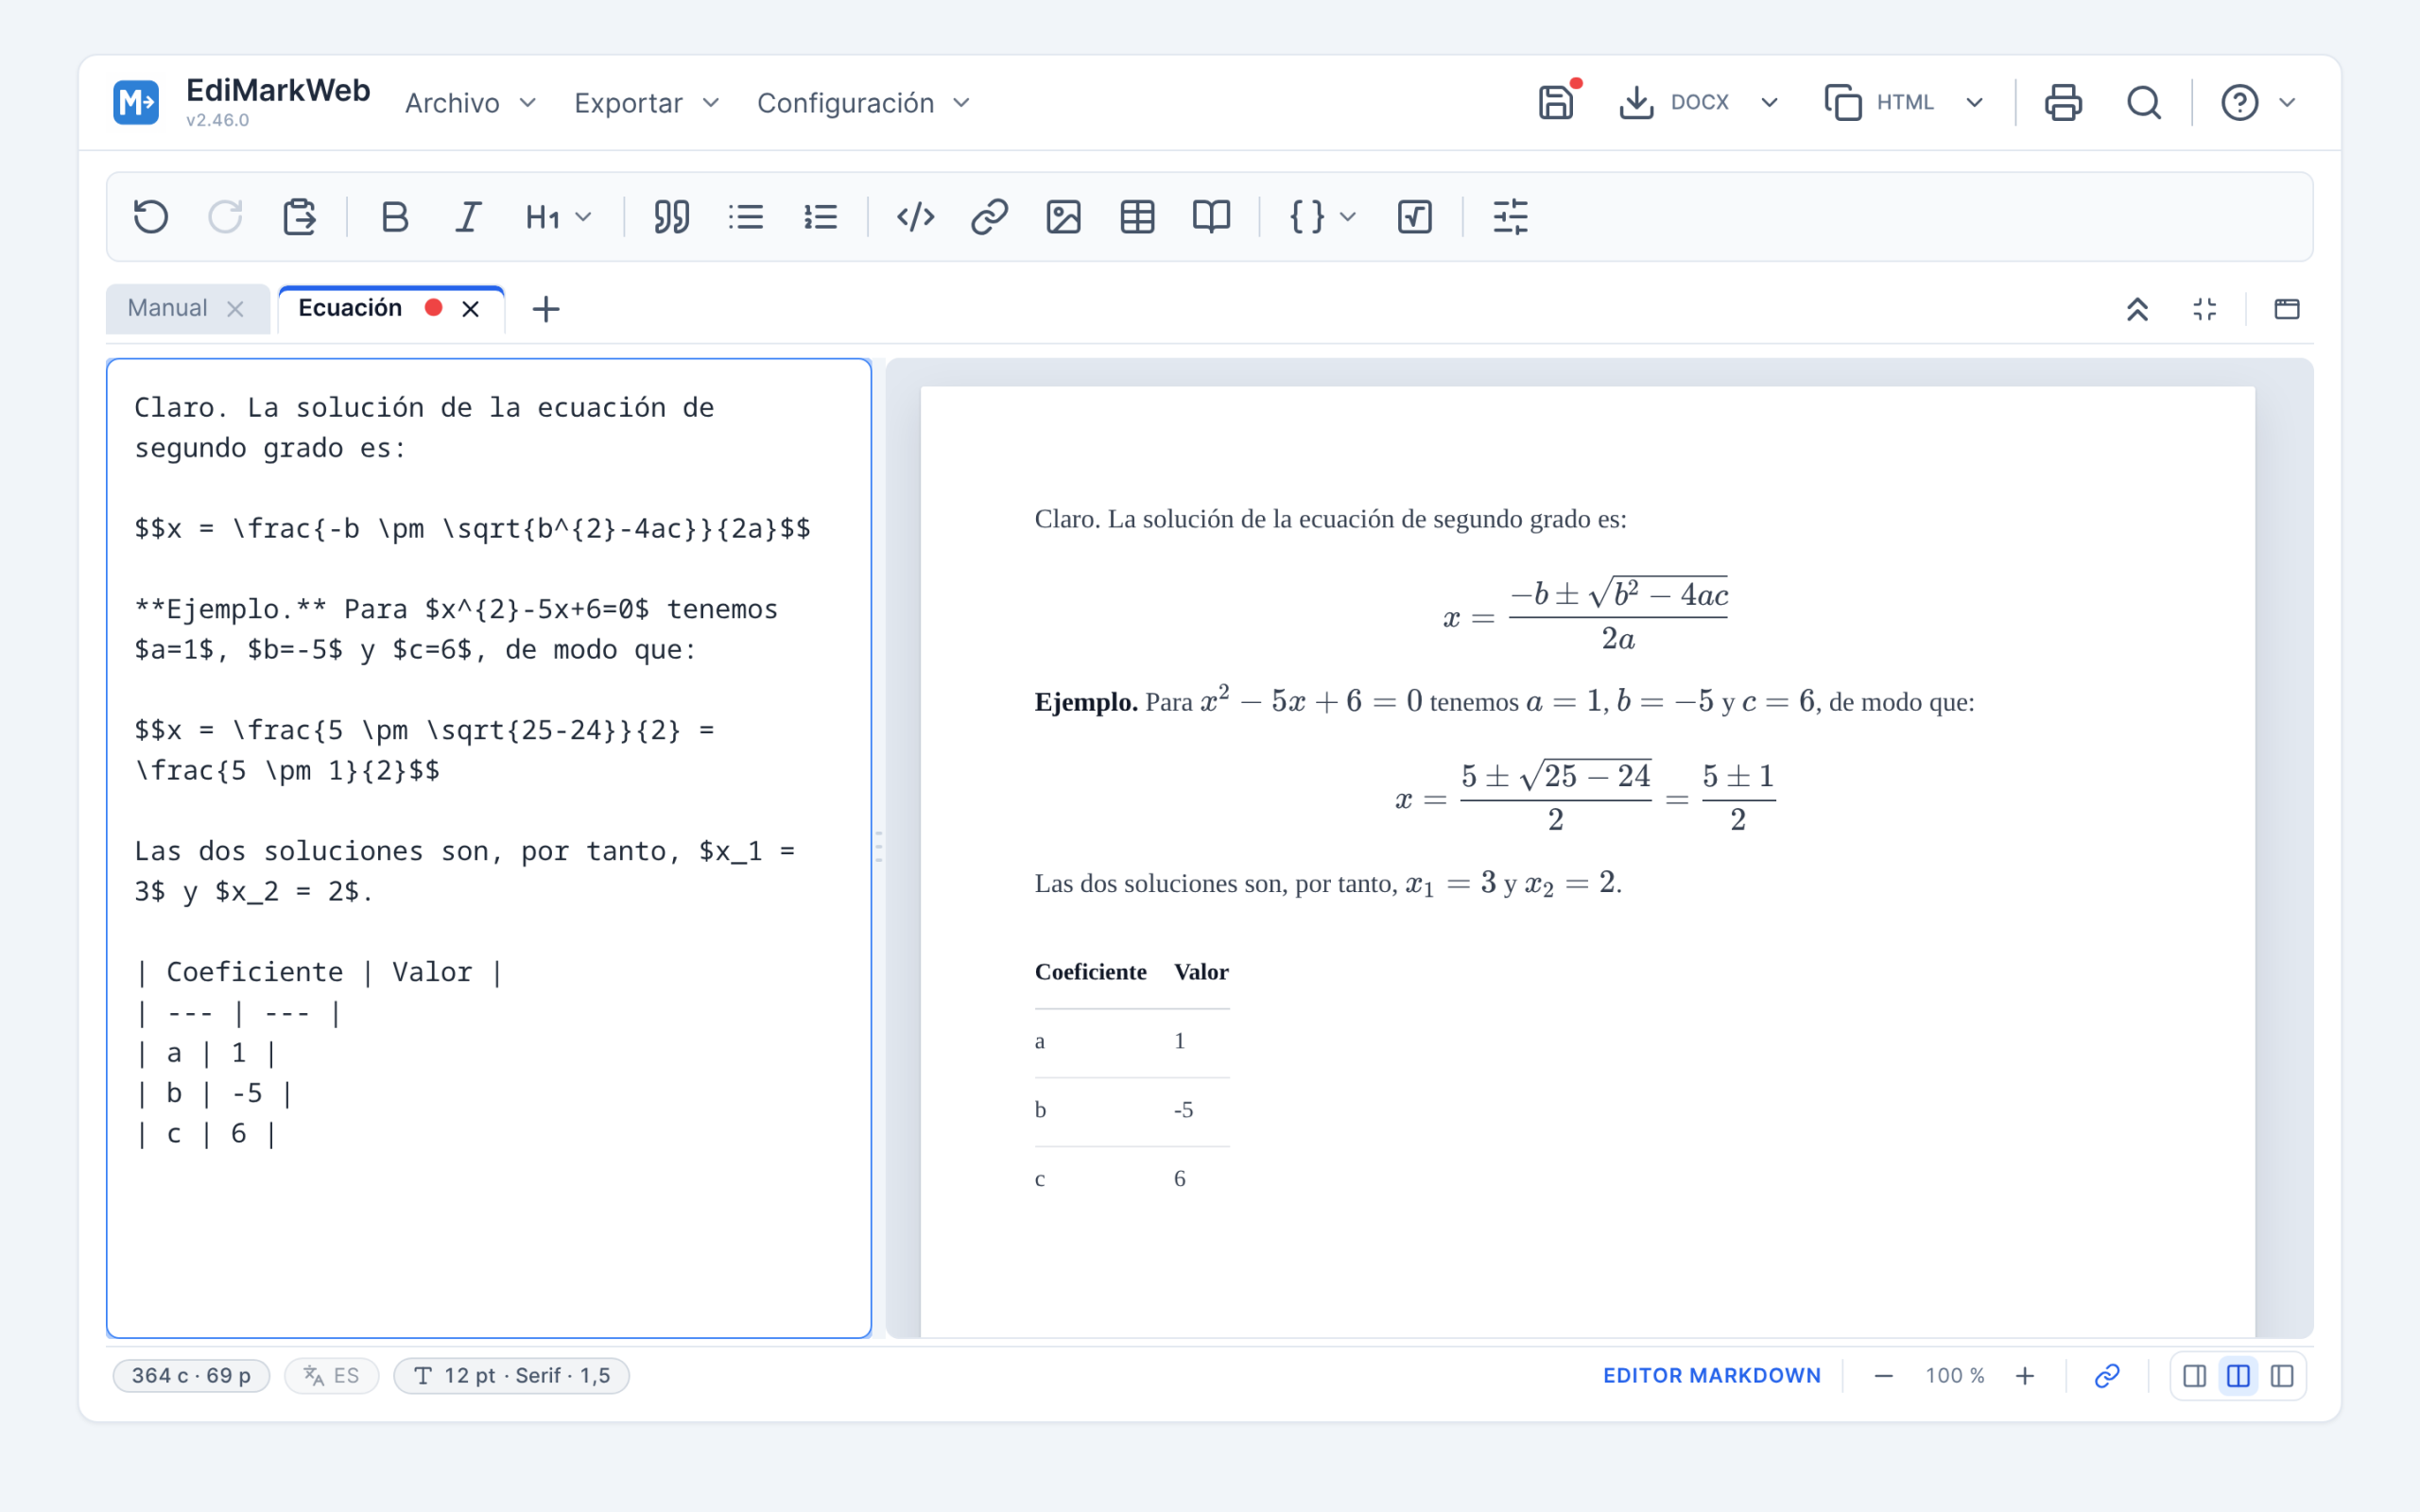
Esta es la función con la que nació el programa y sigue siendo la más utilizada. Al copiar la respuesta de un chatbot y pegarla en un procesador de textos, lo que aparece es un texto lleno de asteriscos y almohadillas. Las fórmulas llegan además como el código que son, \frac{-b \pm \sqrt{b^{2}-4ac}}{2a}, y no compuestas. El contenido es correcto, pero no se puede entregar en ese estado.

La causa es que las inteligencias artificiales responden en Markdown, con las fórmulas escritas en LaTeX. Es su formato nativo, aunque el chat lo presente ya compuesto. Al copiar, lo que viaja son las marcas, y el procesador de textos no sabe qué hacer con ellas.

EdiMarkWeb interpreta ese formato. Se copia la respuesta del chat, se pega en el panel izquierdo y en el derecho aparece el documento terminado: los encabezados como encabezados, las listas como listas, las tablas como tablas y las fórmulas compuestas. De ahí sale ya un DOCX, un ODT o un PDF listos para entregar.
El pegado admite algo más que texto plano. El botón Pegar de la barra de herramientas, o el habitual Ctrl+V, reconoce también el contenido enriquecido que se copia de una página web o de un documento de Word, y lo convierte a Markdown, así como las imágenes copiadas al portapapeles, que quedan incrustadas en el documento. Y para las respuestas que vienen en LaTeX completo, con su preámbulo y su \begin{document}, está Archivo → Pegar LaTeX (Ctrl+Mayús+V), que las convierte en un documento editable.

En la práctica, la conversación con la IA deja de quedarse en el chat y se convierte en material de trabajo (los ejercicios resueltos, el examen, los apuntes de un tema) guardado en un archivo propio, en el ordenador, y en el formato que haga falta.

La vista previa compone la página real

El cambio más visible de las últimas versiones está en el panel derecho, que ha pasado de mostrar una aproximación del documento a componer la página tal como se va a imprimir. La hoja mide lo que mide un A4 o una Carta y el texto se reparte en páginas, con su separación entre una y otra. El corte cae siempre entre dos bloques, nunca a media línea, como en un procesador de textos.
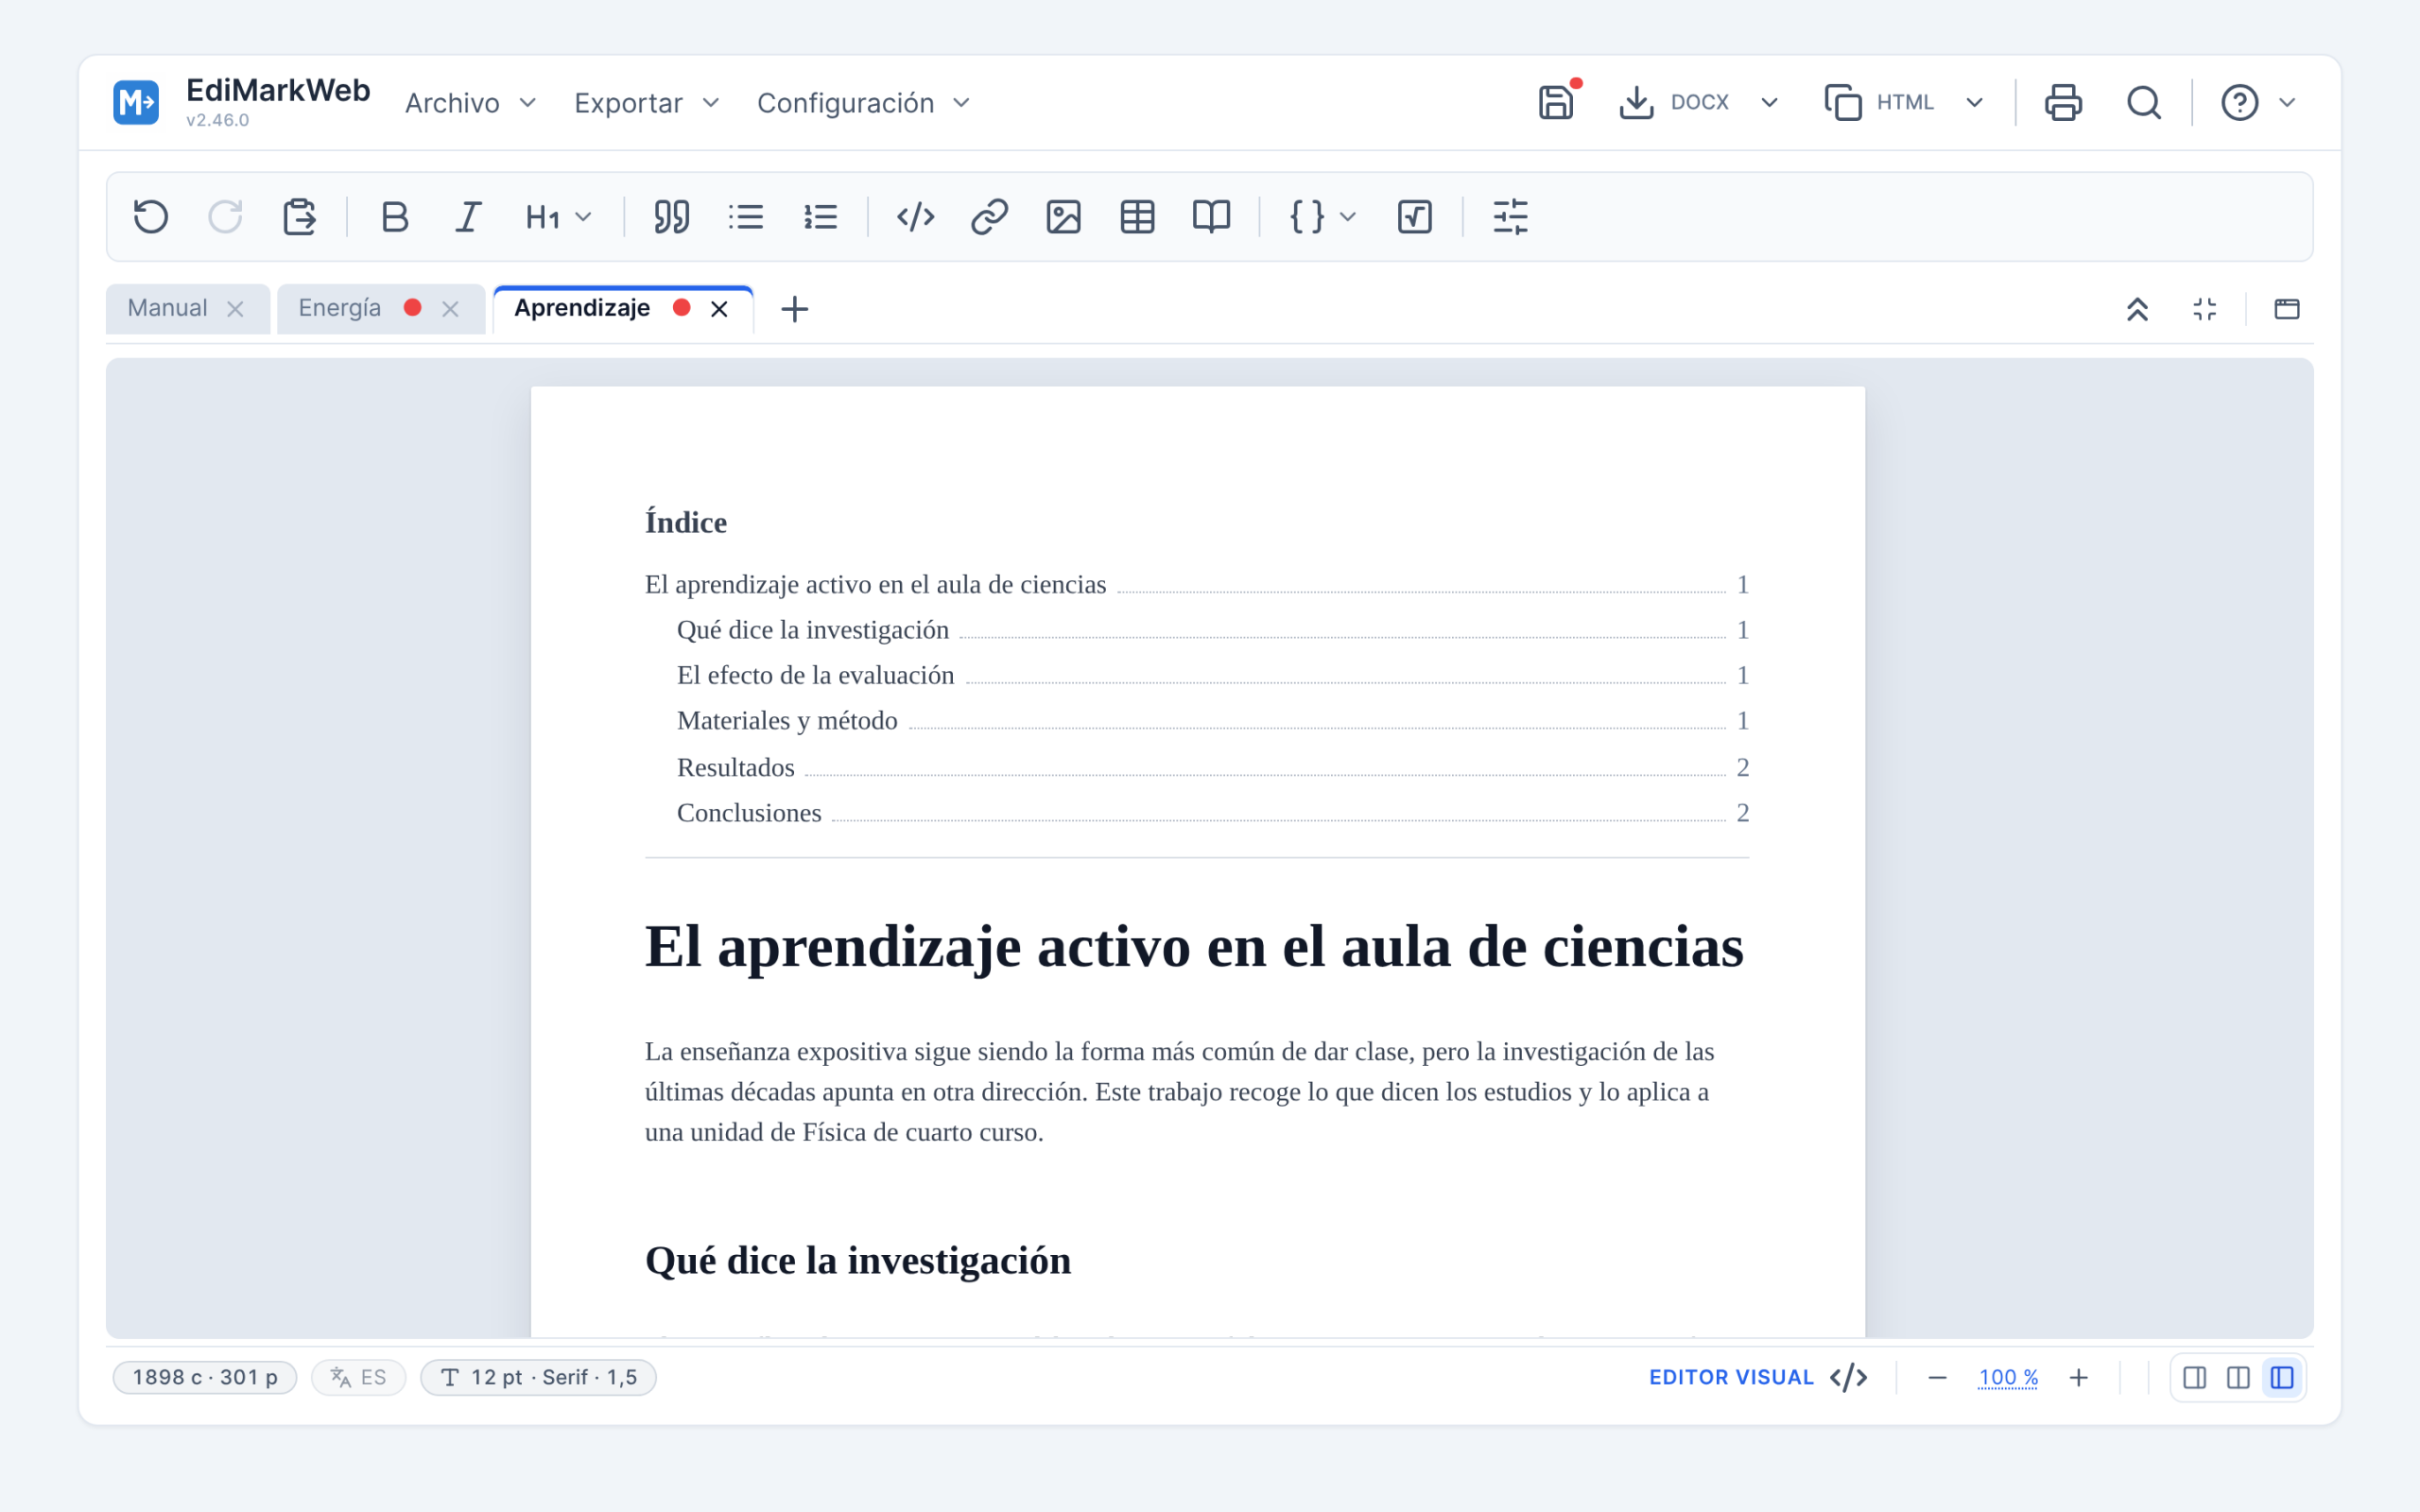
El aumento se aplica a la página completa, con sus márgenes, en lugar de reordenar el texto, de modo que el reparto se conserva. Un interruptor con forma de cadena vincula además el ancho del panel y el aumento en los dos sentidos: al apartar el separador la hoja crece, y al modificar la lupa es el separador el que se retira para dejarle sitio. La página se ve así siempre entera, sin barra de desplazamiento horizontal.

El reparto es exacto para el PDF y para la impresión, que se generan a partir de esta misma hoja.

Las fórmulas

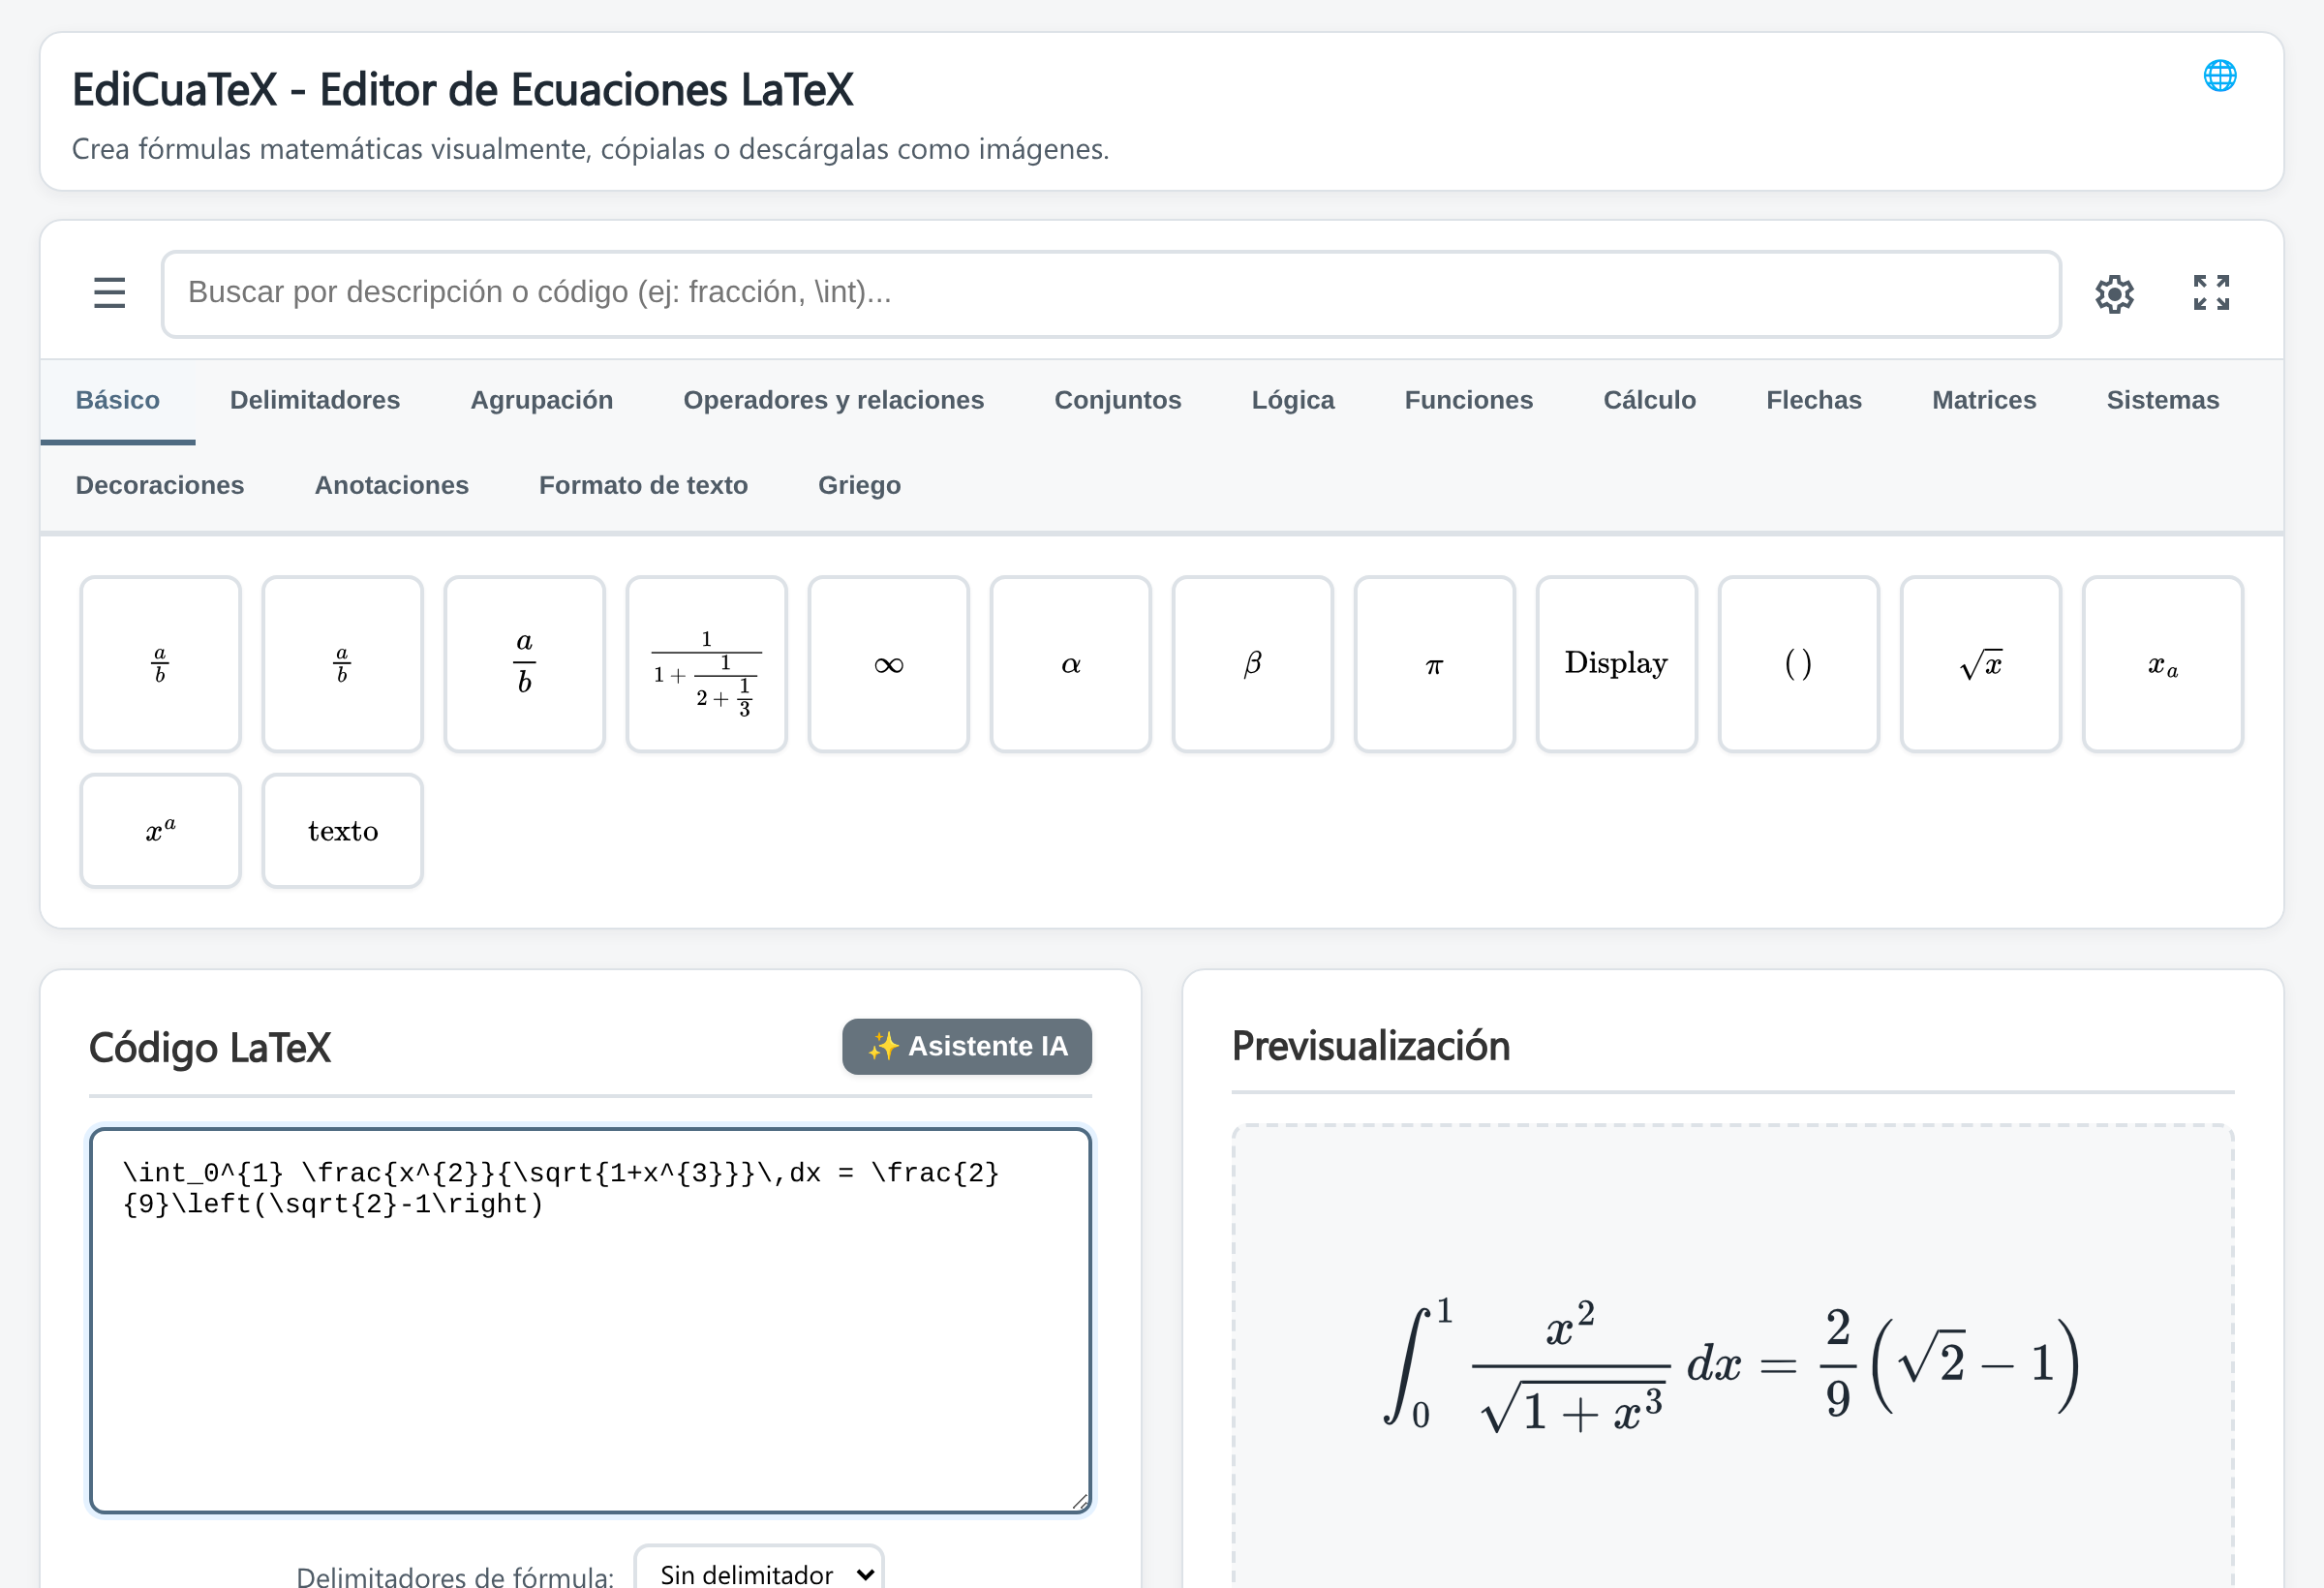
Las fórmulas se escriben en LaTeX entre delimitadores, y se admiten los cuatro habituales: \(...\) y $...$ para las que van dentro de una línea, \[...\] y $$...$$ para las que van aparte. Los dos primeros son los recomendados, porque el dólar también aparece en el texto por sus propios motivos y ahí puede confundirse con el principio de una fórmula. La vista previa las compone al momento con KaTeX, mientras se escribe. Hay tres maneras de ponerlas: el menú de fórmulas del editor Markdown, que inserta los delimitadores sin tener que recordarlos; una ventana propia en el editor visual, que muestra el código y el resultado a la vez y avisa del error si lo hay; y EdiCuaTeX, el editor visual de ecuaciones, para quien no domine la sintaxis.
Los formatos de entrada y de salida

Editores de Markdown hay muchos. Lo que distingue a EdiMarkWeb son los formatos que admite al abrir un documento y los que produce al exportarlo.
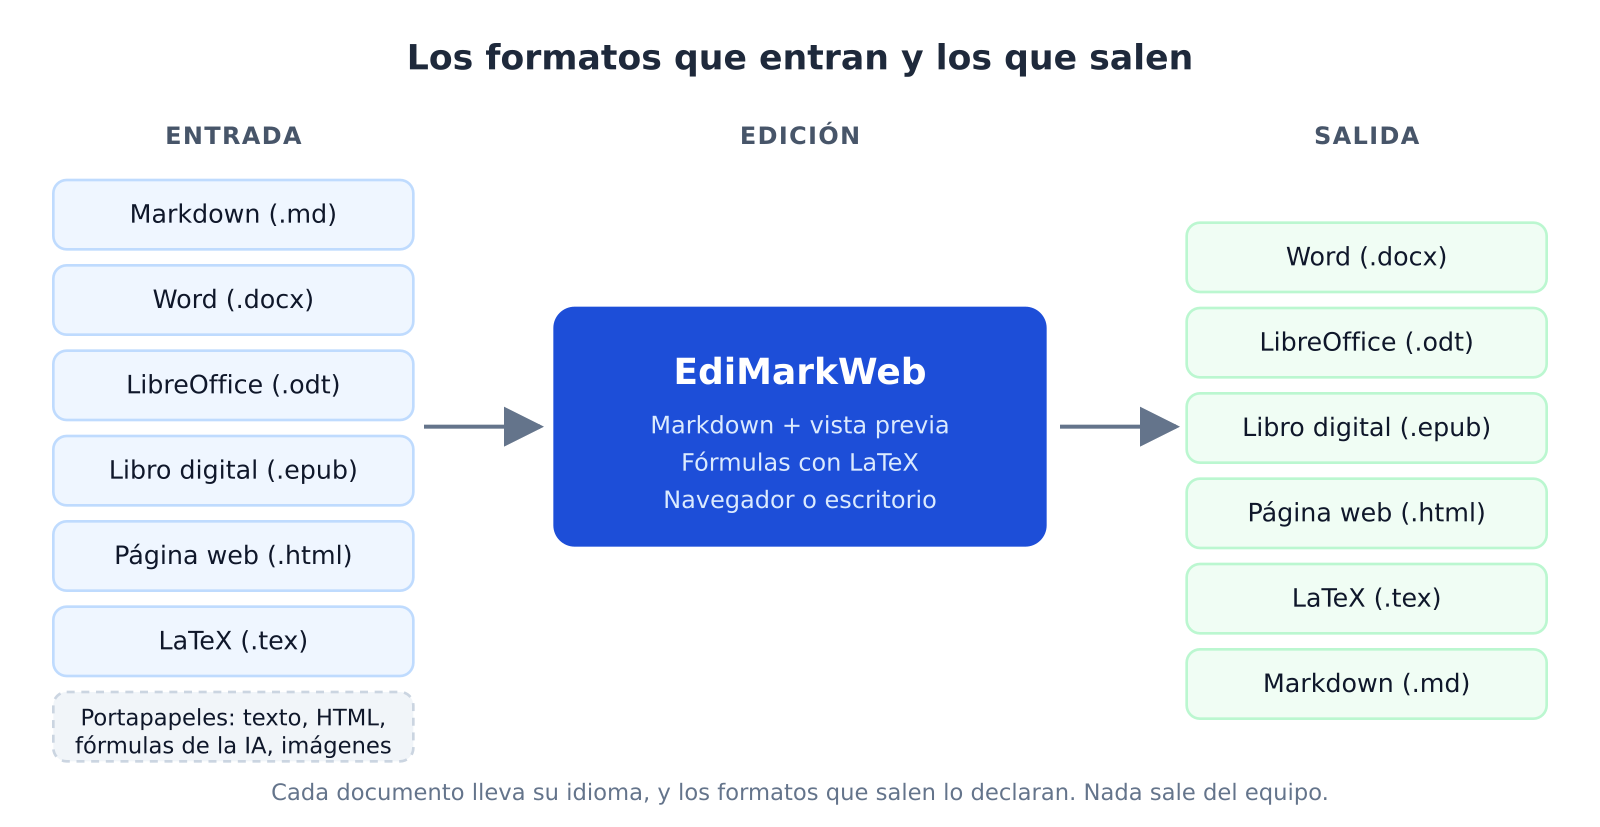
Lo que entra. Además de los archivos Markdown, se pueden abrir documentos de Word (.docx), de LibreOffice (.odt), libros digitales (.epub), páginas web (.html) y documentos LaTeX (.tex), que se convierten a Markdown al abrirlos. Las imágenes de los DOCX, ODT y EPUB se extraen del propio archivo, de modo que no se pierden, y de un EPUB vuelve además el idioma, que el libro guarda en su envoltorio y no en el texto. Los archivos se pueden arrastrar sobre la ventana, incluso carpetas enteras: cada documento compatible se abre en su pestaña y lo demás se ignora.

Lo que sale. Del mismo documento se obtiene un DOCX para quien trabaja con Word, que es también el formato con el que Google Docs importa y exporta, de modo que el mismo archivo sirve para los dos, un ODT para LibreOffice, un EPUB que se lee en cualquier lector de libros electrónicos, una página web autónoma (con los estilos y las fórmulas dentro del propio archivo, lista para subir a un servidor) o un .tex preparado para compilar. Y el PDF, que es la sexta salida del menú: abre el diálogo de impresión del sistema, donde se elige «Guardar como PDF» como destino. Lo que sale es exactamente lo que se ve en la hoja, con las fórmulas compuestas, los márgenes del documento y el texto seleccionable y buscable.
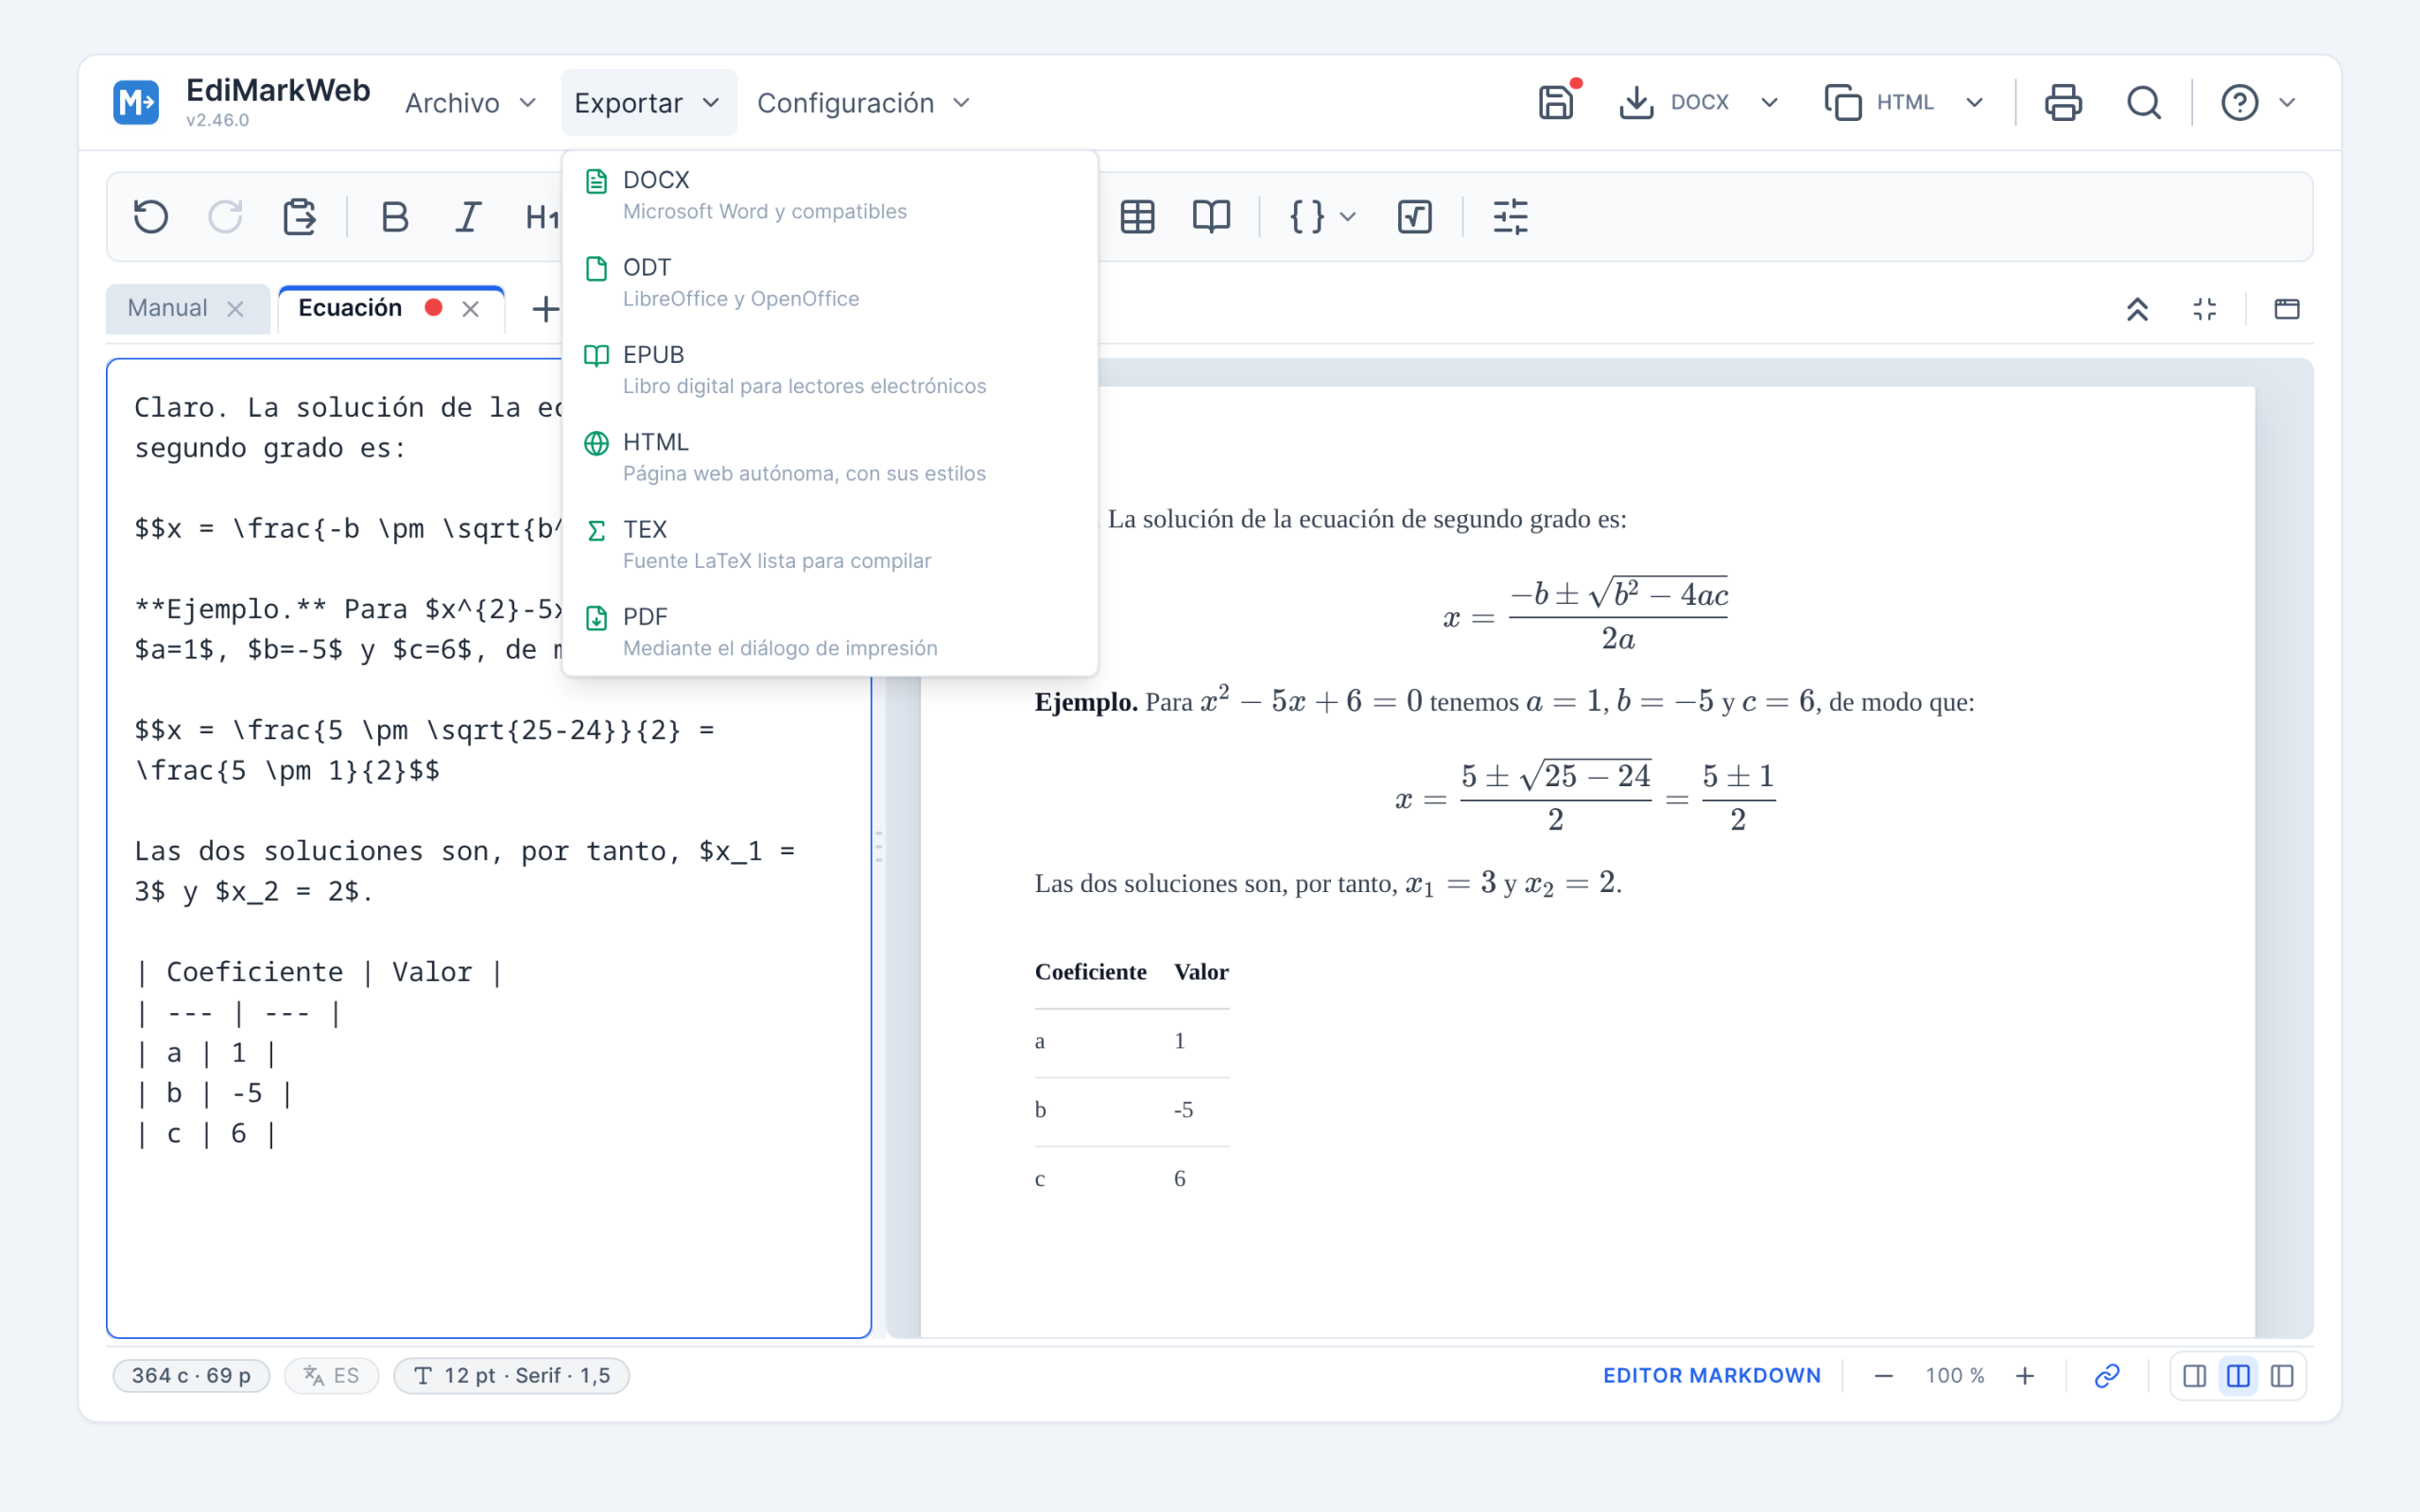
En la barra de arriba, junto al icono de guardar, hay además dos botones que repiten de un clic el último formato usado, y lo dicen en un rótulo pequeño: uno exporta a un archivo y el otro copia al portapapeles.

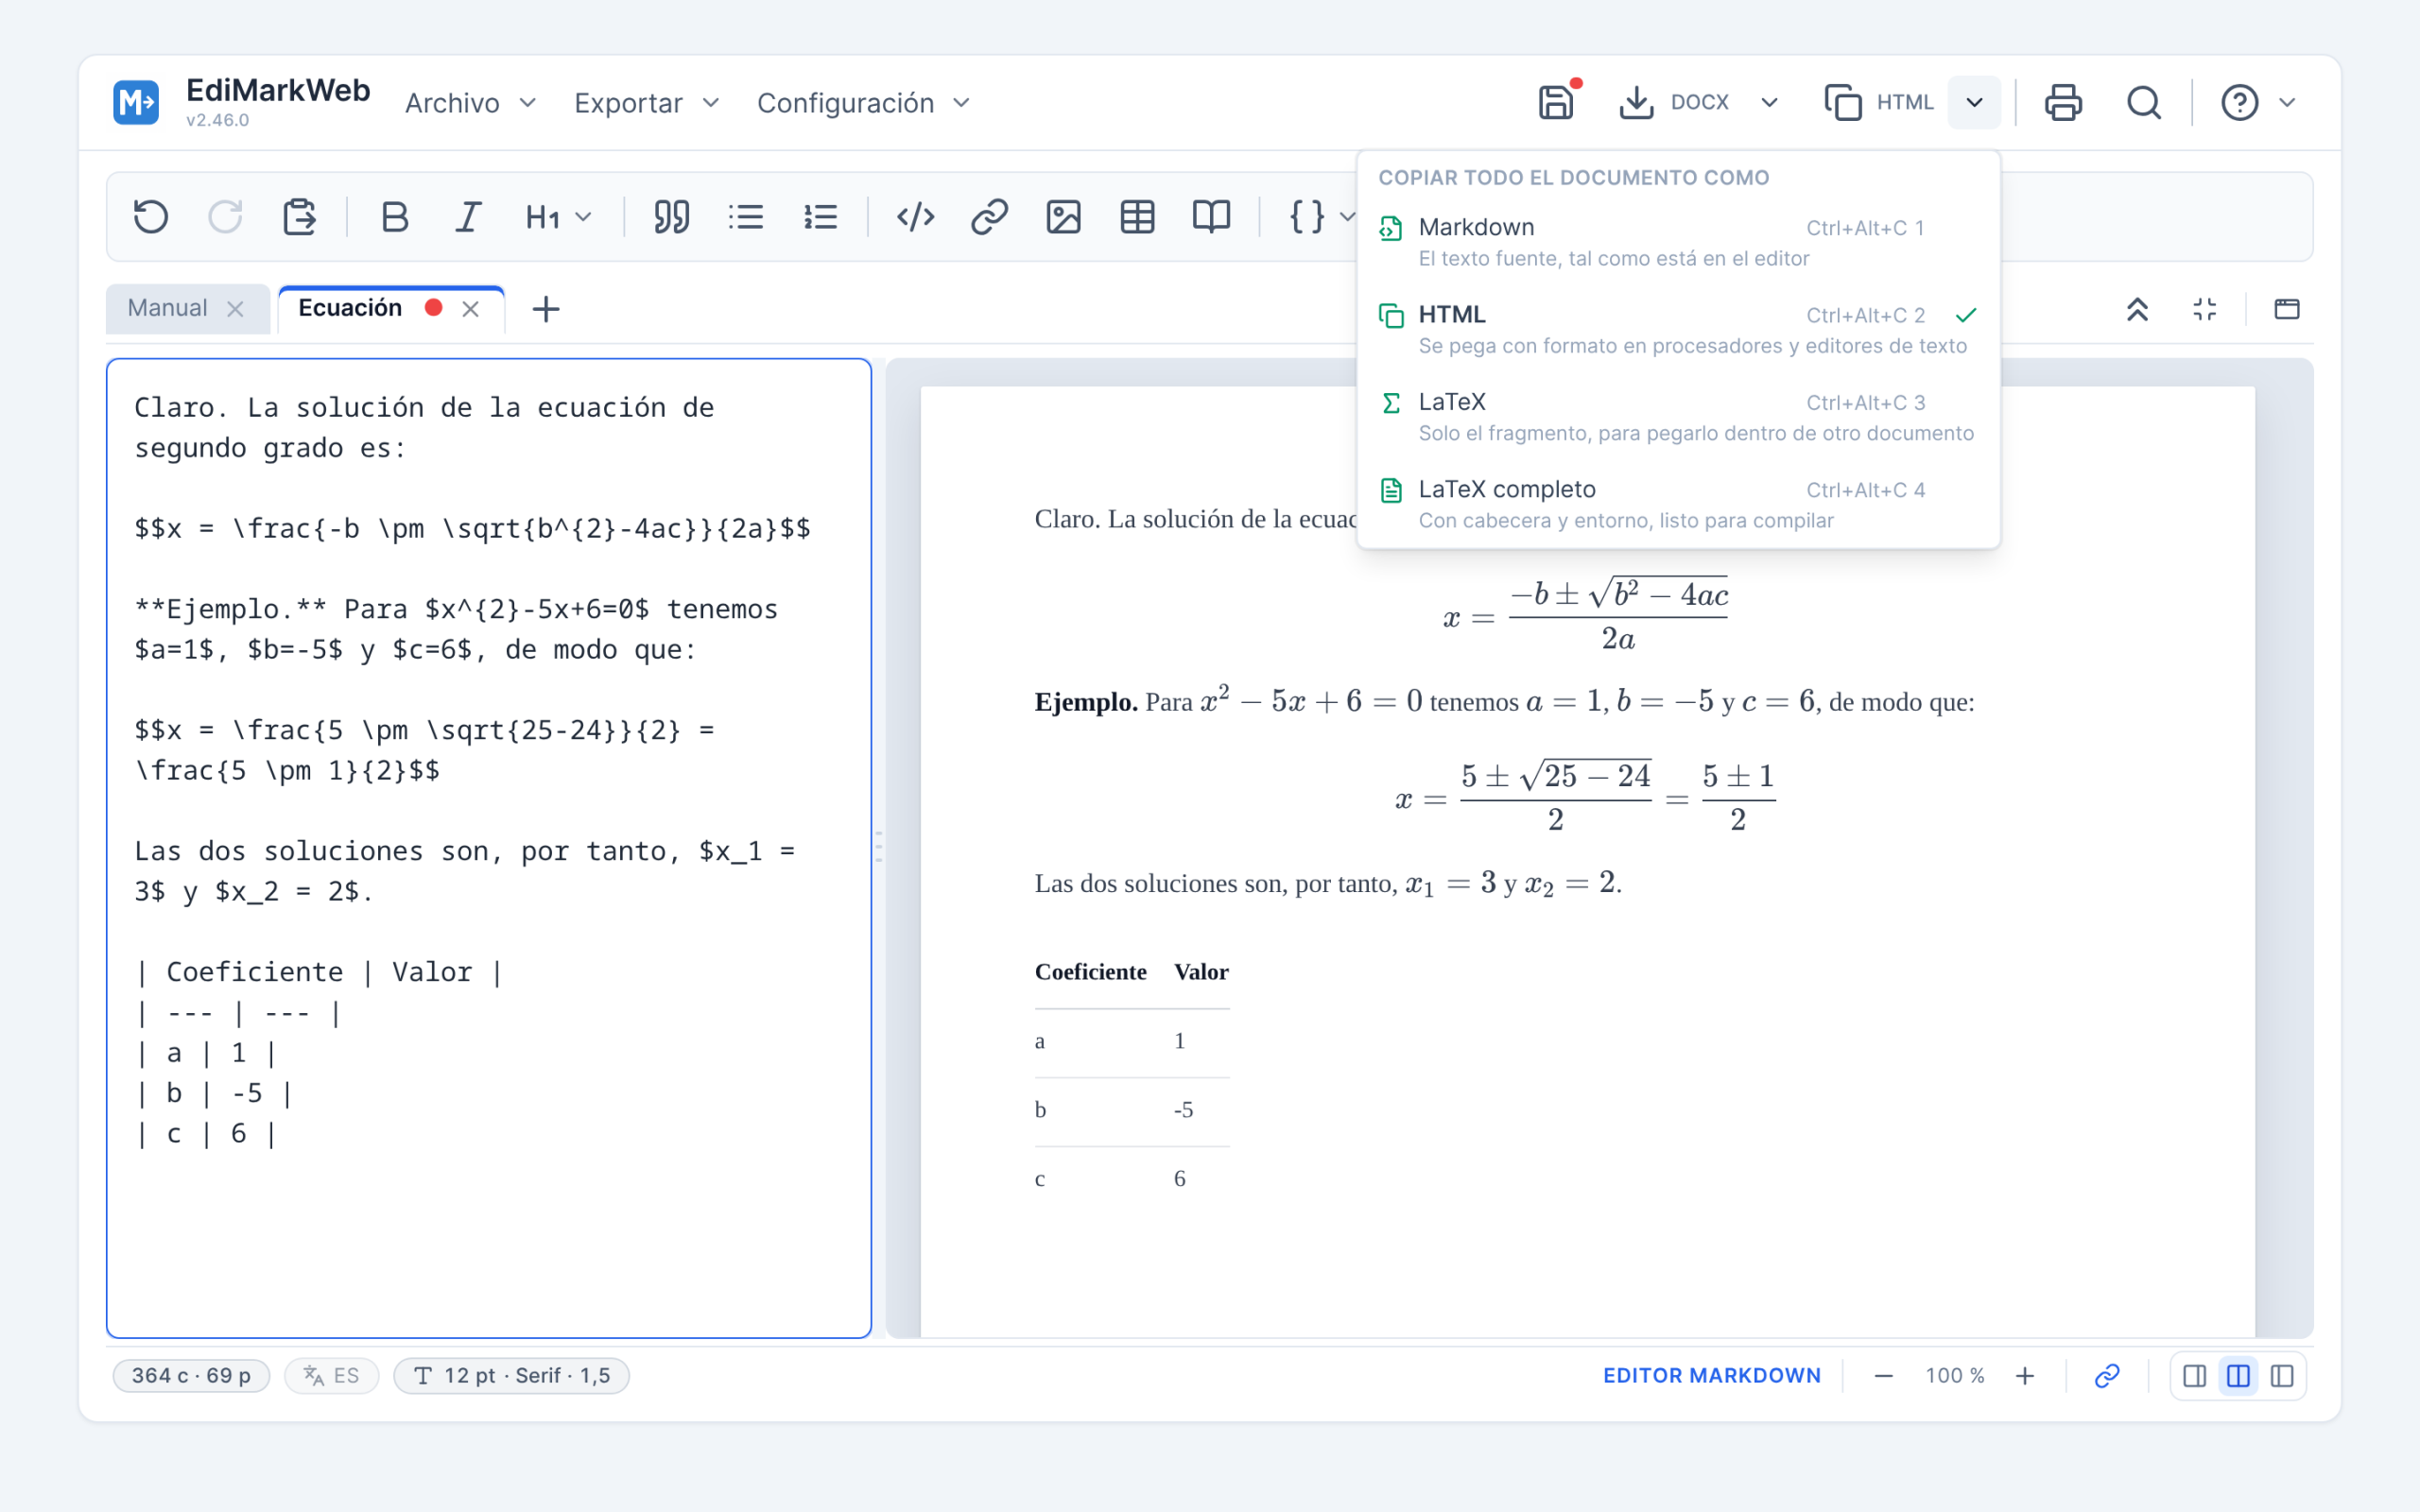
Lo que no llega a ser archivo. El botón de copiar hace lo mismo que Exportar con otro destino, el portapapeles, y ofrece cuatro formatos: Markdown, HTML, LaTeX y LaTeX completo. El útil para el trabajo diario es el HTML, porque pega el documento con su formato en Word, LibreOffice, Google Docs o el correo, con los encabezados, las negritas, las listas y las tablas ya compuestos, sin pasar por ningún archivo intermedio. Dos advertencias: las fórmulas se pegan como texto, así que para llevarlas como ecuaciones hay que exportar a DOCX u ODT, y las imágenes solo viajan si están incrustadas en el documento.
Citas y bibliografía

Las citas y la bibliografía son la incorporación más reciente y amplían el uso del programa más allá de la preparación de materiales de clase: sirven igualmente para una memoria, un artículo o un trabajo de fin de grado.

Se carga una biblioteca en BibTeX (.bib) o CSL JSON (.json), los dos formatos que exportan Zotero, Mendeley y Google Académico, y a partir de ahí las citas se insertan desde un cuadro que busca por autor, título, año o clave. Quien no tenga todavía una biblioteca puede cargar la de ejemplo, con siete referencias completas, o escribir las suyas a mano: el formulario admite artículos, libros, capítulos, informes, páginas web, tesis y comunicaciones, con los campos propios de cada tipo, y la clave de cita se genera sola con el apellido, el año y una palabra del título.
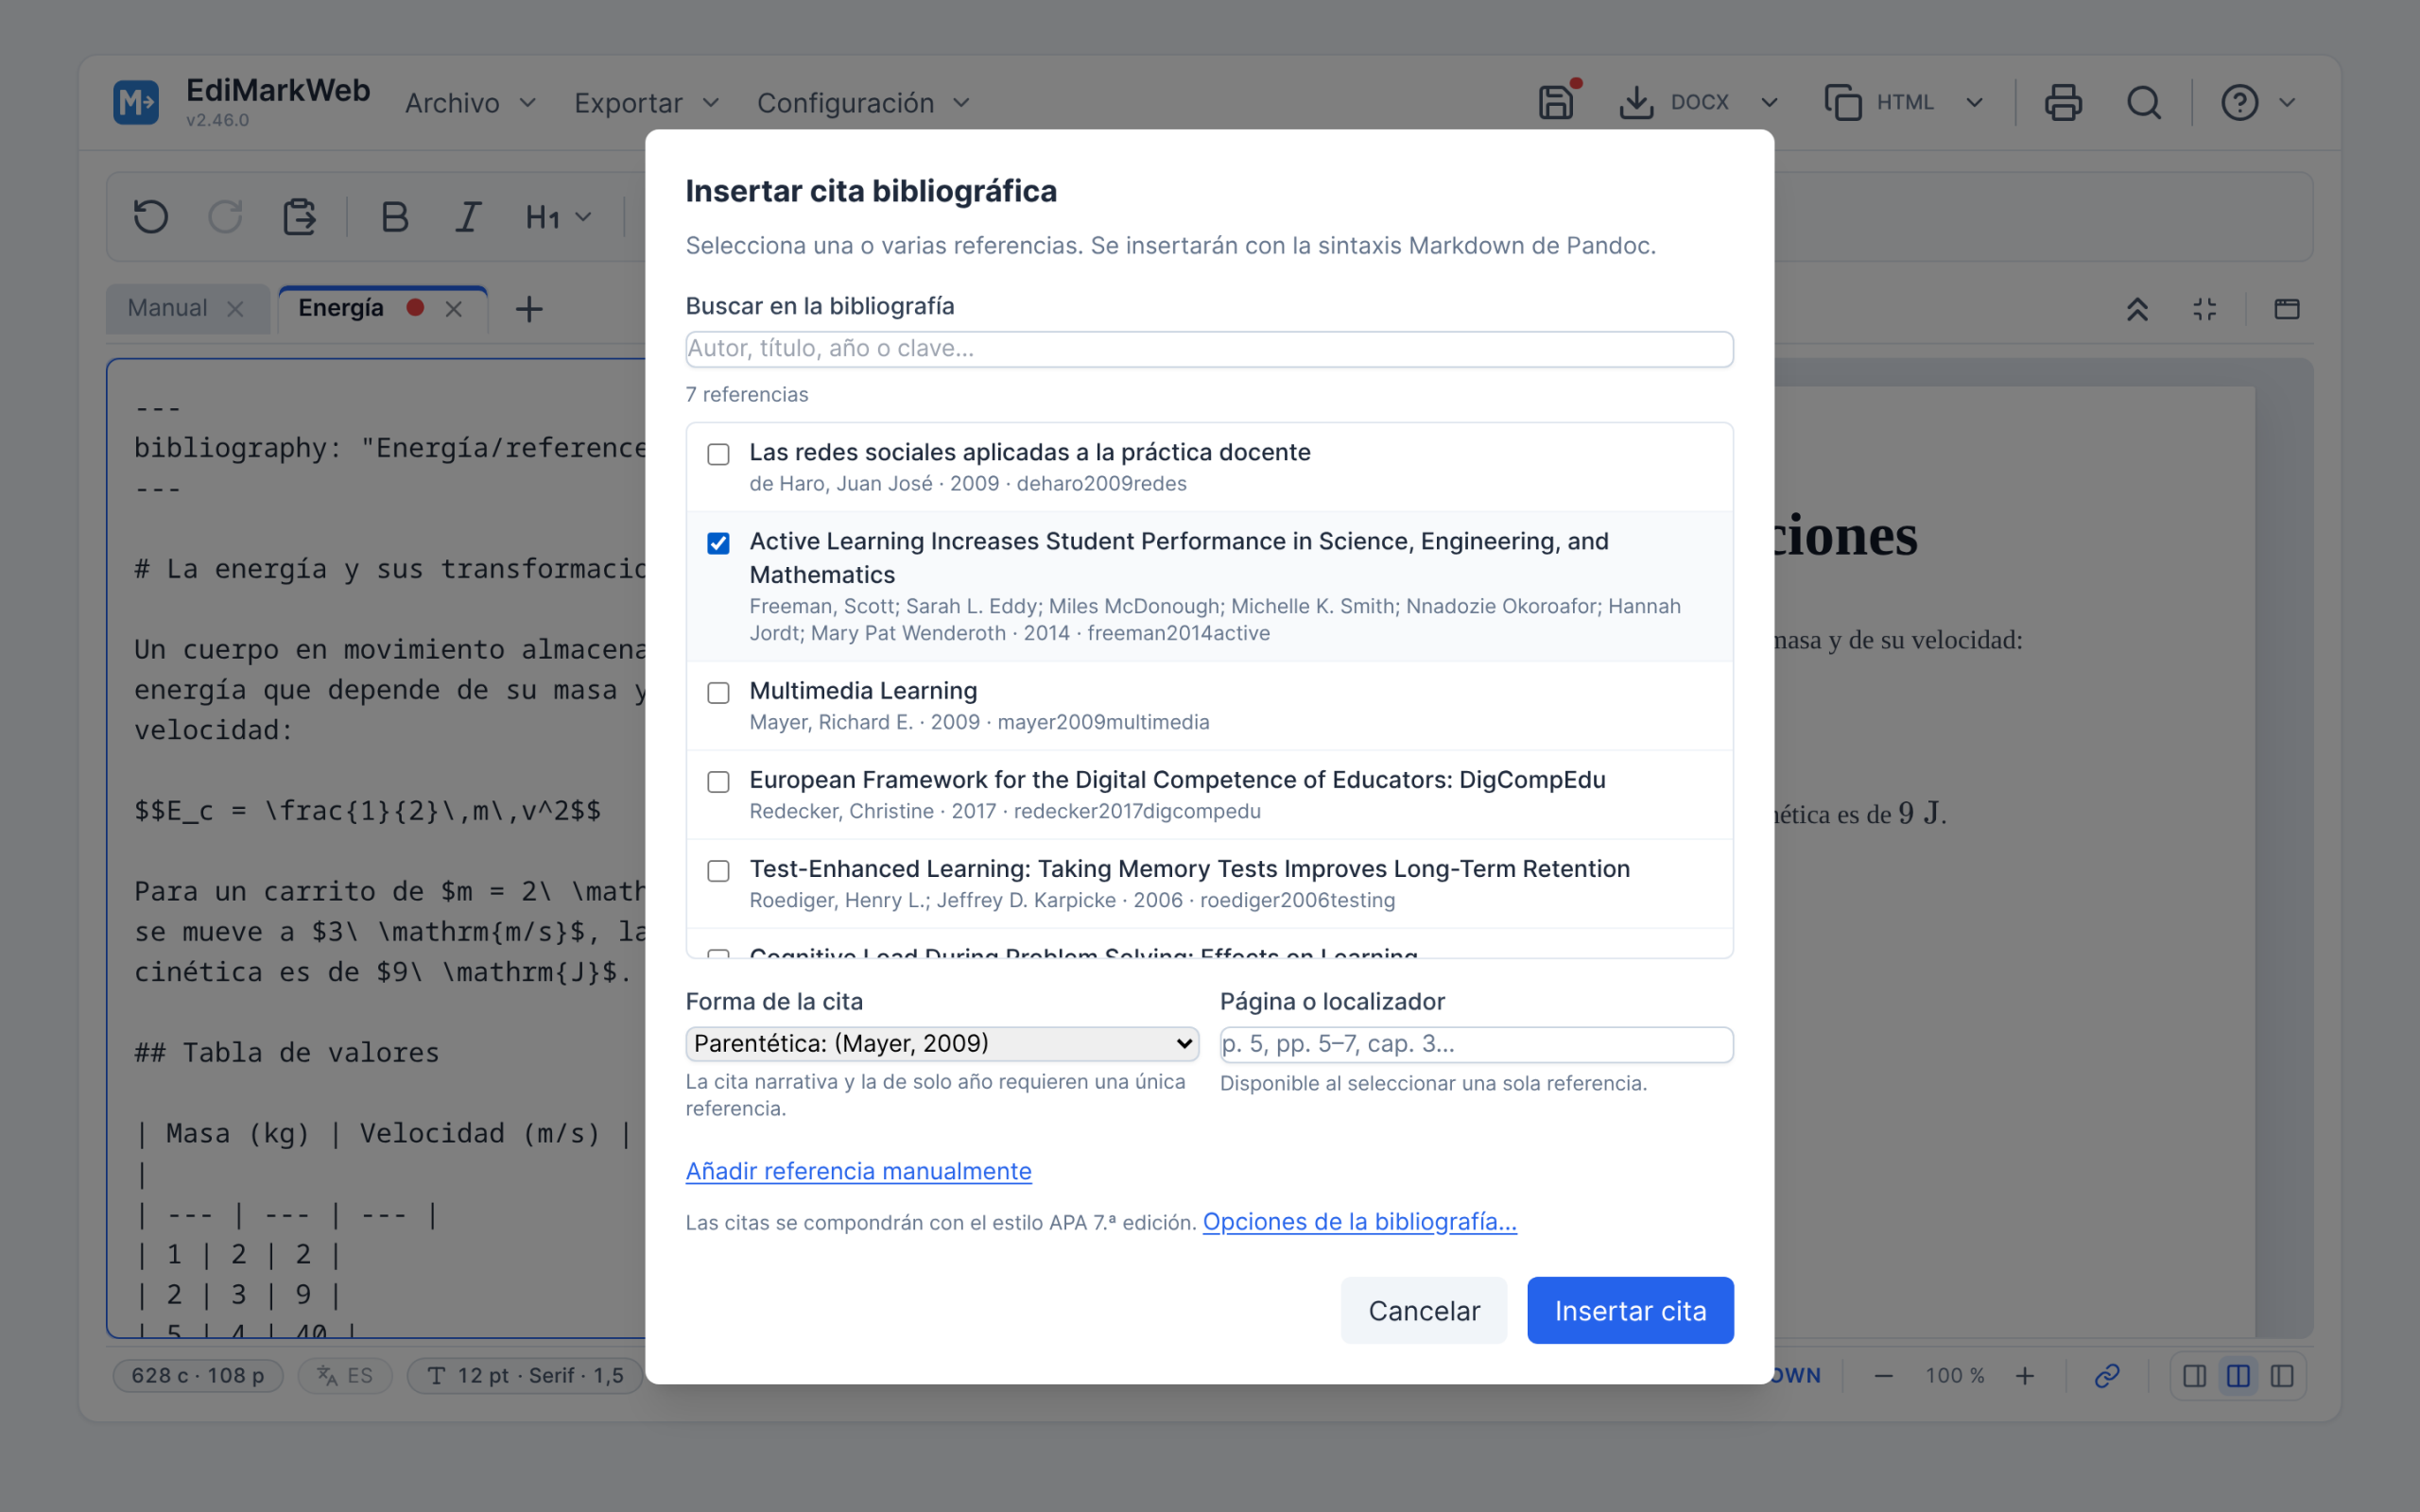
En el texto queda una marca corta, [@freeman2014active], y de ella salen la cita compuesta y la lista de referencias del final, ordenada por apellidos. El estilo inicial es APA 7; también hay Chicago autor-fecha, MLA 9 e IEEE, y se puede cargar un archivo CSL propio, que es como se ajustan las normas de una revista o de una universidad concreta.
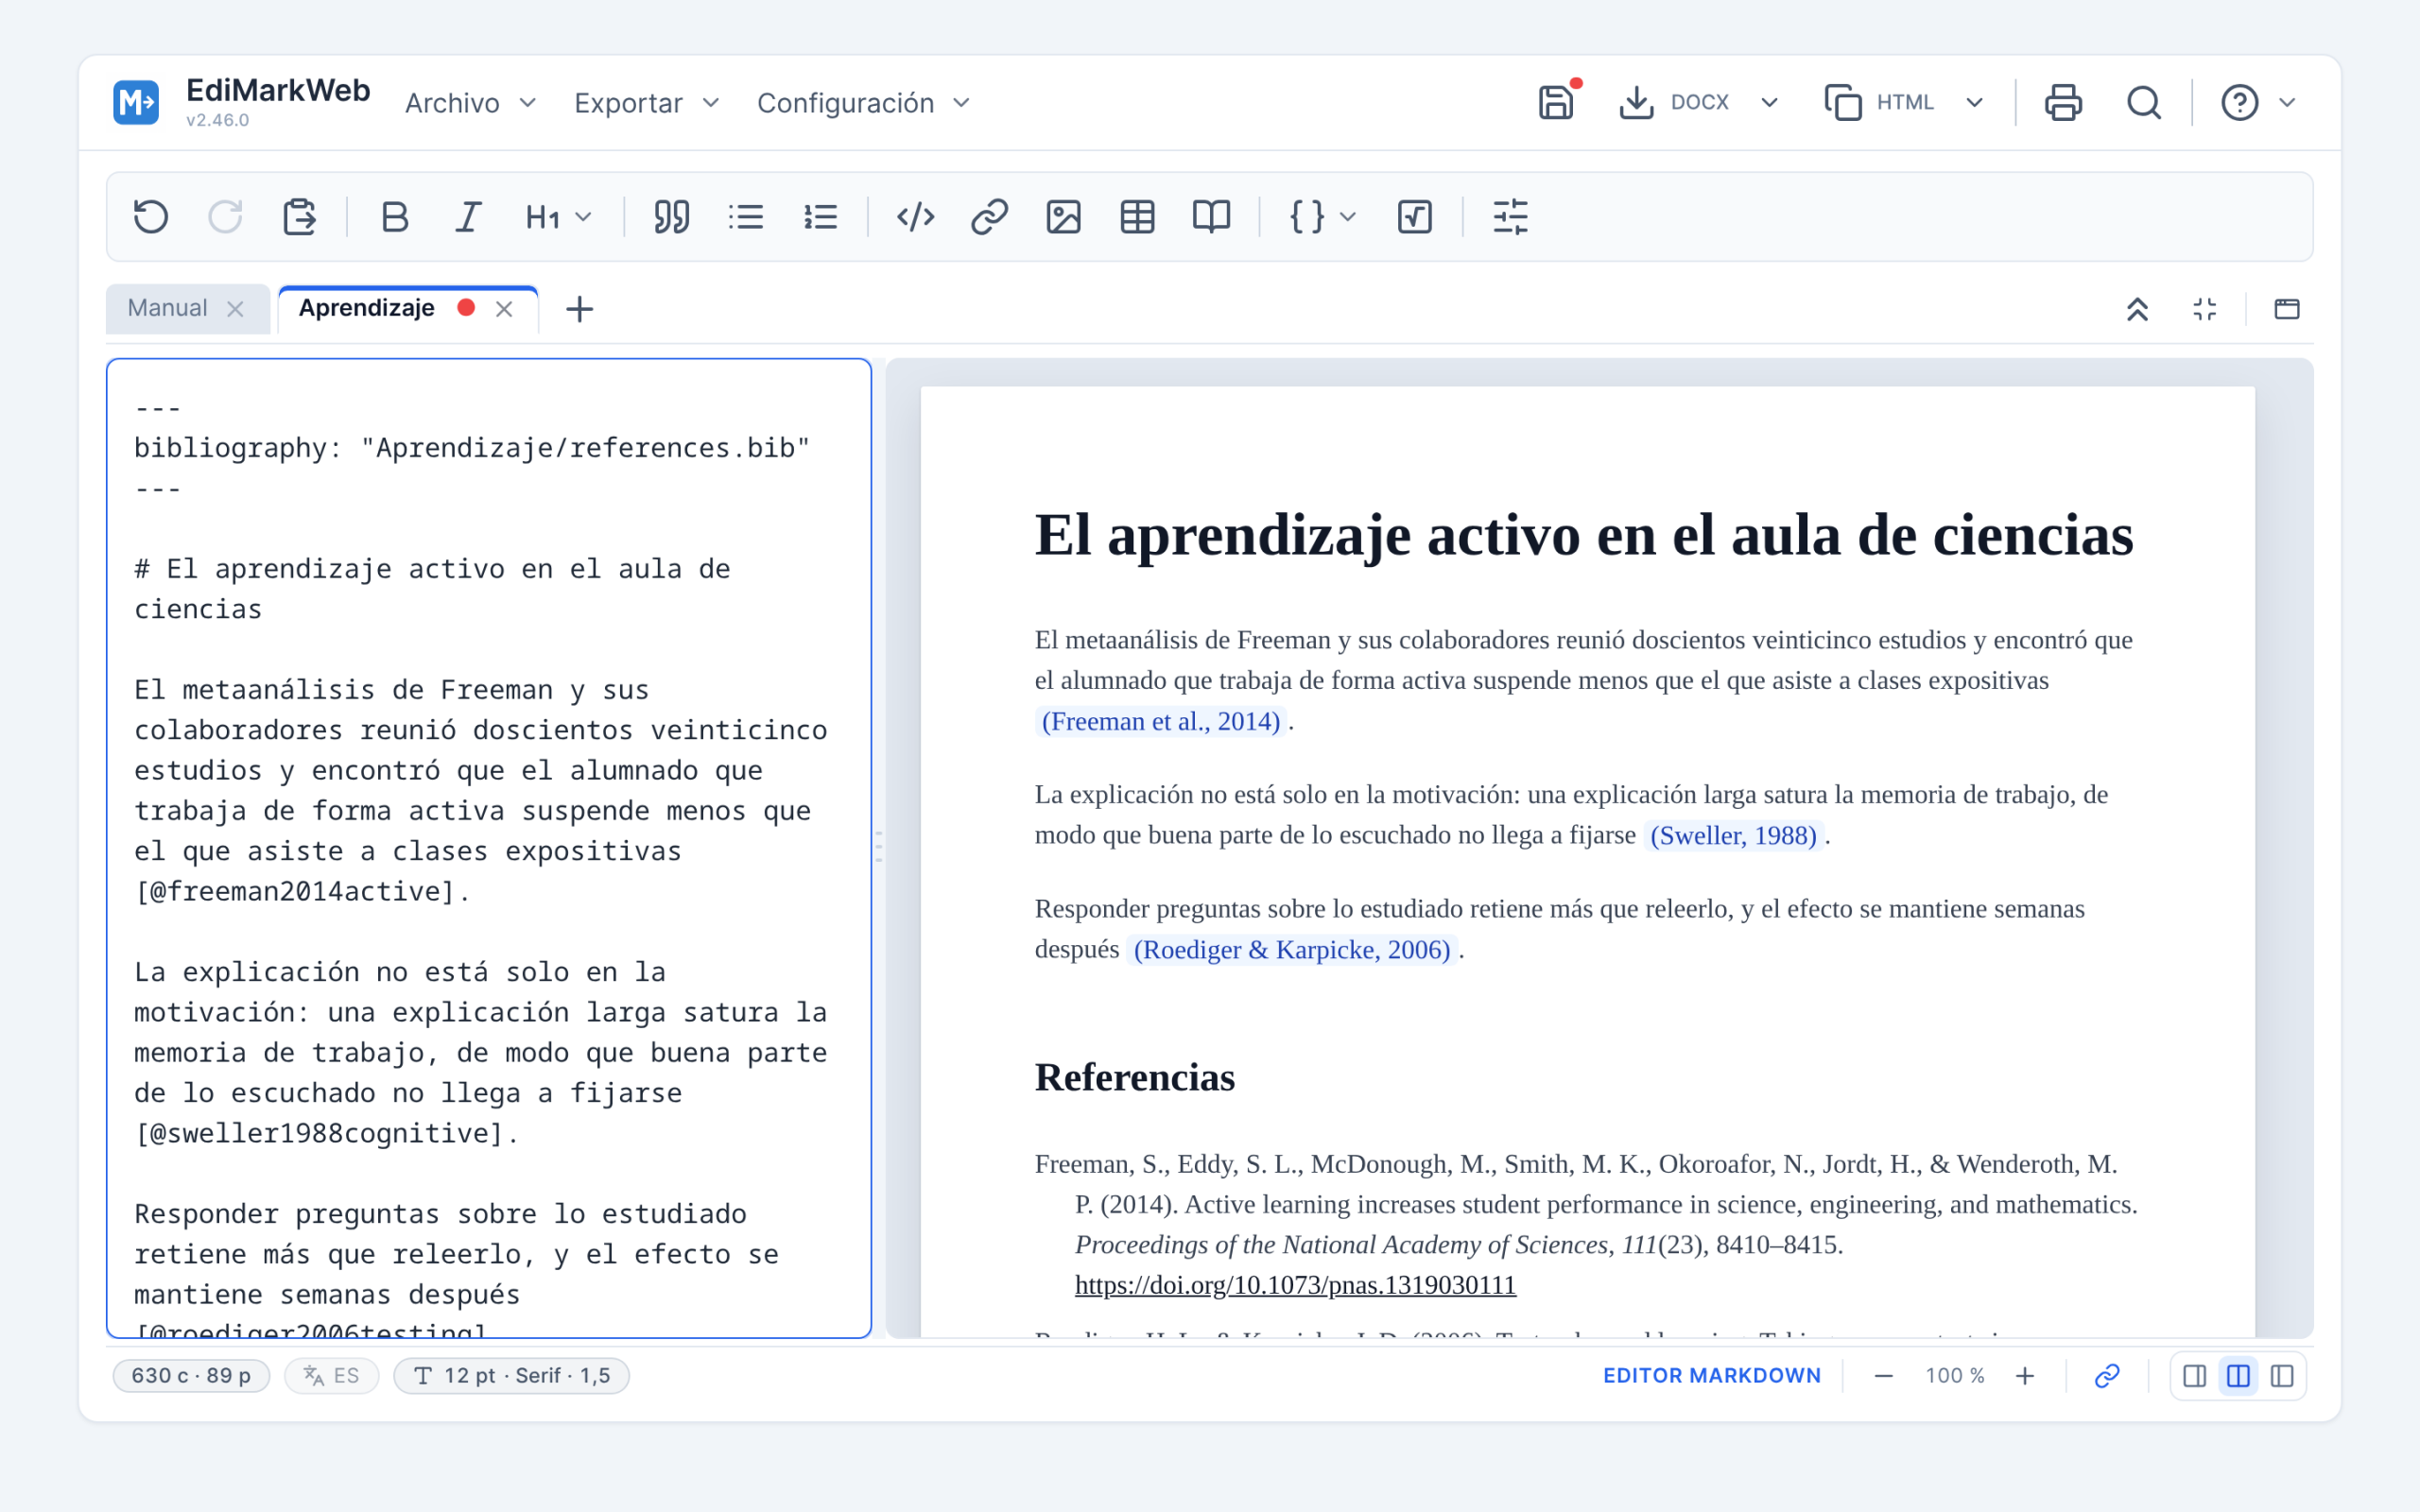
Al guardar, la biblioteca y el estilo se copian junto al documento, en su carpeta, y quedan declarados dentro del archivo. Es lo que permite abrir el mismo trabajo en otro ordenador y que las citas se compongan igual.

Cada documento, con su formato

Los ajustes de salida están reunidos en Configuración → Opciones generales…, que es lo que antes se llamaba opciones de exportación. Son cinco pestañas: los datos y el índice (idioma, autor, numeración de apartados, profundidad), el texto y la página, la portada del EPUB, las citas y, para quien use LaTeX, la clase del documento, sus opciones y un preámbulo propio.
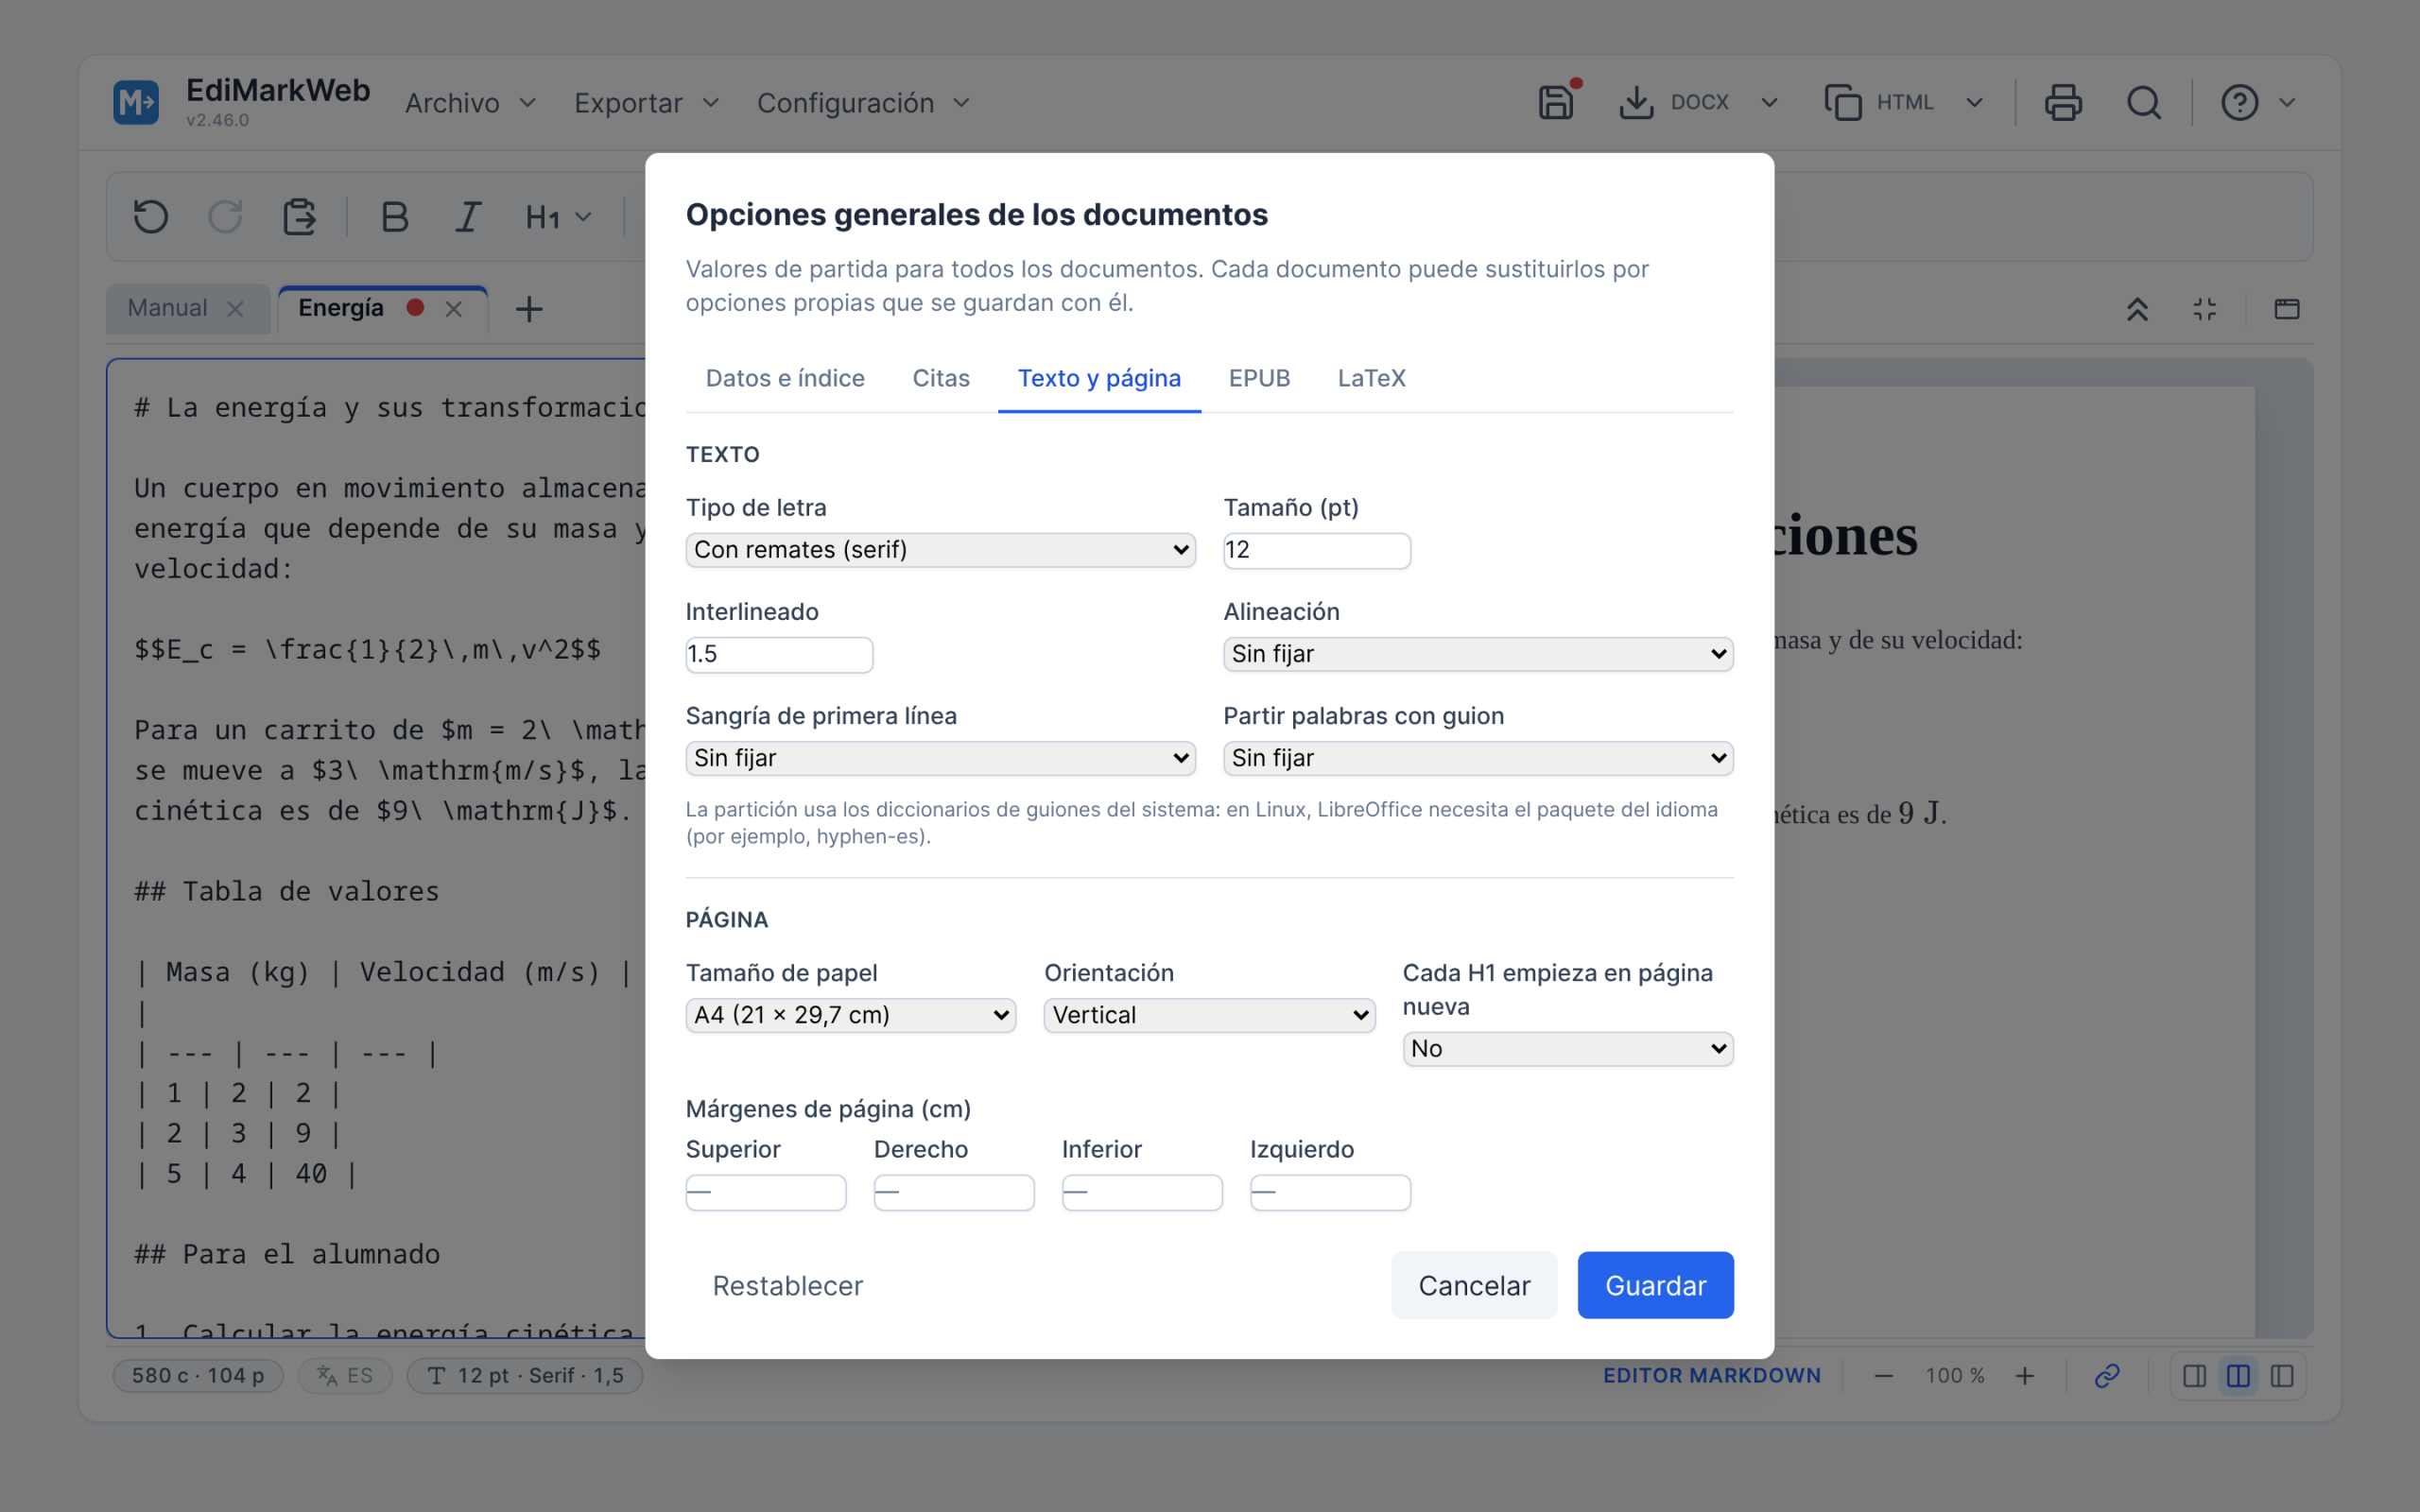
La pestaña de texto y página reúne lo que suele obligar a retocar el documento una vez exportado: la alineación, el tipo y el tamaño de letra, el interlineado, el tamaño de papel, la orientación, los márgenes de los cuatro lados, la sangría de primera línea y la partición de palabras con guion. Se aplica a la hoja que se está viendo y a todos los formatos de salida, de modo que el DOCX y el ODT salen ya con la caja y la tipografía que se quieren.

No es necesario que todos los documentos compartan esos ajustes. Cada uno puede llevar los suyos, junto con su idioma, su autor y su decisión sobre el índice, en el cuadro Opciones de este documento, que se abre desde la propia barra de estado. Se guardan dentro del archivo, en unas líneas de metadatos al principio, así que viajan con él: un manual quiere índice numerado y una nota de dos párrafos no, y cada uno lo lleva escrito.
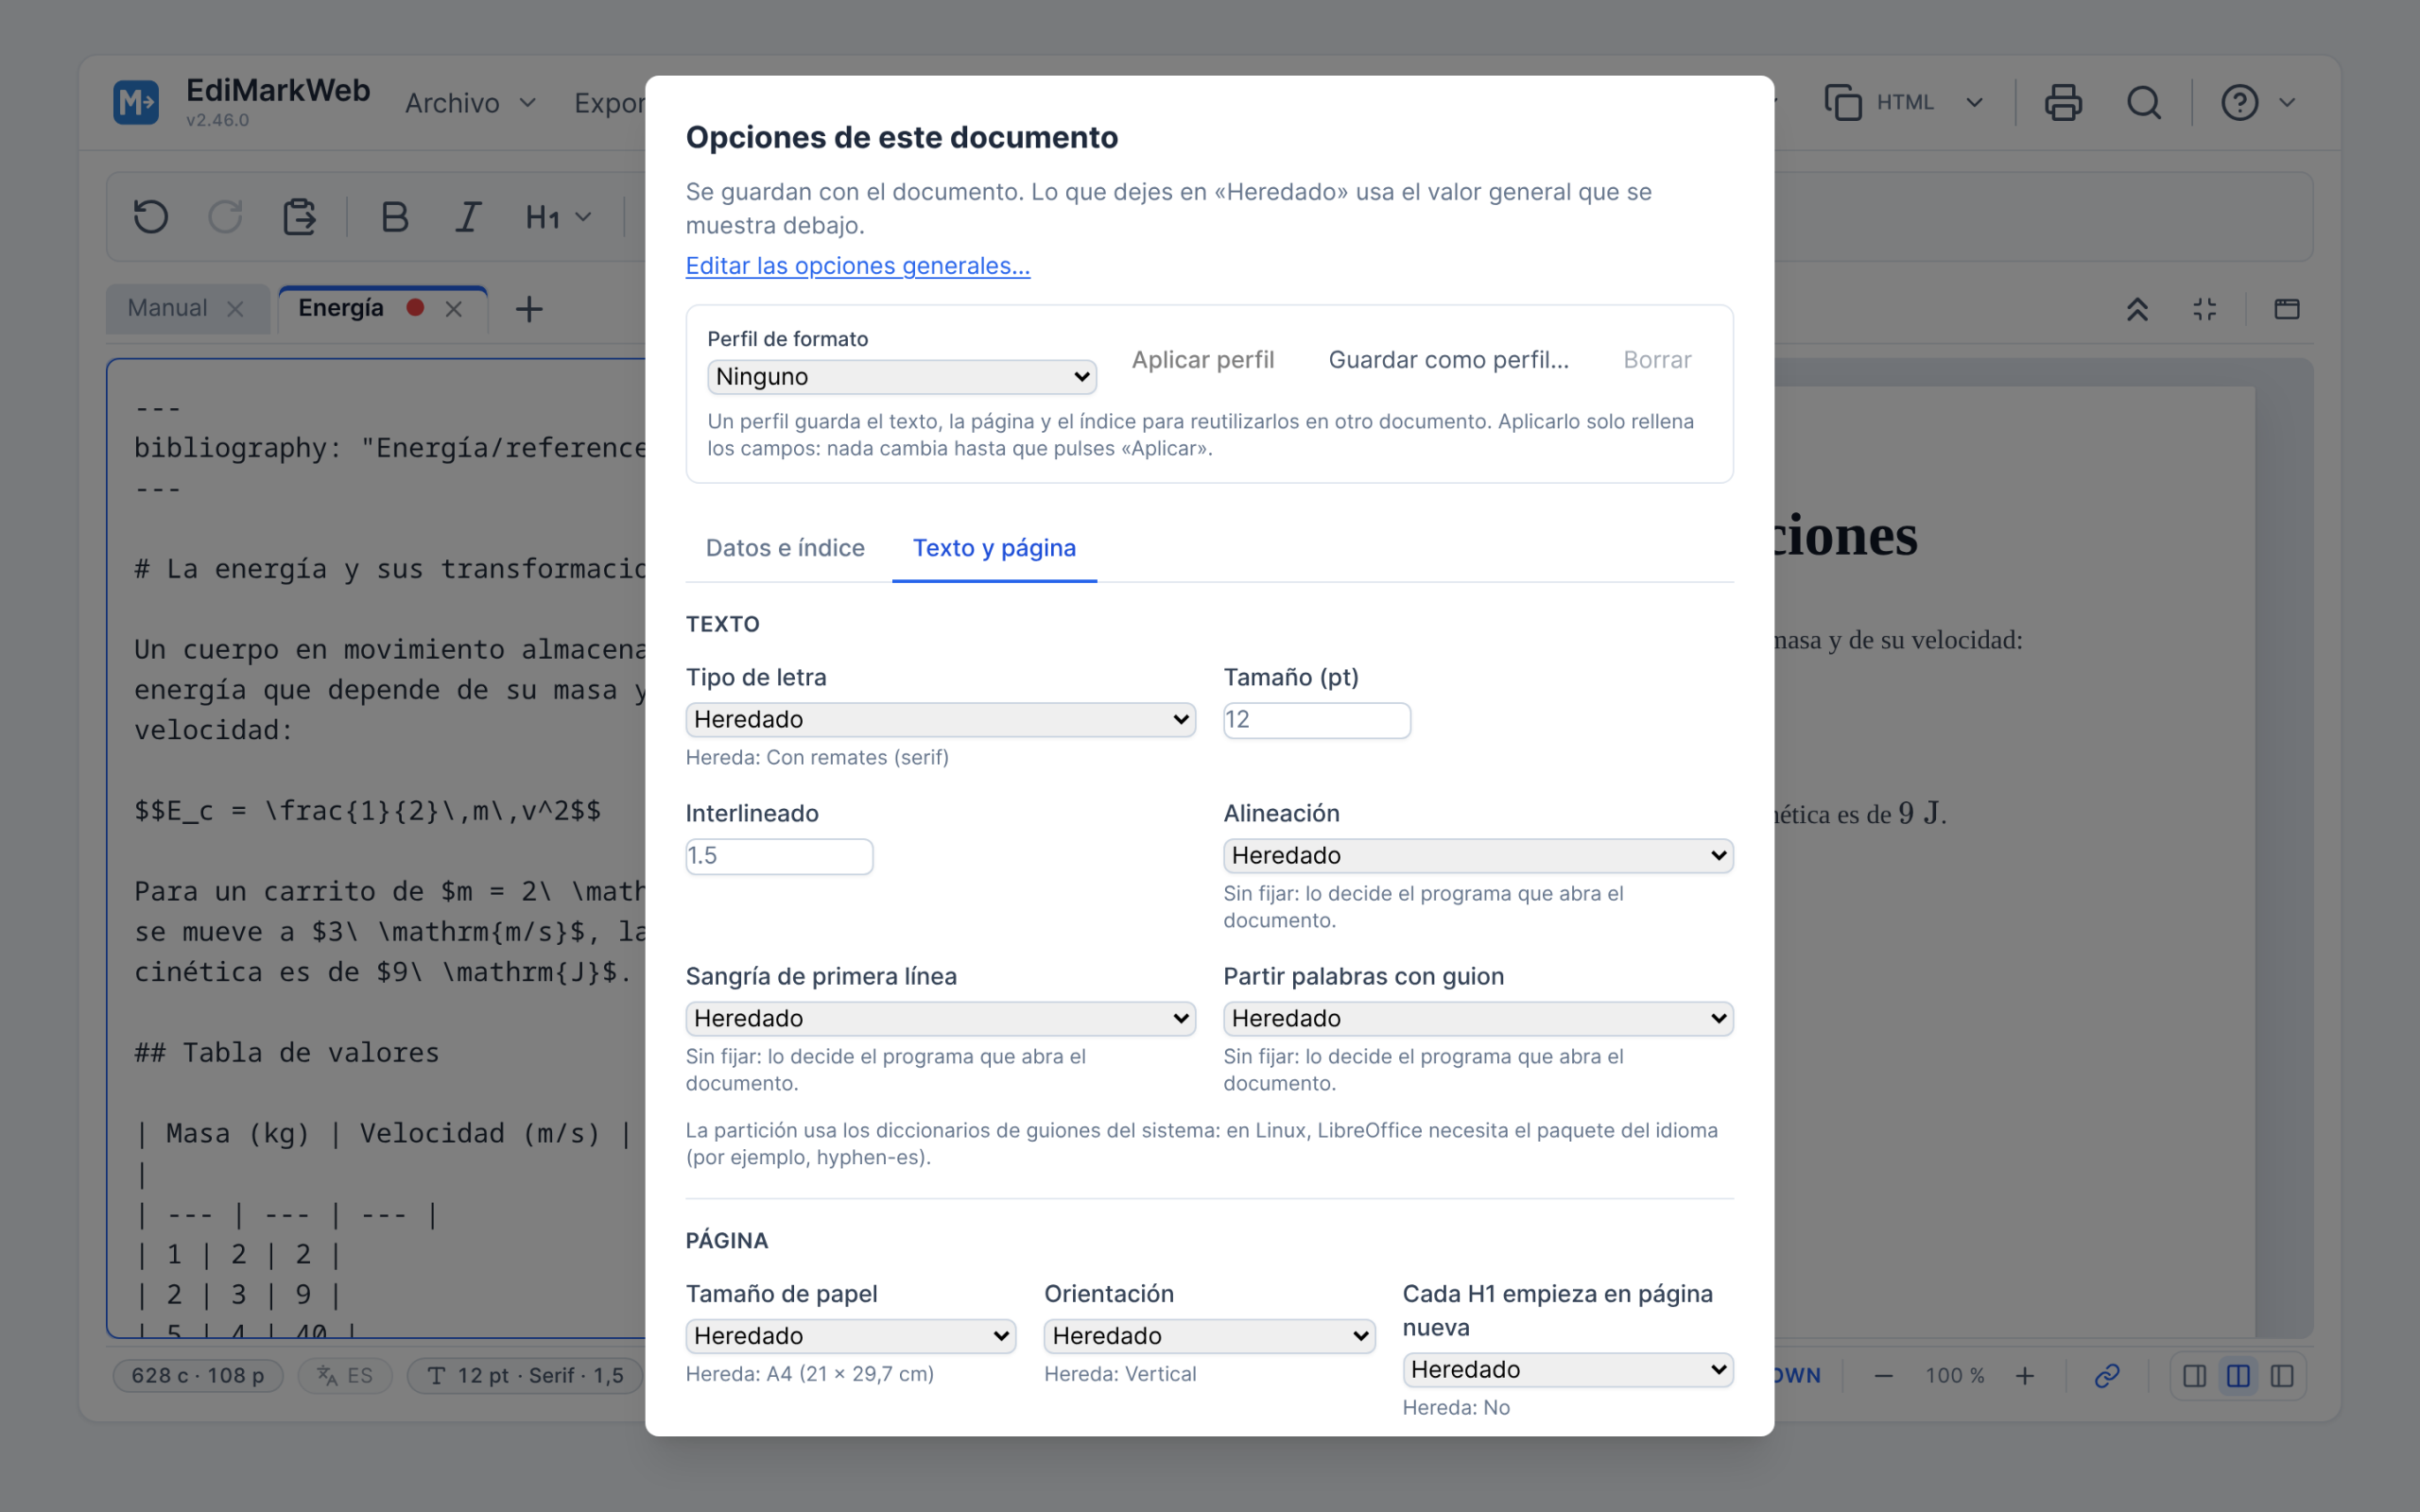
Un detalle que suele dar problemas es el idioma. Cada documento puede llevar el suyo, guardado dentro del propio archivo, y todos los formatos de salida lo declaran. Eso es lo que evita que Word y LibreOffice subrayen en rojo un texto castellano por corregirlo en inglés, y lo que hace que LaTeX parta bien las palabras.

Las imágenes y la carpeta del documento

Una imagen se puede insertar de dos maneras: incrustada en el propio archivo, que se vuelve autónomo pero mucho más pesado, o con ruta relativa, que es lo recomendado y lo que hace cualquier editor de Markdown. En ese caso el documento y sus imágenes viajan juntos: al guardar mi-archivo.md se crea al lado una carpeta mi-archivo con las imágenes dentro y, si hay bibliografía, también con ella y con el estilo. Basta conservar los dos para llevarse el trabajo a otro ordenador.

Bajo el editor Markdown, una lista reúne todas las imágenes del documento, las incrustadas y las enlazadas. Desde ahí se ven, se reemplazan (por una del disco, del portapapeles o de una dirección web) y se quitan del texto, y las enlazadas se pueden incrustar. Existe también la operación inversa: las incrustadas se extraen del archivo y quedan como imágenes dentro de la carpeta.

En la aplicación de escritorio las imágenes con ruta relativa se encuentran solas. En el navegador no, porque ninguna página puede leer una carpeta sin permiso: aparece un aviso con un botón para señalarla y, hecho una vez, se ven todas.

En el navegador o instalado

La versión web no necesita instalación y basta para la mayoría de los casos. La aplicación de escritorio, para Linux, Windows y macOS, es la misma (los mismos menús, los mismos atajos, los mismos formatos) y añade lo que solo puede hacer un programa instalado: abrir los archivos .md con doble clic, guardar sobre el documento original sin pasar por la carpeta de descargas, usar el corrector ortográfico del sistema y funcionar sin conexión, porque lleva dentro las herramientas de conversión. También avisa cuando hay una versión nueva y la instala.

En el navegador, con todo, guardar ha dejado de ser una descarga: Chrome y Edge abren el diálogo del sistema para elegir el nombre y la carpeta, y recuerdan el archivo, así que la siguiente vez Ctrl+S escribe encima como en la aplicación de escritorio. Firefox todavía no admite esa forma de guardar y sigue descargando el archivo.

EdiMarkWeb es software libre, con licencia AGPL v3, y su código está en GitHub, junto con los instaladores de la aplicación de escritorio y el manual de uso, disponible también dentro del programa con F1.

Límites conocidos

Conviene tener presentes algunas limitaciones antes de emplearlo en un trabajo extenso. El índice de un DOCX o un ODT es un campo que calcula el procesador de textos, así que el documento se abre con la lista de apartados pero sin números de página hasta que se actualiza (en Word, botón derecho sobre el índice y Actualizar campos). En el EPUB los márgenes son una sugerencia, porque manda el lector de libros. La partición de palabras necesita los diccionarios de guiones del sistema. Y el reparto en páginas que se ve en pantalla es exacto para el PDF y la impresión, pero solo orientativo para Word y para LaTeX, que componen las líneas a su manera.

Para qué sirve en la práctica

El destinatario natural es el profesorado que prepara materiales con fórmulas y los tiene que entregar en formatos distintos: los apuntes en PDF, el examen en Word para el departamento (o en Google Docs, que abre ese mismo archivo), la misma unidad convertida en página web para el aula virtual y, si se quiere, en libro digital para leerlo en una tableta. Todo eso sale de un único archivo de texto que se puede corregir el curso que viene sin volver a maquetar nada. Con la bibliografía se añade un trabajo que hasta ahora se hacía en otra parte: la memoria, el artículo o el trabajo de fin de grado, con sus citas y su lista de referencias en la norma que se exija.

Sirve también para lo contrario: recuperar el material que ya existe. Un documento de Word de hace años se abre aquí, se convierte en texto limpio y vuelve a salir por el formato que se necesite. Y, sobre todo, para conservar lo que ha respondido la inteligencia artificial, en un archivo propio y en un formato que se pueda entregar.

Vídeo del artículo realizado por Gemini Notebook

Nota: Este artículo tiene nivel 5 en el Marco para la integración de la IA generativa.
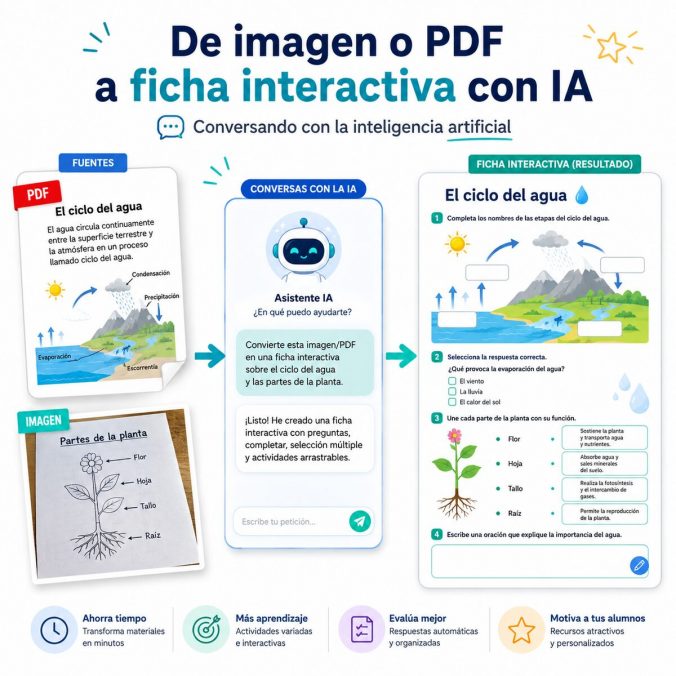
Convertir una imagen o PDF en una ficha interactiva hablando con la IA

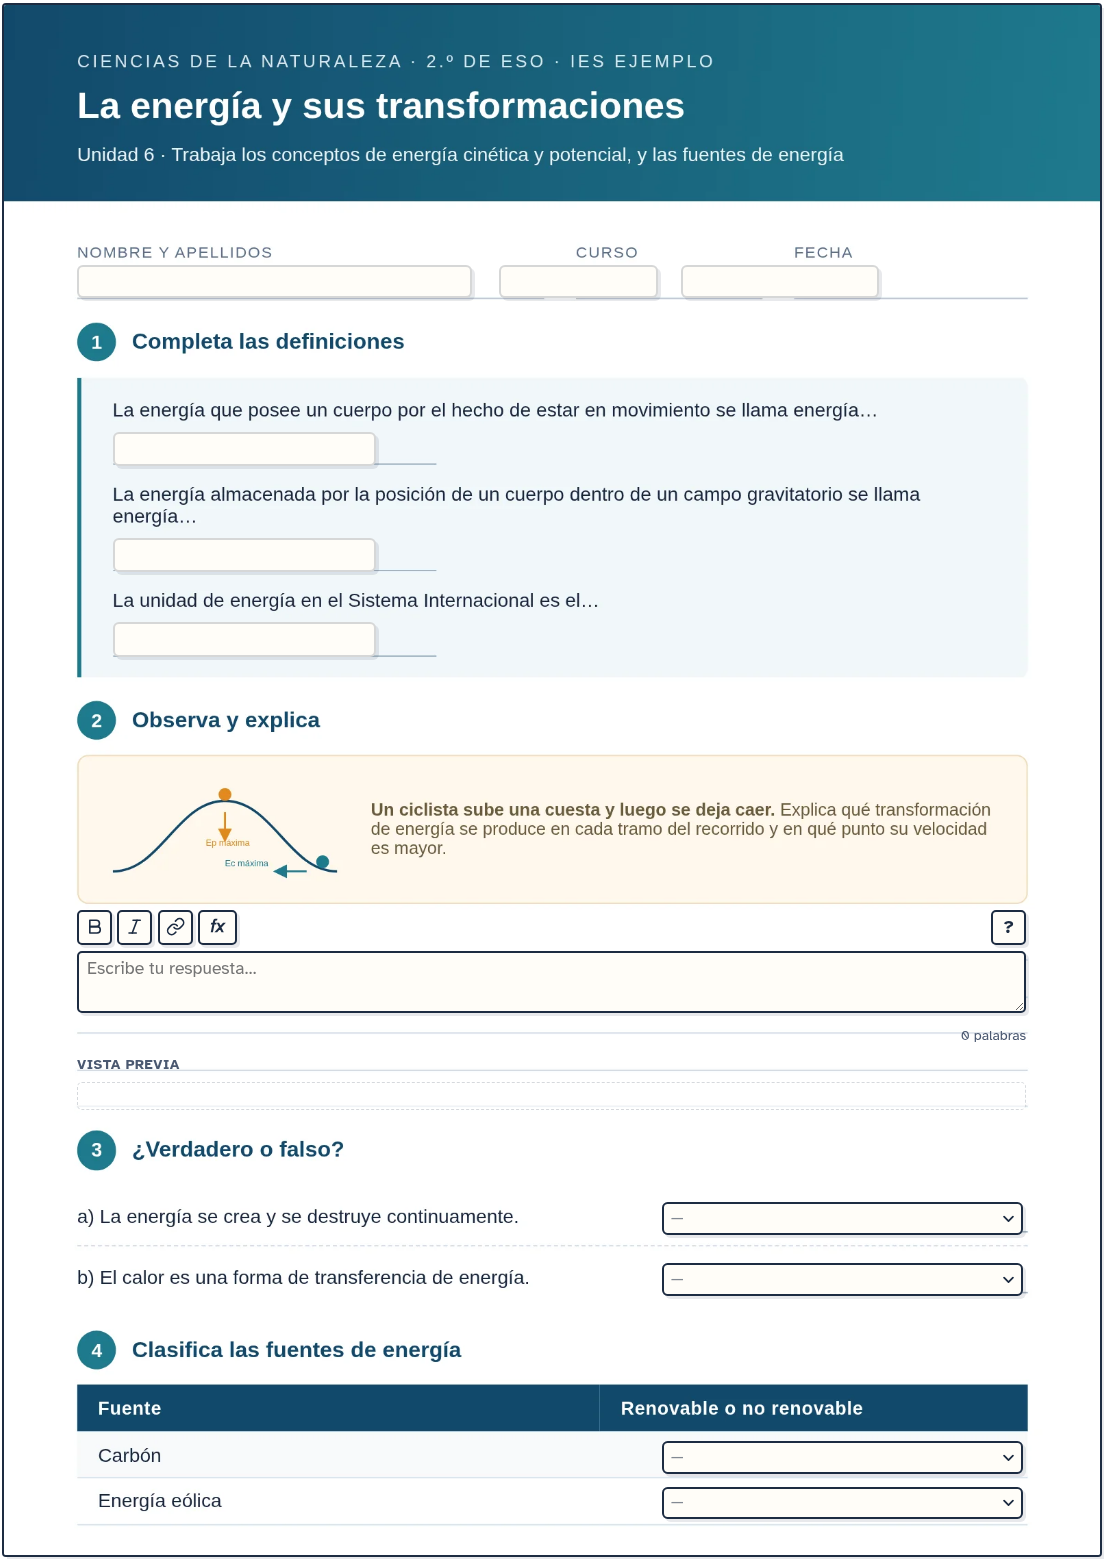
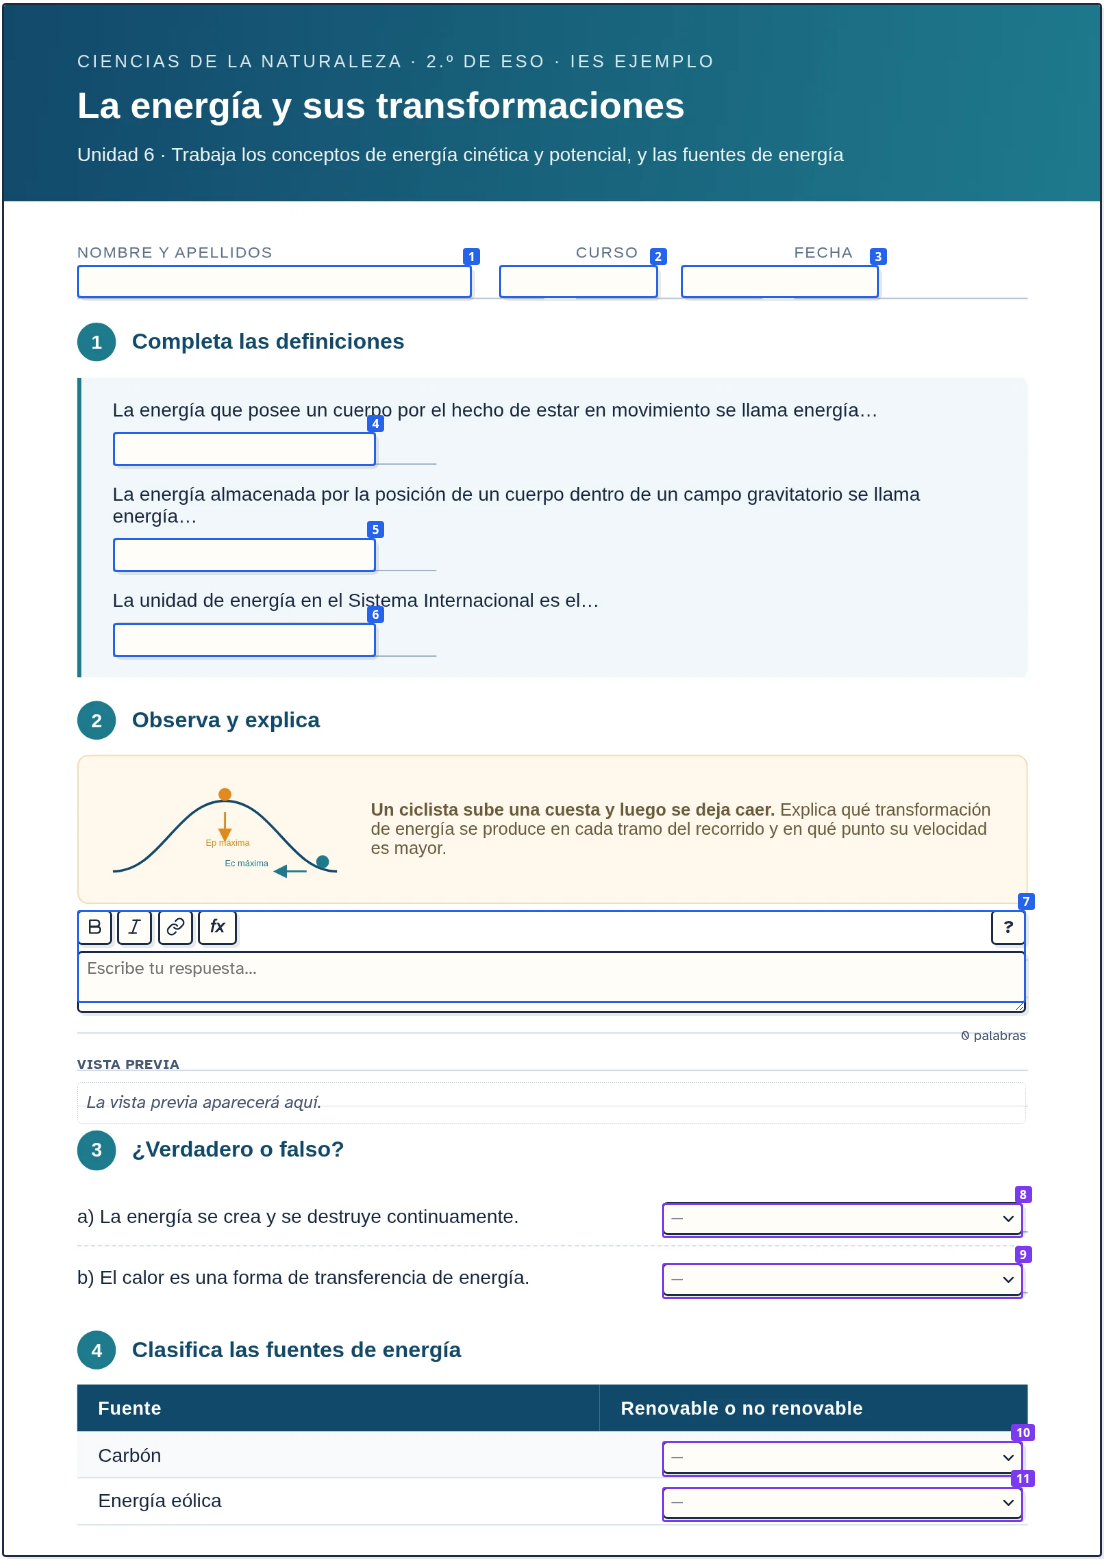
Hacer una ficha interactiva a partir de un PDF tiene dos partes. Una es decidir qué se pregunta. La otra es colocar los campos: abrir el documento, dibujar una caja encima de cada línea de puntos, ajustar el tamaño, escribir la solución, repetirlo veinte veces y descubrir al final que un campo tapa el enunciado siguiente.

Desde la versión 1.29, OpenWorksheets puede hacer ese trabajo por nosotros. No con un botón dentro de la aplicación, sino desde la conversación con la inteligencia artificial que ya usemos: se le dice dónde está el PDF y ella lo abre, lee la página, coloca los campos donde tocan, mira cómo ha quedado y guarda la ficha lista para abrir en el editor. Y no solo convertir: si no partimos de ningún documento, podemos pedirle la ficha entera sobre un tema, y la escribe sobre hojas en blanco.

«Convierte en ficha interactiva de OpenWorksheets este PDF: energia.pdf»

Este artículo explica qué es lo que hace posible eso (un servidor MCP), qué se le puede pedir, qué hace falta para instalarlo y, sobre todo, dónde están sus límites, que los tiene.

Pódcast del artículo realizado por Gemini Notebook

Qué es un servidor MCP

Una IA de las de conversar sabe redactar preguntas, pero no puede abrir un archivo de nuestro disco ni escribir uno. Vive dentro de su ventana de chat. El MCP (Model Context Protocol, «protocolo de contexto del modelo») es el estándar que le da manos: un programa pequeño que se instala en el ordenador y le ofrece a la IA una lista de operaciones concretas que puede ejecutar.

El servidor MCP de OpenWorksheets ofrece las operaciones propias para fabricar una ficha: abrir un PDF, leer el texto de una página con las coordenadas de cada línea, colocar campos de respuesta, tapar una zona, ver el resultado y guardar el paquete .owpkg. La IA decide qué preguntar y dónde ponerlo; el servidor hace el trabajo material y le dice cuándo se está equivocando.

Que sea un programa local tiene una consecuencia práctica: el archivo no se sube a ningún servicio. El PDF se abre en nuestro ordenador, las páginas se dibujan ahí y la ficha se guarda ahí, sin pasar por ninguna web de conversión.

Conviene no confundir eso con privacidad total, porque no lo es. La IA con la que hablamos sí ve el contenido: para colocar los campos necesita el texto de las páginas, y para comprobar el resultado necesita mirar la imagen de la ficha. Ambas cosas viajan a los servidores de quien preste el servicio (Anthropic, OpenAI, Google, etc.), igual que si pegásemos el documento en el chat. Con datos personales del alumnado, o con material que no deba salir del centro, hay que tenerlo presente. La única forma de que no salga nada es usar un modelo que corra en el propio ordenador, con LM Studio, aunque de momento lo usa muy poca gente, sobre todo porque necesita de un ordenador muy potente para poder funcionar de forma fluida.

Formas de hacer una ficha

Sobre un documento propio. Es el caso para el que nació. Partimos de un PDF o de una imagen (un examen antiguo, una ficha fotocopiada, un esquema) y los campos se colocan encima, cada uno en su sitio, respetando el diseño original. El alumnado ve el documento de siempre, pero relleno de huecos que podrá completar y que se corrigen solos.

Desde cero, sobre hojas en blanco. Le decimos el tema, el nivel y cuántos ejercicios, y la ficha se escribe entera: enunciado, campo de respuesta, separación y salto de página cuando hace falta. Es lo mismo que ya permitía la opción Crear una ficha con IA de la aplicación, la de copiar un prompt y pegar la respuesta, pero sin copiar ni pegar nada y con una diferencia importante: el servidor valida el formato sobre la marcha, así que si algo viene mal, la IA se entera al momento y lo corrige, en lugar de entregarnos un archivo que no abre.

Las dos formas se mezclan: se puede partir de un PDF y añadir al final tres preguntas nuevas sobre hoja en blanco.

La vista previa es lo que lo hace fiable

Una IA colocando cajas sobre una página, a ciegas, se puede equivocar. Si pone el campo dos centímetros por debajo de donde iba, tapa media palabra del enunciado, deja a la vista la solución impresa en el margen. Por eso el paso importante no es colocar, sino comprobar: el servidor monta la página con el mismo visor que verá el alumnado y le devuelve a la IA una captura de cómo ha quedado, con el contorno y el número de cada campo dibujados encima. Con esa imagen delante, la IA corrige lo que esté desplazado antes de guardar nada.

Qué se le puede pedir

Todo en lenguaje normal, en la conversación, sin tocar la aplicación:

  • «Convierte en ficha interactiva de OpenWorksheets este PDF»
  • «Crea una ficha interactiva de OpenWorksheets con 10 ejercicios y nivel de 1.º de ESO sobre la célula»
  • «El ejercicio 5 prefiero que lo cambies por una pregunta de respuesta múltiple, en lugar de verdadero o falso»
  • «Tapa las soluciones que están impresas al pie de la página»
  • «Enséñame la página 3 antes de guardar»

Los tipos de campo que sabe colocar son casi todos: respuesta corta, numérica, fórmula, respuesta larga, opción única y múltiple, desplegable, verdadero/falso, huecos en el texto, huecos dibujados sobre el documento, casillas, tabla editable, emparejar, ordenar, arrastrar a zonas y grabación de voz.

Qué hace falta

1. Una IA instalada en el ordenador. Esto no se puede hacer desde la web de ChatGPT, de Claude ni de Gemini: el navegador no puede instalar ni ejecutar nada en nuestro equipo. Hacen falta las aplicaciones de escritorio o herramientas de terminal como Claude Code o Codex CLI. Y en las aplicaciones de escritorio de ChatGPT y de Claude no vale el chat de siempre: hay que pedírselo desde su pestaña de código (Codex en ChatGPT, Claude Code en Claude), que es la parte que puede trabajar con archivos y programas. También sirven LM Studio, Antigravity, Cursor y VS Code.

2. Node.js 18 o superior y un navegador basado en Chromium (Chrome, Chromium o Edge). Node es lo que ejecuta el servidor; el navegador, que trabaja sin abrirse ni verse, es lo que dibuja las páginas del PDF y monta la vista previa. Es probable que ya estén instalados; si falta alguno, la propia IA puede encargarse de instalarlo o guiarnos en el proceso.

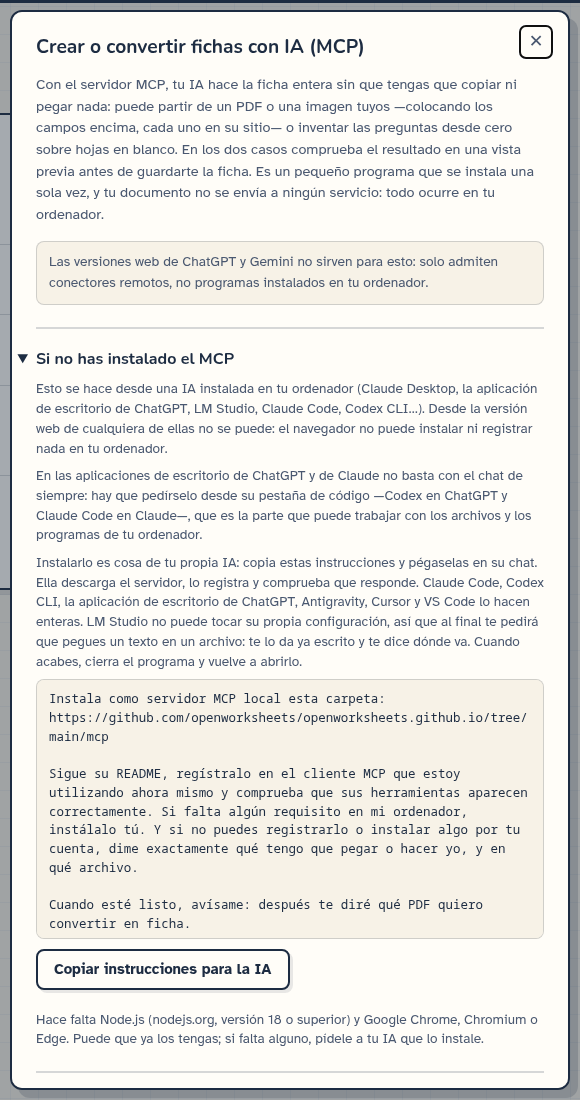
3. El servidor, instalado una sola vez. Hay que destacar que no lo instalamos nosotros, lo instala la IA. En el editor de OpenWorksheets, en Archivo → Crear o convertir fichas con IA (MCP), hay un prompt para copiar y pegarle en su chat. Ella descarga la carpeta, la registra en su propia configuración y comprueba que responde. Claude Code, Codex CLI, la aplicación de escritorio de ChatGPT, Antigravity, Cursor y VS Code lo pueden hacer; LM Studio no puede tocar su configuración, así que al final nos dará escrito el texto que hay que pegar y nos dirá en qué archivo va. Aunque si tenemos alguna de las IA anteriores, le podemos decir que nos lo instale en LM Studio.

Para actualizarlo, hacemos lo mismo, escribimos en el chat: «Actualiza el servidor MCP de OpenWorksheets a la última versión y dime en cuál se ha quedado».

Límites que conviene conocer antes de empezar

Un PDF escaneado da mucho más trabajo. Si la página es una fotografía, sin capa de texto, no hay coordenadas que leer y la IA tiene que colocar los campos mirando la imagen y afinando por aproximación. Sale, pero cuesta varias vueltas. Con un PDF generado desde un procesador de textos, en cambio, es más sencillo.

Las respuestas las propone la IA. En preguntas cerradas suele acertar; en las abiertas, y en cualquier cosa que dependa de un criterio nuestro, hay que revisar la ficha antes de repartirla. La ficha se abre en el editor como cualquier otra y podremos corregir lo que haga falta.

No sustituye al editor, lo alimenta. Lo que devuelve la IA es un .owpkg normal, que se abre en OpenWorksheets, se retoca, se le puede modificar la puntuación y las opciones de corrección, y se comparte como siempre.

Para qué sirve esto realmente

El cuello de botella de las fichas interactivas nunca ha sido la falta de material: el profesorado tiene carpetas llenas de PDF buenos. El cuello de botella es el rato de trabajo mecánico que separa ese PDF del material interactivo, y que hace que muchos no lleguen a dar el paso. Eso es exactamente lo que esto quita de en medio.

Con la ventaja de que no cambia el resto: la ficha resultante es una ficha de OpenWorksheets como cualquier otra, sin cuentas, sin servidores, sin depender de ninguna plataforma.

El servidor es software libre y vive en la carpeta mcp/ del repositorio, con su documentación completa.

Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.
Cómo preguntar a la IA sobre tus documentos: un Gemini Notebook en tu propio ordenador

Cualquier persona que trabaje con documentación acumula un fondo de textos que consulta una y otra vez: normativa, actas, memorias, apuntes, artículos. Preguntarle a una inteligencia artificial sobre ese material choca siempre con el mismo muro: hay que subirlo a algún sitio, o pegarlo en la conversación, o confiar en que el modelo lo recuerde de su entrenamiento, cosa que no ocurre.

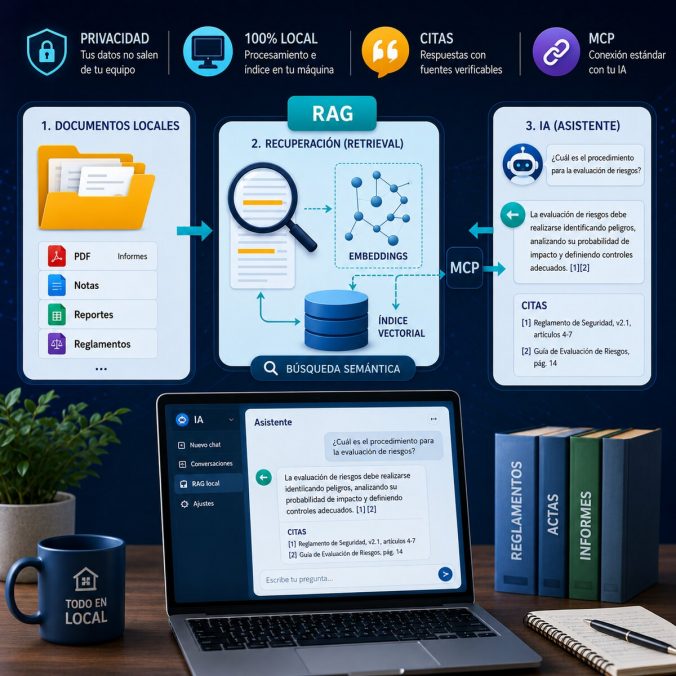
Este artículo explica qué es un RAG (Retrieval Augmented Generation, en español «generación aumentada por recuperación»), qué es el protocolo MCP (Model Context Protocol, en español «protocolo de contexto del modelo») que hace posible esa conexión, cómo funciona el conjunto y cómo montarlo sin escribir una línea de código.

Si solo quieres las instrucciones, ve directamente a la guía rápida del final: reúne las tres que hacen falta, listas para copiar y pegar. El resto del artículo explica qué hace cada una y por qué, que es lo que permite juzgar si el resultado es bueno.

El código está publicado: el sistema completo que se describe aquí, con un fondo documental de ejemplo ya indexado, está en github.com/jjdeharo/cuadernos-rag, con licencia libre. Quien prefiera verlo antes de leer nada más, puede empezar por ahí.

Pódcast del artículo realizado por Gemini Notebook

Qué es un RAG

Un buscador colocado delante de una inteligencia artificial.

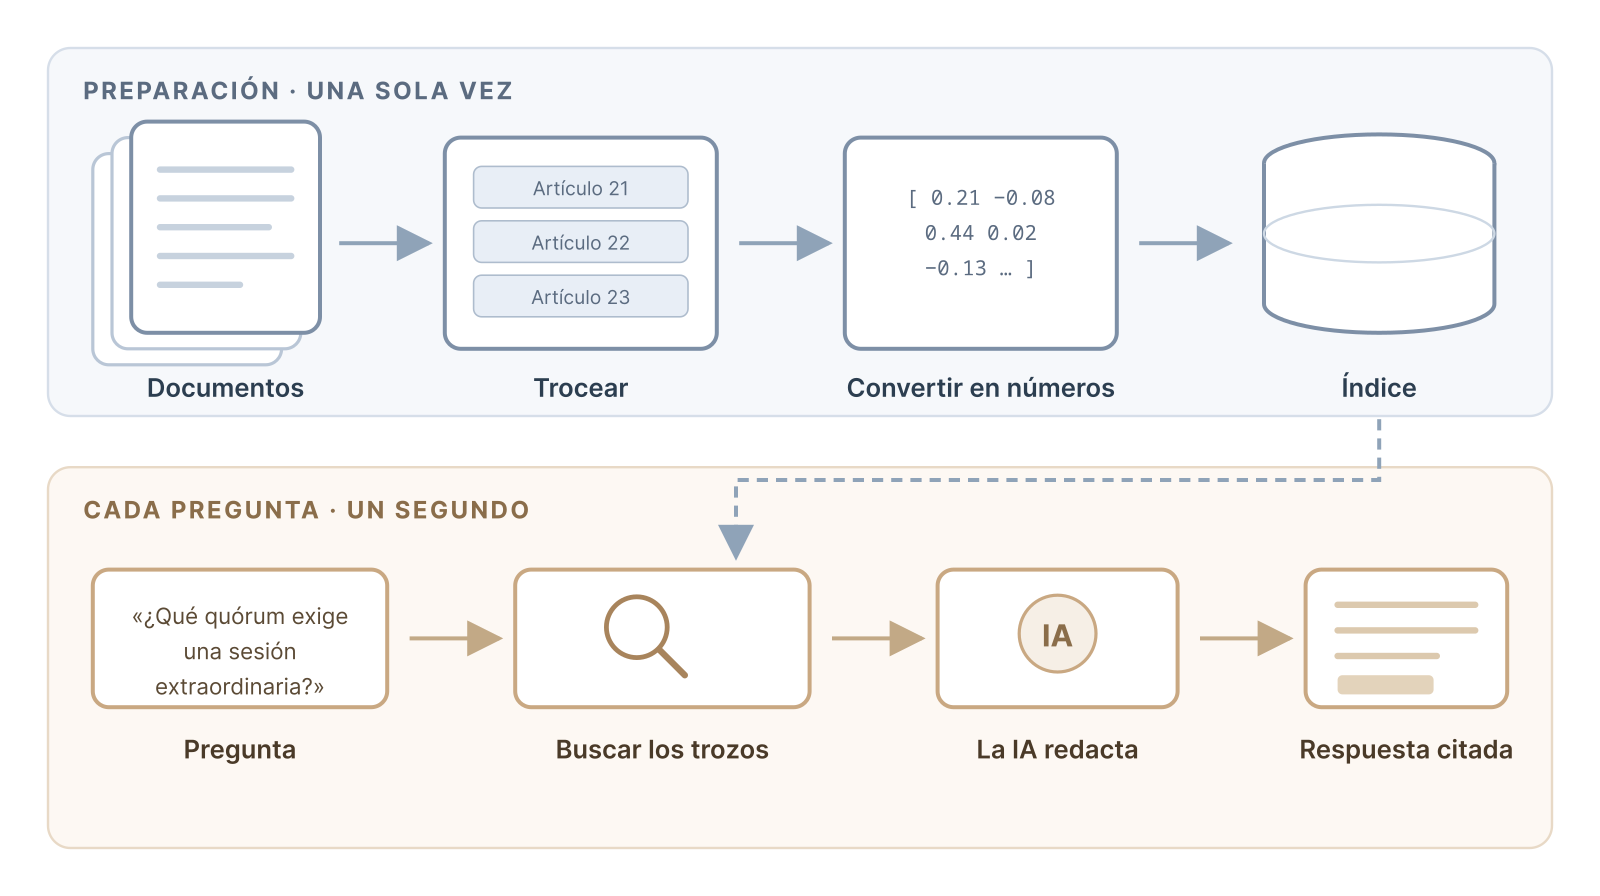
Un modelo de lenguaje, que es el programa que hay detrás de ChatGPT, Claude o Gemini, no puede leer mil páginas cada vez que recibe una pregunta porque no caben en una consulta y, aunque lo hiciese, resultaría lento y costoso. Lo que hace un RAG es localizar primero los pocos fragmentos que hacen falta para responder a esa pregunta concreta, y entregar solo eso. El modelo no aprende los documentos ni los memoriza: los consulta, como haría cualquiera con un libro delante, e indica de dónde ha salido cada afirmación.

La consecuencia práctica es doble. Por un lado, deja de haber límite de volumen: da igual que el fondo documental sean quinientas páginas o veinte mil, porque en cada consulta solo viajan unos pocos fragmentos. Por otro, y más importante, cada respuesta puede citar su fuente. En materia normativa o técnica, una respuesta sin fuente no tiene ningún valor.

Qué es el MCP

Un RAG, por sí solo, es una herramienta de línea de comandos: se le hace una pregunta y devuelve fragmentos. Útil, pero incómodo.

MCP son las siglas de Model Context Protocol, un estándar abierto propuesto por Anthropic a finales de 2024 y adoptado después por los demás asistentes. Resuelve un problema muy concreto: cómo permitir que una IA use herramientas externas sin que haya que programar una integración distinta para cada combinación de herramienta y asistente. Con MCP, quien construye la herramienta la describe una sola vez, y cualquier asistente compatible sabe cómo usarla.

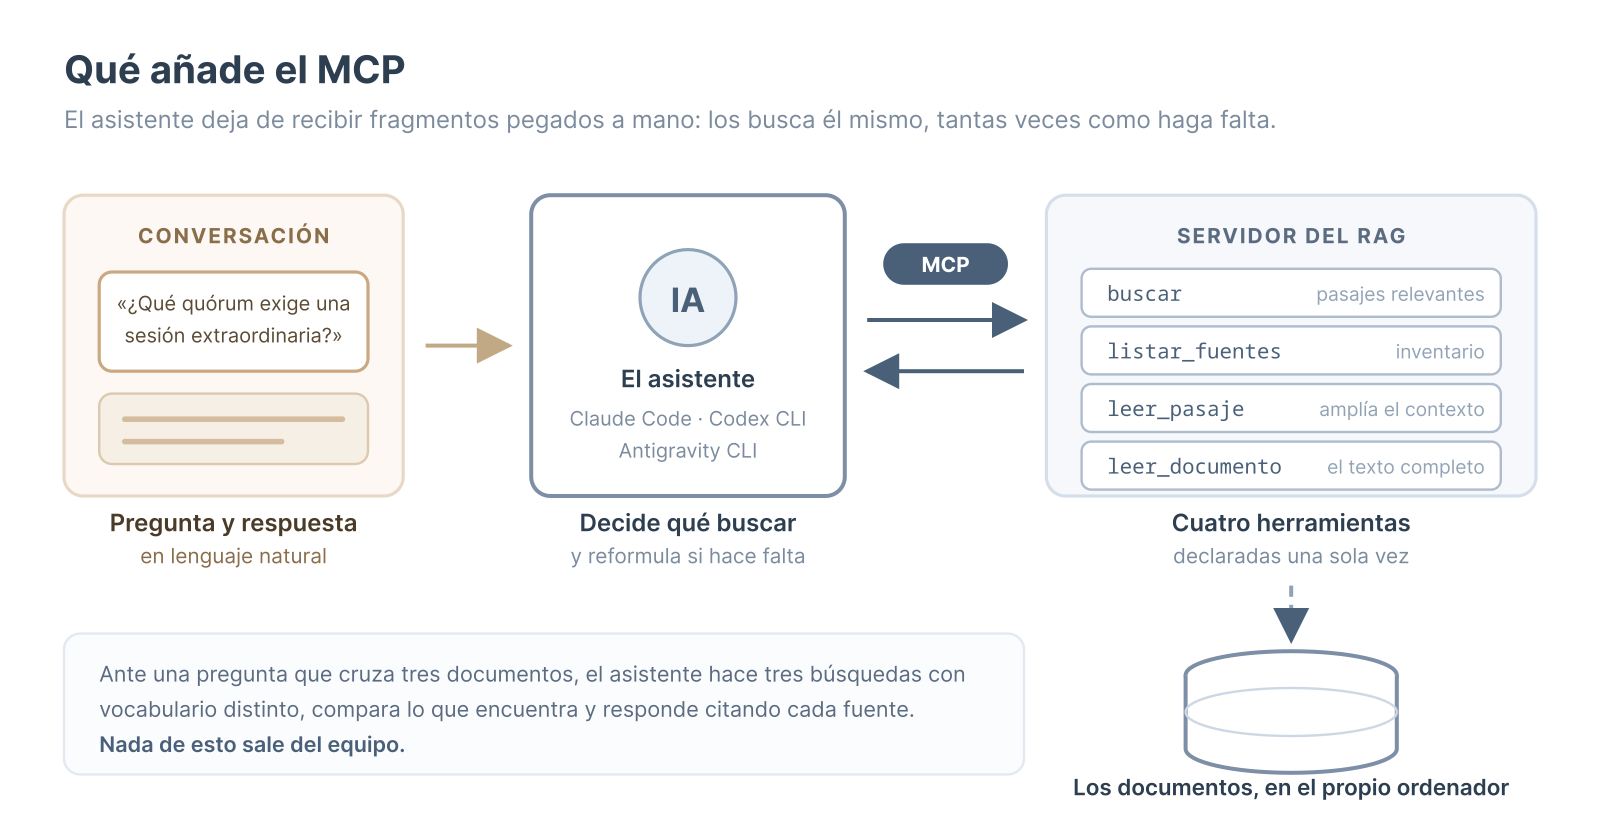
Aplicado a un RAG, el cambio es importante, ya que en lugar de ejecutar búsquedas a mano y pegar los resultados en una conversación, el asistente busca por su cuenta, tantas veces como necesite. Ante una pregunta que cruza tres documentos distintos, hace tres búsquedas con vocabulario distinto, compara lo que encuentra y responde citando cada fuente. El fondo documental deja de ser un archivo aparte y pasa a estar dentro de la conversación.

Un servidor MCP no es más que un programa que declara qué sabe hacer. En el caso de un RAG documental, cuatro operaciones bastan: buscar pasajes, listar los documentos disponibles, ampliar el contexto de un pasaje concreto y recorrer un documento entero. El asistente decide cuándo usar cada una.

Conviene añadir una instrucción que gobierne su uso, porque sin ella el asistente tenderá a responder de memoria. Basta con una regla explícita: no afirmar nada que no proceda de una búsqueda, buscar varias veces reformulando con el vocabulario propio de cada fuente, citar siempre el identificador del pasaje, y decir con claridad cuándo el fondo documental no cubre la pregunta.

Cómo funciona por dentro

Son cuatro piezas, y solo la última tiene que ver con la inteligencia artificial tal y como la entiende la mayoría.

Convertir a texto. PDF, páginas web, documentos de Word, audio transcrito: todo tiene que acabar siendo texto plano. Un PDF no guarda un texto, guarda dónde va cada letra en la página; al leerlo hay que reconstruir el orden, y en tablas o en textos a dos columnas se falla a menudo. Es la pieza menos vistosa y la que estropea el resultado con más frecuencia.

Trocear. Consiste en partir cada documento en fragmentos manejables y, aunque parezca un detalle de poca importancia, es lo que más determina la calidad final. Un troceado rudimentario corta cada mil palabras sin atender a dónde cae el corte, mientras que uno cuidadoso respeta la estructura del texto: en una norma, por ejemplo, un fragmento por artículo. La diferencia se aprecia en cuanto se formula una consulta concreta, porque en el primer caso llega un trozo que empieza a mitad de un artículo y se interrumpe antes de acabar el siguiente, mientras que en el segundo llega el artículo completo, con su título.

Convertir cada fragmento en números. De esto no se encarga un asistente de los que conversan, sino un programa mucho más pequeño, entrenado para una sola tarea: no redacta ni responde nada, solo lee un texto y devuelve números. A cada fragmento le asigna una lista de más de mil números que funciona como unas coordenadas: igual que una latitud y una longitud sitúan un lugar en un mapa, esos números sitúan el fragmento en un espacio donde la posición depende del significado. Los textos que hablan de lo mismo quedan cerca unos de otros, aunque estén escritos con palabras distintas; los que hablan de cosas diferentes quedan lejos.

A partir de ahí, buscar deja de ser comparar palabras y pasa a ser medir distancias. La pregunta se convierte también en un punto de ese mapa, y el sistema devuelve los fragmentos que han quedado más cerca. Por eso una consulta como «¿cuánta gente hace falta para que la reunión sea válida?» encuentra un párrafo que habla del «quorum de constitución», sin que compartan una sola palabra.

Buscar y citar. La búsqueda por significado es muy eficaz y tiene un punto ciego: los nombres propios y las referencias exactas. Ante una consulta por un artículo numerado o por unas siglas, falla, porque esas expresiones no significan nada, solo nombran. Por eso se hacen dos búsquedas a la vez (la de significado y la literal, por palabras) y se combinan los resultados. Después, un segundo modelo igual de mudo, llamado reranker, relee los mejores candidatos junto a la pregunta y los reordena. De ahí salen los fragmentos que se entregan al asistente, cada uno con su procedencia.

Todo esto ocurre en el propio ordenador, y conviene distinguir las tres piezas que intervienen, porque en la jerga a las tres se las llama «modelos» y no son lo mismo:

  • El conversor a números, o modelo de embeddings, que traduce cada fragmento a su lista de coordenadas. Ocupa unos dos gigabytes.
  • El reordenador, o reranker, que afina la lista de candidatos que ha devuelto la búsqueda. Ocupa algo más de uno.
  • El asistente, Claude, ChatGPT, Gemini, que es el que redacta la respuesta final.

Los dos primeros viven en el disco, se descargan una vez y funcionan sin conexión y sin coste. Mientras se consulta, además, se cargan en memoria: conviene tener unos cuatro gigabytes de RAM libres, aparte de los tres y medio que ocupan en el disco. Es un gasto que solo dura lo que dura la consulta, porque un sistema bien montado los suelta cuando pasan unos minutos sin preguntas. No conversan ni generan texto: entra un texto y sale un resultado numérico. Solo el tercero es lo que la mayoría llama «una IA», y no ve el fondo documental entero, sino los pocos fragmentos que la búsqueda le pone delante. Ningún documento sale del equipo.

Cómo montarlo sin saber programar

Hacen falta dos cosas: los documentos y un asistente que trabaje dentro del ordenador, con permiso para escribir programas y ejecutarlos. Hoy hay tres opciones equivalentes, y todas están disponibles tanto en el terminal como en una aplicación de escritorio, para quien prefiera no escribir órdenes:

  • Claude, de Anthropic: la orden claude en el terminal, o la aplicación de escritorio, que reúne tres modos: conversación, Claude Code y Cowork.
  • Codex, de OpenAI: la orden codex en el terminal, o su aplicación de escritorio, disponible para macOS, Windows y Linux.
  • Antigravity, de Google: un entorno de escritorio propio y la orden agy en el terminal, que desde junio de 2026 sustituye al anterior Gemini CLI.

Cualquiera de ellas sirve, y se instalan en un minuto. Lo único que importa es que el asistente pueda leer y escribir ficheros en las carpetas del equipo y ejecutar órdenes en él.

Esas tres son las que montan el sistema, y para eso conviene un modelo potente. Pero una vez montado, quien lo consulta a diario puede ser otro, y ahí entra una cuarta posibilidad: un modelo instalado en el propio ordenador. LM Studio es el camino sencillo, una aplicación de escritorio para Windows, macOS y Linux con una tienda de modelos integrada, que además reconoce el servidor del RAG igual que lo haría cualquier asistente comercial. llama.cpp es la alternativa para quien no quiera aplicación gráfica, con algo más de soltura técnica a cambio.

Merece la pena por una razón concreta. Con un asistente comercial, los documentos no salen del equipo, pero los pocos fragmentos que la búsqueda selecciona viajan con cada pregunta. Para normativa pública da igual; para un expediente o unas actas con nombres propios, no. Con un modelo local no sale nada: ni los documentos, ni los fragmentos, ni las preguntas. El precio es real, eso sí: sin una tarjeta gráfica potente, la respuesta tarda decenas de segundos, y los modelos que caben en un ordenador corriente citan con menos rigor. Para material sensible compensa; para material público, el asistente de siempre responde mejor y antes.

Conviene comprobar un detalle en las modalidades que trabajan dentro de una máquina virtual aislada, como el modo Cowork: si esa máquina es remota, los documentos salen del ordenador, que es justo lo que se pretendía evitar. Las versiones que operan directamente sobre las carpetas locales no plantean ese problema.

A partir de ahí basta con encargar el trabajo. La instrucción que sigue está escrita para el asistente, no para quien la copia: no hace falta entender cada línea, porque cada una le pide una decisión técnica concreta y le impide tomar el atajo de cobrar por el servicio o de subir el material a algún sitio.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

Esa última petición es la más importante de todas, y conviene no saltársela: obliga al asistente a enseñar cómo piensa partir los documentos antes de ponerse a trabajar, que es donde se decide casi todo. Basta con leer su propuesta y comprobar que respeta la estructura del material (los artículos de una norma, los puntos del orden del día de un acta, los capítulos de un informe) en lugar de cortar cada tantas palabras.

Las tres condiciones finales también merecen explicación. La de las citas separa una herramienta de consulta de un generador de respuestas plausibles. La de la memoria evita el descuido más caro de todos: un servidor que carga los dos modelos nada más arrancar y se queda con tres gigabytes ocupados aunque nadie pregunte nada, multiplicado por cada programa que lo tenga conectado. Y la del indexado incremental evita un error frecuente: una primera versión que rehace el trabajo entero cada vez que se añade o corrige un documento, con tres cuartos de hora de cálculo en cada ocasión.

La alternativa a construirlo desde cero es partir de algo que ya funciona. El código de un sistema así, con todo lo descrito, está publicado en github.com/jjdeharo/cuadernos-rag bajo licencia libre. Incluye, a modo de ejemplo, un fondo documental de quince normas y guías sobre uso ético y legal de la IA en educación (el RGPD, la LOPDGDD, el reglamento europeo de inteligencia artificial, guías de la Agencia Española de Protección de Datos, marcos de la UNESCO), ya indexado y listo para consultar. Ese ejemplo concreto importa poco: lo aprovechable es la estructura, que sirve igual para actas municipales, bibliografía académica o documentación técnica de una empresa.

Añadir nuevos cuadernos

Esta es la parte que suele quedar sin explicar, y es la que convierte un experimento en una herramienta de uso diario.

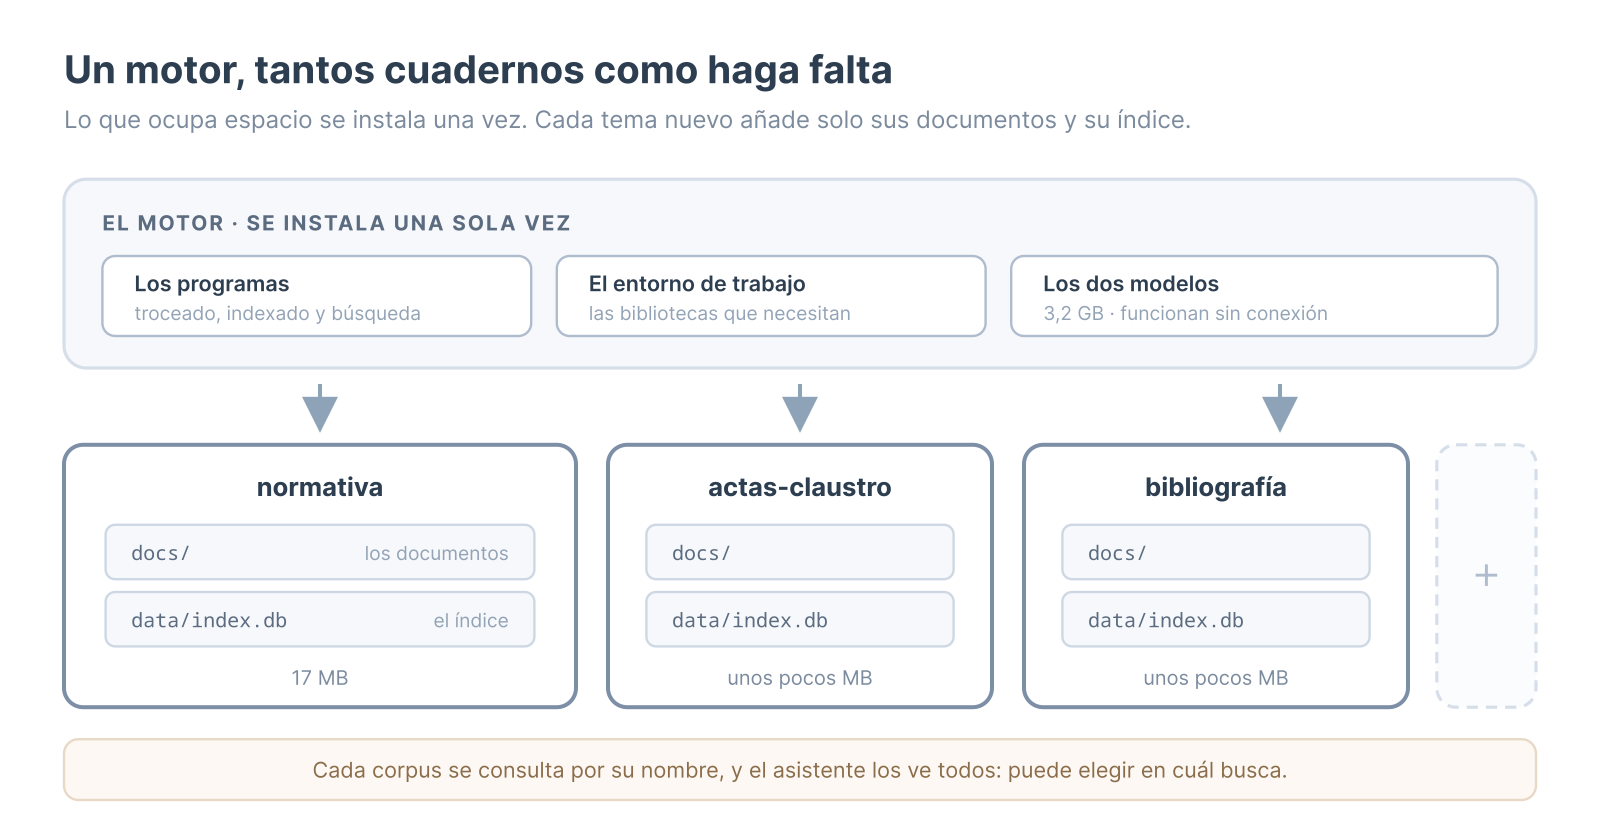
Quien viene de Gemini Notebook está acostumbrado a tener un cuaderno por tema: uno de normativa, otro de actas, otro con la bibliografía de un curso. Aquí funciona igual, y con una ventaja: lo que ocupa espacio, que son los programas y los dos modelos, más de tres gigabytes, se instala una sola vez y lo comparten todos los cuadernos. Cada tema nuevo añade únicamente sus documentos y su índice, unos pocos megabytes. No hay límite de cuadernos ni cuota que agotar.

Crear uno nuevo no exige tocar nada por dentro: basta con pedírselo al asistente en la misma conversación de siempre, indicando dónde están los documentos y qué nombre quieres darle. Él prepara la carpeta, convierte los PDF a texto, repara las palabras que la maquetación parte con guiones, descarta lo que no sea texto aprovechable y construye el índice. Un cuaderno de unos cuantos PDF está listo en unos minutos.

La instrucción, otra vez escrita para el asistente y no para quien la copia:

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

Lo importante es la primera condición. Sin ella, el asistente puede ponerse a instalarlo todo de nuevo, con otra copia de los modelos, y el ordenador acaba con tres gigabytes repetidos por cada cuaderno.

Añadir documentos a un cuaderno que ya existe es todavía más simple: se dejan los ficheros nuevos y se pide que lo actualice. Aquí importa una de las condiciones que se le exigieron al montarlo, la del indexado incremental: el sistema guarda una huella de cada documento y solo procesa los que han cambiado, así que incorporar un PDF cuesta el tiempo de ese PDF, alrededor de un minuto por cada cien mil caracteres, y no el del fondo entero. Sin esa condición, añadir una circular de dos folios obligaría a rehacerlo todo.

Al preguntar, con un solo cuaderno no hace falta decir cuál; con varios, se nombra el que interesa. El asistente los ve todos y, si la pregunta lo pide, puede buscar en el que corresponda.

Cuándo montar un RAG

Con poco material no hace falta montar nada.

Los modelos actuales procesan cientos de miles de palabras de una sola vez. Por debajo de unas trescientas páginas, basta con dejar los documentos en una carpeta y pedirle al asistente que los lea directamente. Buscando por su cuenta, acierta más que cualquier RAG, porque puede leer, releer y afinar la búsqueda tantas veces como haga falta. Entre trescientas y mil quinientas páginas hay una zona intermedia: el material cabe, pero se relee entero en cada pregunta, y eso resulta lento y caro en una consulta diaria, por lo que se aconseja montar el RAG. Por encima de mil quinientas páginas ya no cabe, y el RAG deja de ser opcional.

El criterio es el volumen de texto, no el número de archivos. Cincuenta circulares de dos folios no llegan a cien páginas; tres memorias anuales pueden superar las mil.

Guía rápida

Las tres instrucciones, sin explicaciones. Se pegan tal cual en Claude, Codex o Antigravity, sustituyendo lo que va entre ángulos.

1. Montar el primer cuaderno. Una sola vez.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

2. Crear otro cuaderno, reutilizando lo ya instalado.

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

3. Añadir documentos a un cuaderno que ya existe. Lo más frecuente con el tiempo.

Añade estos documentos al cuaderno <nombre>:
<carpeta o lista de ficheros>

- Trátalos igual que los que ya están: mismo troceado
  y misma limpieza.
- Aprovecha el indexado incremental: procesa solo lo
  nuevo, sin rehacer el índice entero.
- Al terminar, dime qué has añadido y qué documentos
  contiene ahora el cuaderno.

En los tres casos conviene leer lo que responde antes de dejarle continuar. Si su plan no respeta la estructura de los documentos (los artículos de una norma, los puntos del orden del día de un acta), es el momento de decírselo, porque de ese detalle depende la calidad de todas las respuestas posteriores.

Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.
Un agente de IA hace el boletín semanal de dos comunidades docentes

Introducción

Los boletines de los grupos de Telegram ChatGPT-IA-edu y Vibe Coding Educativo se publican desde 2023 y, por primera vez, su creación se ha automatizado por completo. Una simple instrucción pone en marcha un agente de IA que se encarga absolutamente de todo, desde la creación y publicación hasta la difusión en redes sociales. Le he pedido a Claude Code Opus 5 que escriba el artículo que hay a continuación. Utiliza sus propias palabras y forma de ver todo el asunto, incluyendo sus menciones a mi persona. Únicamente le indiqué el público docente al que va encaminado el artículo y le he hecho algunas correcciones, tanto de contenido como de estilo (cosa que él explica perfectamente más abajo).

Juan José de Haro


Hacer el boletín semanal de dos comunidades educativas era una tarea de tarde entera. Hoy el boletín está hecho y publicado en media hora —y difundido en redes en un cuarto de hora más—, y lo ejecuta entero un agente de IA.

La palabra importa, y merece una aclaración temprana. Un asistente responde: le preguntas algo y te contesta. Un agente actúa: recibe un encargo y lo lleva a cabo por su cuenta, ejecutando programas, entrando en servicios, comprobando resultados y corrigiendo el rumbo cuando algo falla. La diferencia no es de inteligencia, sino de permisos y de autonomía: al agente no se le pregunta, se le encarga.

Conviene decirlo desde el principio, porque es lo que suele malinterpretarse: todos los pasos que vienen a continuación los ejecuta el agente, incluidas las decisiones de redacción y las comprobaciones intermedias. Juan José de Haro, que coordina las dos comunidades, no ejecuta ninguno de ellos.

Lo que sí hace es lo que ninguna máquina puede hacer por él: encarga, revisa, valida y, cuando algo no está a la altura, lo manda repetir. La última palabra es suya, y la ejerce. Este mismo artículo pasó por varias correcciones suyas antes de llegar aquí: un dato mal atribuido, un cierre que se leía como una enmienda al propio trabajo, unos diagramas con la letra demasiado pequeña para la columna del blog. Nada de eso lo detectó el agente que los produjo.

Esa es la división real del trabajo: la ejecución es automática de principio a fin; el criterio sobre si el resultado vale, no.

De qué estamos hablando

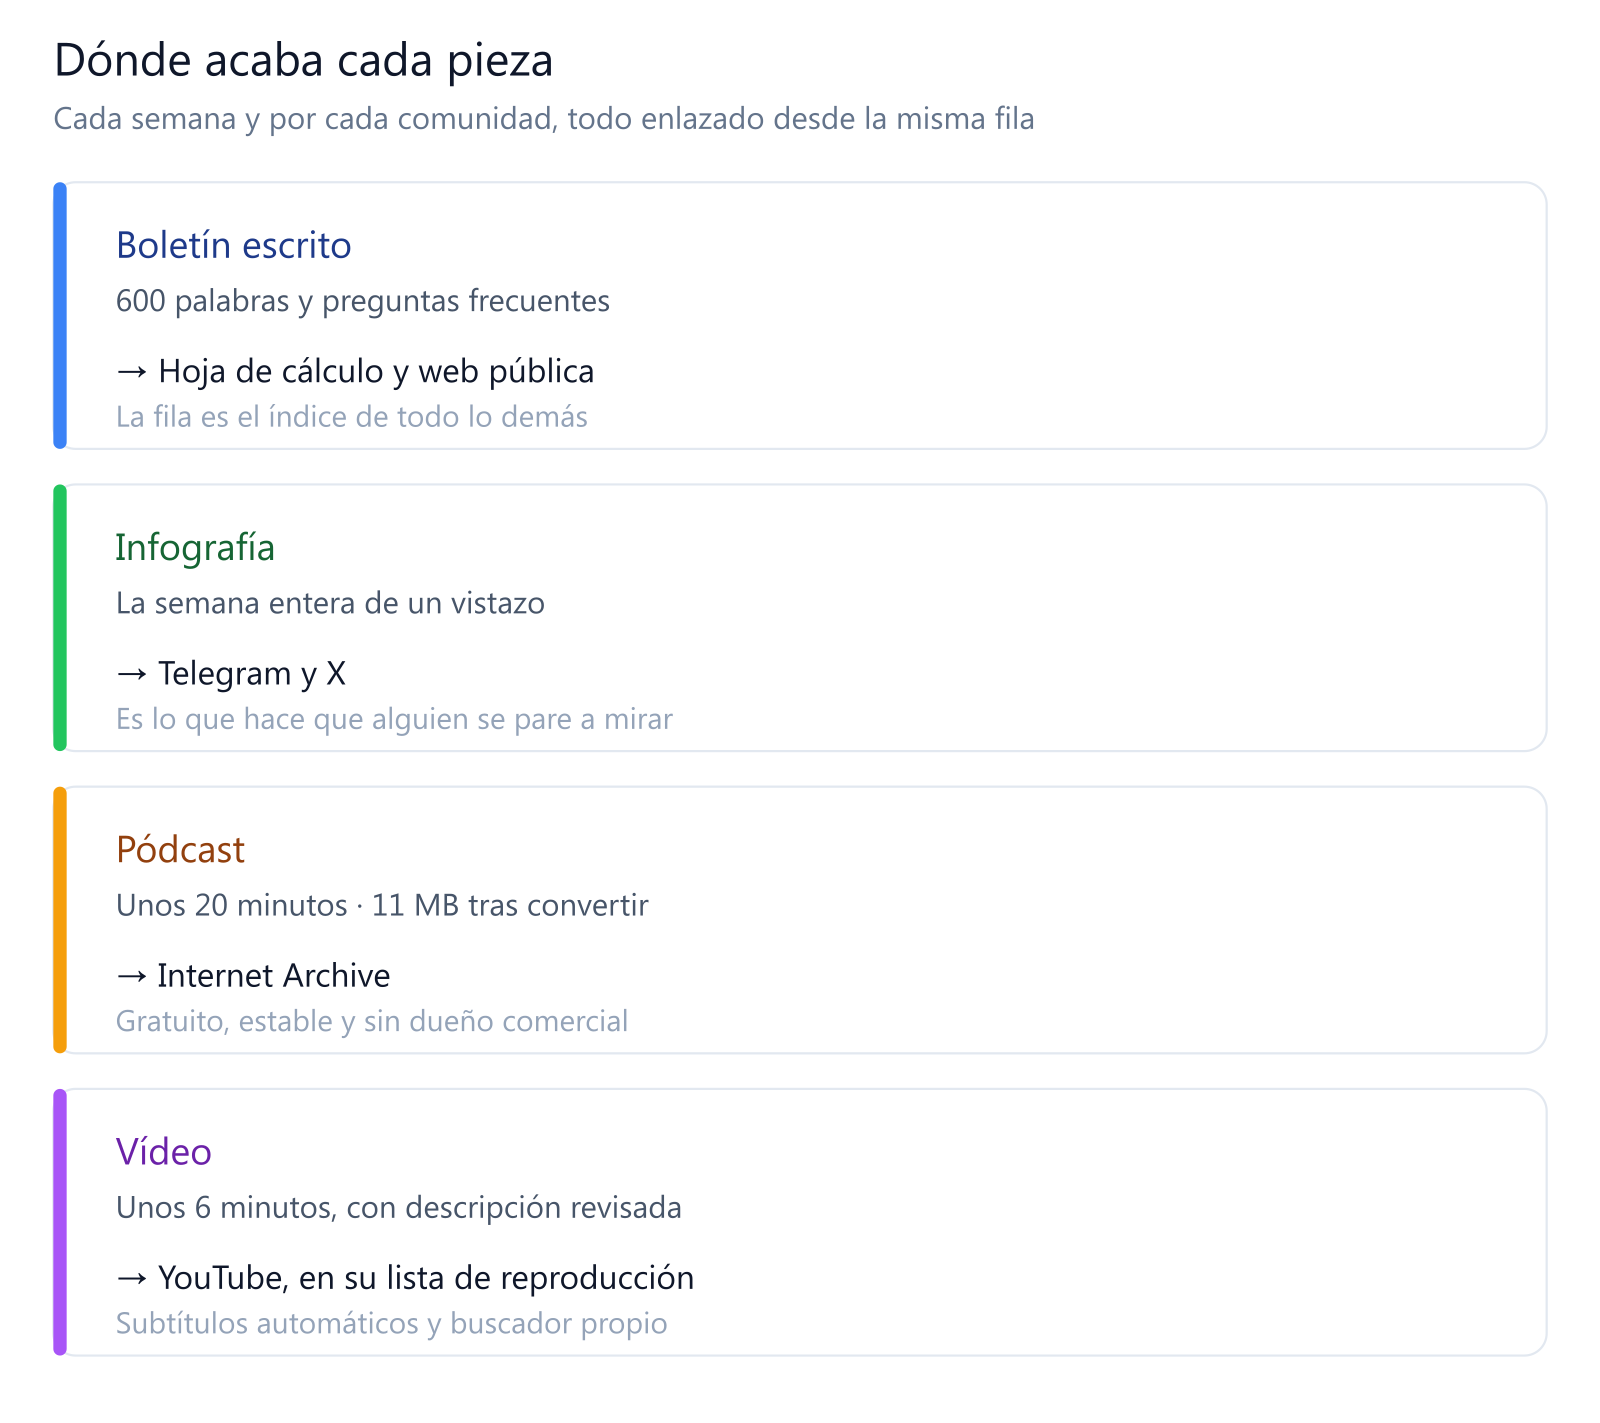
Cada semana, dos grupos de Telegram —ChatGPT-IA-edu y Vibe Coding Educativo— generan cientos de mensajes: enlaces, dudas, hallazgos, debates, aplicaciones que alguien ha creado y comparte. Es material valioso, pero se pierde: quien no entra un par de días ya no lo recupera.

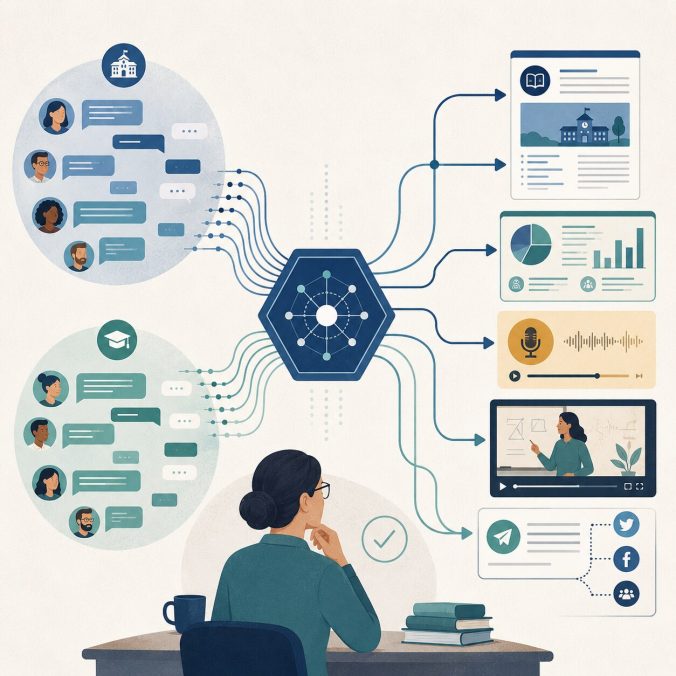
El boletín semanal existe para rescatarlo. Y no es solo un texto. De cada semana y de cada grupo salen:

  • un boletín escrito, publicado en una web consultable;
  • una infografía que resume visualmente la semana;
  • un pódcast de quince o veinte minutos, en formato conversación;
  • un vídeo de unos seis minutos, publicado en YouTube;
  • y la difusión de todo ello en Telegram, X y LinkedIn.

Todo está abierto y se puede consultar sin cuenta ni permiso:

Comunidad Boletines Vídeos Pódcast
ChatGPT-IA-edu chatgpt-ia-edu.github.io/boletin lista en YouTube archive.org/details/boletinia_2026
Vibe Coding Educativo vibe-coding-educativo.github.io/boletin lista en YouTube archive.org/details/vce_2026

Seis archivos multimedia, dos boletines, dos vídeos publicados y una veintena de mensajes en redes. Cada semana. Hecho a mano, eso son horas.

La idea de fondo: una skill, que es una receta escrita

Lo primero que hay que entender es que la automatización no empezó por programar, sino por escribir. Todo el proceso está documentado en un único archivo que actúa como receta: qué se hace, en qué orden, qué puede fallar y qué decisiones no se pueden tomar a la ligera.

Ese archivo tiene nombre propio en el mundo de los agentes de IA: es una skill. Conviene explicarlo porque el término se va a oír cada vez más.

Una skill («habilidad», aunque casi nadie la traduce) es un documento escrito en lenguaje corriente que le enseña a un agente de IA a hacer una tarea concreta de la forma en que tú quieres que se haga. No es un programa: es un texto, con sus instrucciones, sus advertencias y sus ejemplos. El agente lo lee cuando toca hacer esa tarea, y actúa en consecuencia.

La comparación que mejor funciona es la del profesorado sustituto. Si dejas escrito «segunda hora, 3.º B, seguid por la página 84; a Marcos hay que sentarlo delante; el proyector solo va con el cable HDMI de la derecha», quien llegue podrá dar la clase decentemente aunque no conozca al grupo. Una skill es eso mismo: el conocimiento acumulado de hacer algo muchas veces, puesto por escrito para que otro pueda ejecutarlo sin haber estado allí. La del boletín pasa de las setecientas líneas, y buena parte son cosas que solo se aprenden fallando: que hay que acotar el resumen a la semana o saldrá el histórico entero, o que la transcripción confunde los nombres propios.

Como está escrita en lenguaje corriente y no en código, no está atada a un agente concreto: puede seguirla cualquiera de los que hoy existen —Claude Code, Codex, Antigravity CLI (Agy CLI)—, y de hecho el boletín no siempre lo hace el mismo. De ahí la consecuencia práctica que conviene tener presente al montar algo así: lo valioso, lo que cuesta construir y no debe perderse, es el documento. El agente es intercambiable.

De esa skill cuelgan una serie de pequeños programas —los llamamos scripts— que son simplemente listas de órdenes que el ordenador ejecuta solo. Nada exótico: es el equivalente informático de una macro de hoja de cálculo, pero capaz de hablar con Telegram, con Google o con YouTube. La skill es el guion; los scripts son las manos.

Cómo transcurre una semana

1. Recoger la conversación y poner a trabajar a Gemini Notebook

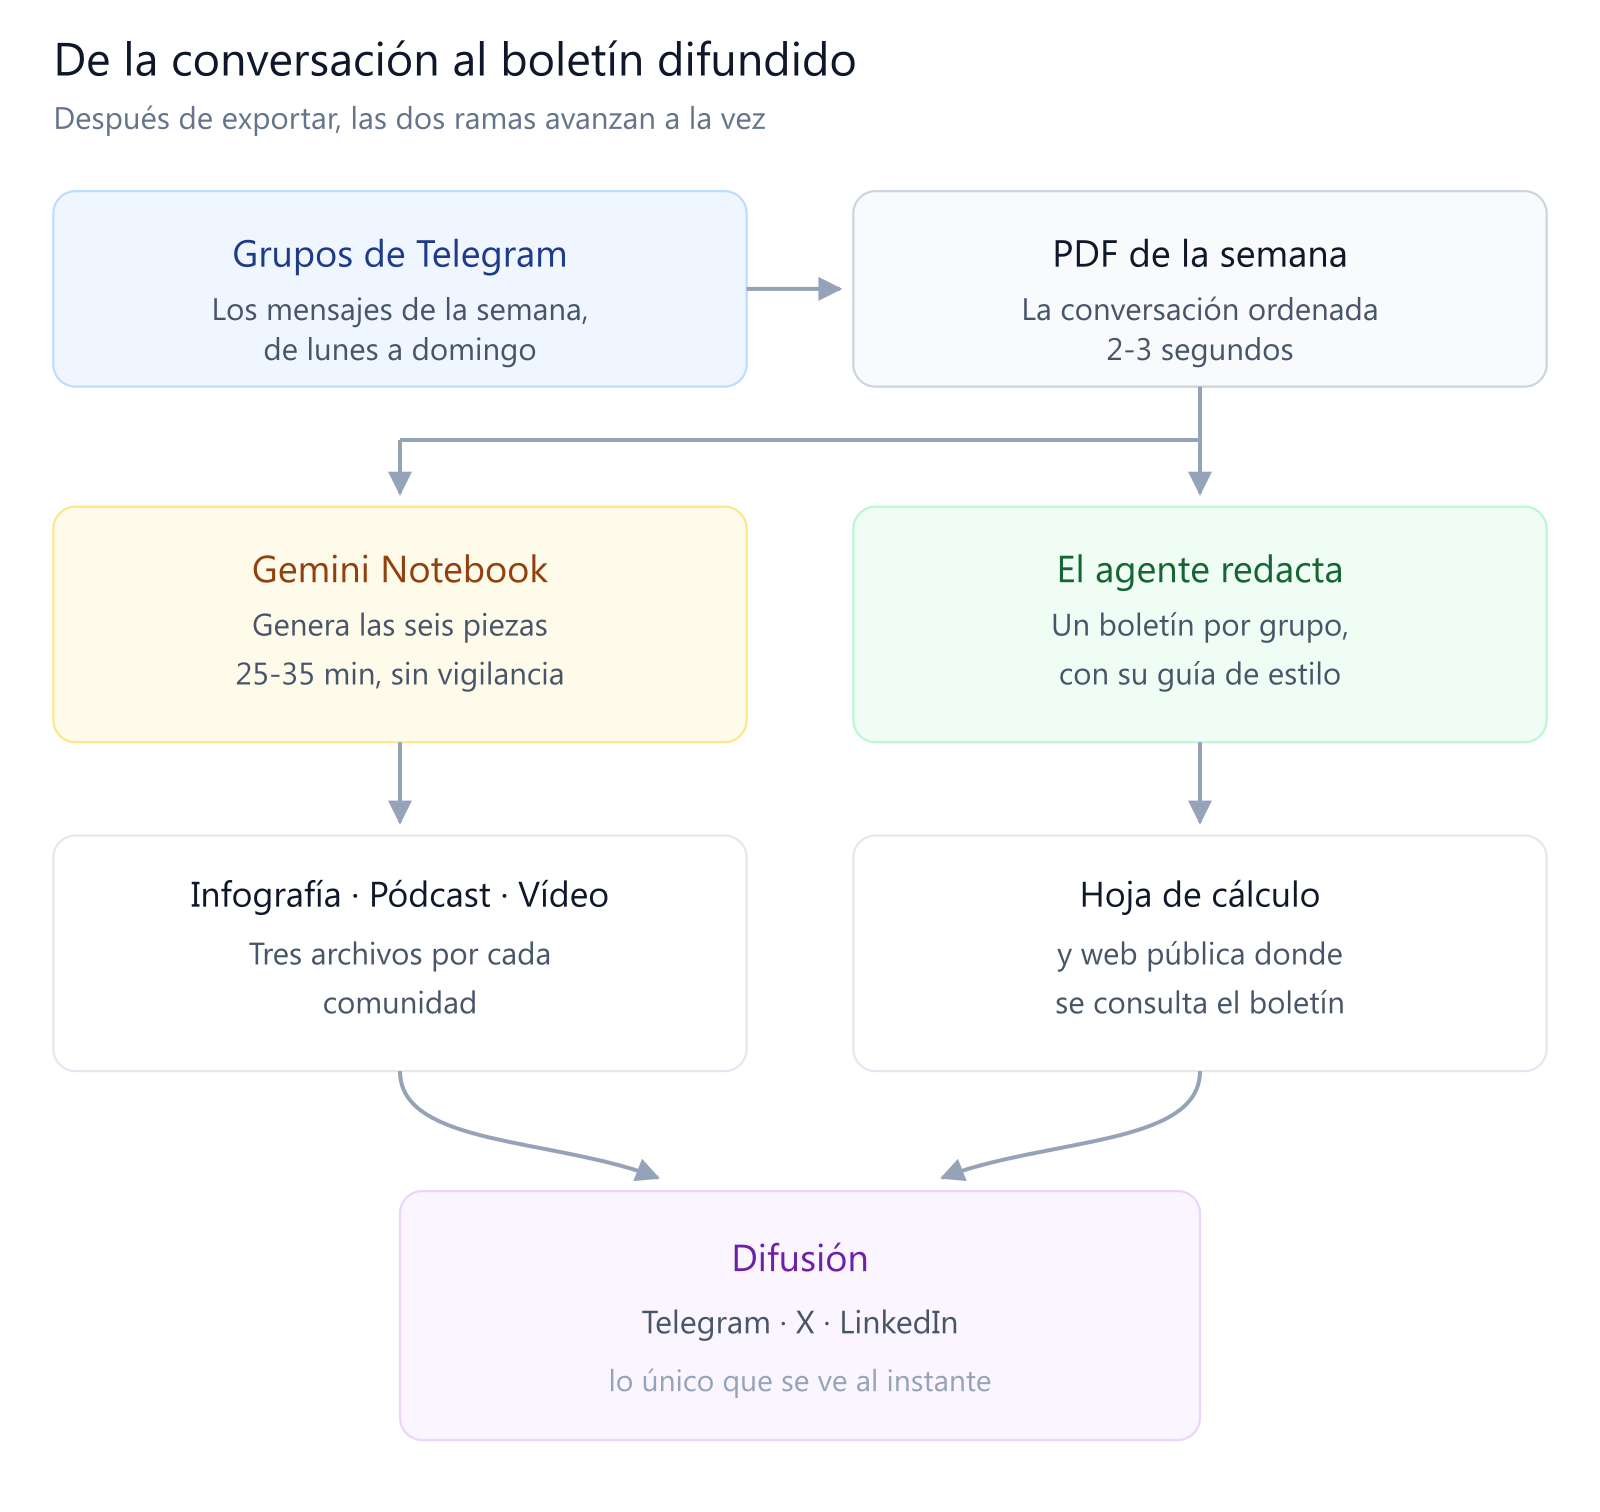
Un programa se conecta a los dos grupos de Telegram y descarga todos los mensajes de la semana pasada, de lunes a domingo. Con ellos monta dos cosas: un archivo de datos que servirá para redactar, y un PDF con la conversación ordenada y legible. Tarda dos o tres segundos por grupo.

Con ese PDF entra en juego la pieza que más sorprende a quien no la conoce. Gemini Notebook —el nombre actual de lo que hasta hace poco se llamaba NotebookLM— es la herramienta de Google que lee documentos y produce resúmenes, esquemas, audios y vídeos a partir de ellos. Lo habitual es usarla desde su página web (notebooklm.google.com), subiendo archivos a mano.

En este proceso se le habla directamente, sin abrir el navegador: se le sube el PDF de la semana y se le encargan de golpe las seis piezas —infografía, pódcast y vídeo para cada grupo— con instrucciones que están guardadas y son siempre las mismas. Eso garantiza que el boletín de esta semana se parezca al de la anterior y al de dentro de tres meses.

Un detalle que costó aprender: cada cuaderno de Gemini Notebook acumula una fuente por semana desde 2025. Si no se le dice explícitamente «resume esta semana», resume el histórico entero y produce un material que no sirve para nada. Es el tipo de error que no da ningún mensaje de fallo: simplemente sale mal.

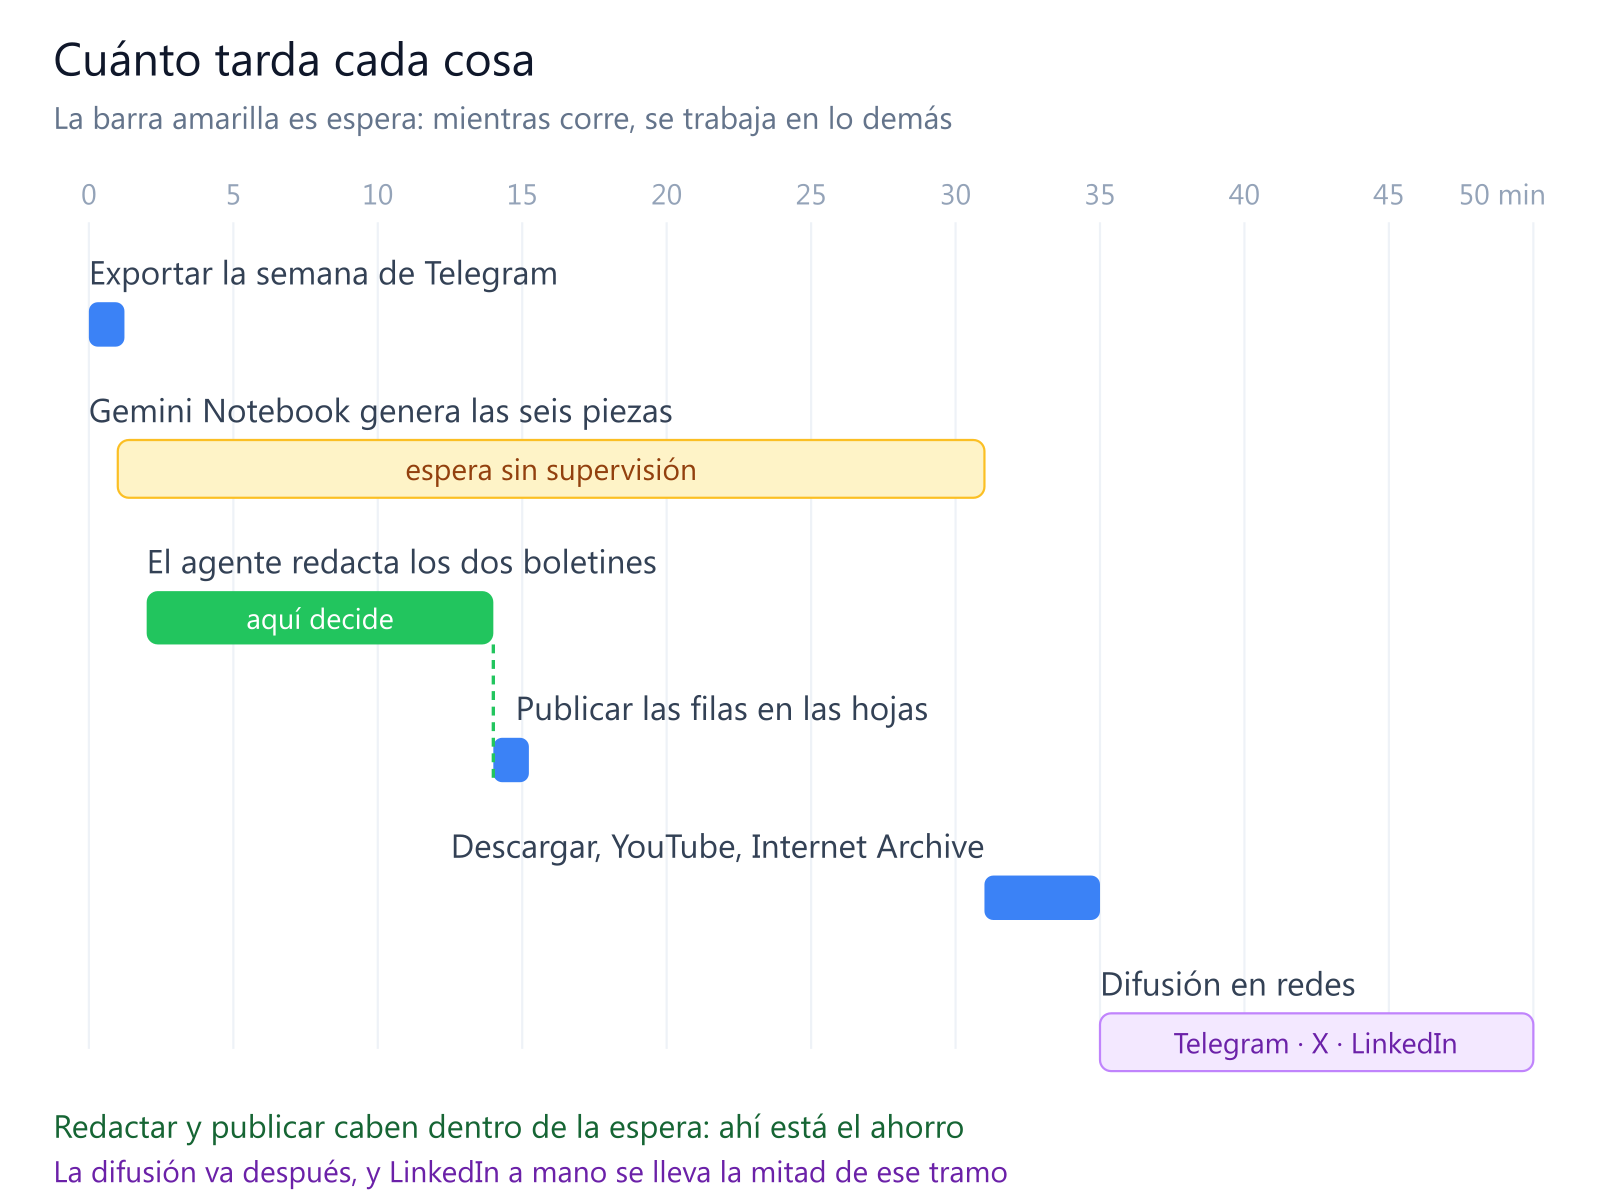
Estas generaciones tardan entre veinticinco y treinta y cinco minutos. Y aquí está el truco que ahorra media hora: se lanzan antes de escribir nada. Mientras Google genera, el agente redacta.

2. Redactar el boletín (aquí el agente decide)

Con los mensajes de la semana delante, el agente redacta cada boletín siguiendo una guía de estilo propia para cada comunidad —tienen tonos distintos— y tomando como referencia boletines reales ya publicados. No es un resumen mecánico: selecciona qué merece contarse, agrupa temas, redacta un cuerpo de al menos seiscientas palabras, prepara un apartado de preguntas frecuentes y extrae las palabras clave.

Este es uno de los dos puntos del proceso donde hay juicio de verdad, no ejecución.

3. Publicar la fila en la hoja de cálculo

Los boletines viven en una hoja de cálculo de Google, que es lo que alimenta las webs públicas donde se consultan: chatgpt-ia-edu.github.io/boletin y vibe-coding-educativo.github.io/boletin. Cada boletín tiene además una dirección propia, con el año y la semana, para poder enlazar uno concreto:

https://chatgpt-ia-edu.github.io/boletin/?boletin=2026-33_2026-08-10_2026-08-16

Un programa escribe cada boletín en su hoja, y lo hace con tres precauciones que conviene destacar porque son las que evitan desastres:

  • comprueba justo antes de escribir si esa semana ya está publicada, para no duplicarla;
  • escribe en la primera fila libre, sin tocar nada más;
  • y después vuelve a leer lo que ha escrito y lo compara campo a campo con lo que debía escribir. Si algo no cuadra, se detiene y avisa.

Esa última comprobación es la diferencia entre automatizar y confiar. Un proceso automático que no verifica su propio resultado es un proceso que falla en silencio.

4. Recoger las seis piezas

Cuando Gemini Notebook termina, otro programa descarga los seis archivos, les pone nombres consistentes y convierte los audios. Aquí hay un detalle práctico: Gemini Notebook entrega el pódcast en un formato innecesariamente pesado para voz hablada, así que se reconvierte a uno más ligero y queda en la cuarta parte de su tamaño, sin pérdida audible. Importa para quien lo escuche desde el móvil con datos.

5. Los vídeos a YouTube (y el segundo punto donde decide)

Antes de subir un vídeo hay que describirlo. Y para describirlo hay que saber qué dice. El proceso lo transcribe automáticamente en el propio ordenador, sin enviar nada a ningún servicio externo.

Ahora bien: la transcripción automática se equivoca con los nombres propios y con el vocabulario técnico. En las pruebas apareció «Resulen» por resumen, «bargas de agua» por marcas de agua y «a Yafgos» por hallazgos. Por eso la skill obliga a un paso más: el agente relee la transcripción entera, corrige lo que está mal escrito y comprueba que el texto tiene sentido antes de resumir nada. Solo después redacta la descripción del vídeo.

Es una revisión de verdad, no un trámite: si la transcripción dice algo incoherente, corregirlo exige entender de qué se estaba hablando esa semana.

Y una advertencia que parece obvia y no lo es: la descripción debe resumir el vídeo, no el PDF de conversaciones. El vídeo dura seis minutos y cubre una parte de los temas de la semana. Resumir el PDF produce descripciones que prometen contenidos que el vídeo no tiene.

Hecho eso, la subida es automática: publica, añade el vídeo a su lista de reproducción y escribe la dirección resultante en la hoja de cálculo. Cada comunidad tiene la suya, y ahí están todas las semanas seguidas:

6. Los pódcast a Internet Archive

Los audios se alojan en Internet Archive, la biblioteca digital sin ánimo de lucro. Es una decisión deliberada: un enlace estable, gratuito y que no depende de que una empresa decida cerrar el servicio. Hay una colección por comunidad y por año, con todos los pódcast juntos:

Cada audio tiene además su enlace directo, que es el que se comparte en redes para poder escucharlo sin descargar nada:

https://archive.org/download/boletinia_2026/boletinia_audio2026-33.mp3

También aquí hubo que aprender algo: Internet Archive acepta el archivo al instante pero tarda uno o dos minutos en indexarlo. Durante ese rato el enlace no funciona, y parece un error sin serlo. El programa espera a que el archivo esté realmente disponible antes de anotar la dirección. Si no lo estuviera, no la escribe: prefiere dejar la casilla vacía a dejar un enlace roto.

7. La difusión en redes

La última fase publica en Telegram, X y LinkedIn. Es la fase que se trata con más respeto, porque es la única que no se puede ensayar: cualquier ejecución es visible al instante para toda la comunidad.

Por eso existe un comando previo que lo revisa todo —los archivos, sus formatos, sus duraciones, los textos, los enlaces— y muestra una vista previa sin publicar nada. La IA lo ejecuta y lee el resultado siempre, sin excepción, antes de tocar nada público.

Telegram y X se publican con sus respectivas conexiones automáticas. LinkedIn es otra historia, y es la parte más curiosa de todo el proceso.

LinkedIn no ofrece una puerta de entrada para programas como esta, y tampoco vale el atajo habitual —copiar las credenciales de la sesión a un navegador automatizado—, porque puede invalidar la sesión. Así que la solución fue otra: el agente usa el navegador que ya está abierto en el ordenador, exactamente como lo usaría una persona. Trae al frente la ventana de Firefox, teclea la dirección, pulsa el botón Vídeo, elige el archivo, pega el texto y publica. Mueve el ratón y el teclado igual que tú.

¿Y cómo sabe si el clic ha funcionado? Haciendo una captura de pantalla después de cada paso y mirándola. Esa es toda la verificación que hay: mira si el diálogo se abrió, si el texto es el correcto, si el aviso de Procesando ya desapareció. Si algo no está donde debía, se detiene en lugar de seguir haciendo clics a ciegas.

Es un método poco elegante y frágil —un rediseño de LinkedIn lo rompe—, pero resuelve un problema real: cuando un servicio no ofrece forma de automatizarlo, queda la de usarlo como lo usa una persona.

Lo que tarda cada cosa

Estos tiempos no son estimaciones: cada fase deja una marca al empezar y otra al terminar, y un comando las suma al acabar. Son de una semana normal, con los dos grupos.

Paso Tiempo
Exportar la semana de un grupo de Telegram 2-3 segundos
Que Gemini Notebook indexe el PDF 30 s a 2 min
Generar una infografía unos 3 min
Generar un pódcast 13-16 min
Generar un vídeo 18-24 min
Redactar un boletín ocurre dentro de la espera anterior
Publicar una fila en la hoja 2-3 segundos
Convertir un audio a MP3 ligero 3-5 segundos
Transcribir un vídeo 1-2 min
Subir un vídeo a YouTube 5-10 segundos
Subir un audio a Internet Archive 10 s, más 1-2 min de indexado
Publicar en Telegram 1-2 min
Publicar en X 3-5 min
Publicar en LinkedIn 5-10 min
Hasta tenerlo todo publicado 25-35 min
Con la difusión en redes incluida 40-50 min

Dos cosas llaman la atención en esa lista. La primera, que lo que tarda no es el trabajo, sino la espera: generar el vídeo y el pódcast se lleva la mitad del tiempo, y ahí no hay nada que hacer salvo aprovecharlo. La segunda, que publicar en LinkedIn a mano cuesta más que todo el proceso de creación, y es justo la parte que ningún programa puede acortar.

De la redacción no hay cronómetro: es lo único que no ejecuta un script, y sucede mientras Google genera, así que no añade tiempo al total.

Qué he aprendido de todo esto

La automatización no elimina el criterio, lo reparte. Dentro del proceso hay dos momentos que exigen pensar —decidir qué merece contarse de la semana y comprobar que lo transcrito tiene sentido—, y esos los ejerce el agente. Pero por encima queda un tercero que no se delega: decidir si el resultado vale. Ese sigue siendo de quien firma la publicación, y es el que corrige las cosas que el agente no puede ver desde dentro. Lo que ha desaparecido es el trabajo mecánico que rodeaba a todos ellos: descargar, renombrar, convertir, pegar, subir, verificar.

Lo que no se verifica, falla en silencio. Cada paso comprueba su propio resultado, porque un proceso que publica sin mirar acaba publicando basura durante semanas sin que nadie se entere.

Ha llegado a ocurrir: una de las seis generaciones se encargó correctamente, pero su identificador no llegó a quedar anotado en la lista de encargos pendientes. La descarga terminó con cinco piezas de seis, informó de que todo había ido bien y no dio ningún error. Lo delató contar los archivos. El proceso ya comprueba que eso no vuelva a pasar, pero la lección es la de siempre: un programa solo detecta los fallos que alguien previó.

Pero hay errores que ninguna comprobación automática detecta. Un resumen de la semana equivocada pasa todos los controles técnicos con sobresaliente: el archivo existe, pesa lo que debe y el enlace funciona. Todo perfecto salvo lo único que importaba, que es el contenido. Por eso la revisión final es de otra naturaleza —abrir la infografía y leerla, escuchar un fragmento del audio— y por eso la hace también una persona: quien produce algo tiende a darlo por bueno, y la mirada que puede decir «esto no vale, hazlo otra vez» tiene que venir de fuera.

Para quien esté pensando en algo parecido

No hace falta empezar por aquí. Este sistema funciona porque se construyó en el orden correcto: primero haciendo el boletín a mano, hasta entender bien cada paso; después escribiendo esa experiencia como skill; y solo entonces automatizando lo que ya se hacía siempre igual.

Y la parte más aprovechable no es la más técnica. Escribir la skill —dejar por escrito, con precisión, cómo se hace algo que ya sabes hacer— es una tarea docente de toda la vida, y sirve para cualquier rutina que se repita cada curso: preparar las actas, montar los grupos, redactar los informes trimestrales. Ese documento vale por sí solo, aunque nunca llegue a automatizarse nada.

El resultado, al final, no es un ahorro de tiempo. Es que cada semana de conversación de dos comunidades docentes queda recogida, resumida, escuchable y consultable, en vez de perderse en el desplazamiento infinito de un grupo de Telegram. Eso antes no se hacía porque no había tiempo material para hacerlo. Ahora se hace todas las semanas.


Artículo redactado por Claude (Anthropic) bajo la guía de Juan José de Haro. El sistema que aquí se describe —los scripts, la skill que lo documenta y las soluciones a los problemas que fueron surgiendo— se construyó entre los dos: él decidiendo qué debía hacer el proceso, probándolo, señalando lo que fallaba y exigiendo que se rehiciera cuando hacía falta; el agente escribiendo el código, la documentación y este texto. Otros agentes ejecutan el proceso algunas semanas, y alguno ha revisado puntualmente este trabajo.

Nota: Este artículo tiene nivel 5 en el Marco para la integración de la IA generativa, excepto la introducción, que tiene nivel 1.

© 2026 Bilateria

Tema por Anders NorenArriba ↑