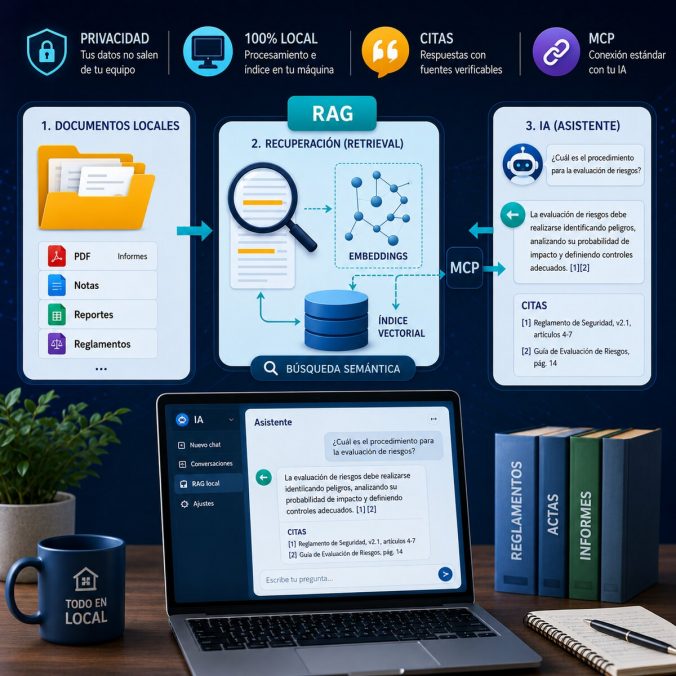
Cualquier persona que trabaje con documentación acumula un fondo de textos que consulta una y otra vez: normativa, actas, memorias, apuntes, artículos. Preguntarle a una inteligencia artificial sobre ese material choca siempre con el mismo muro: hay que subirlo a algún sitio, o pegarlo en la conversación, o confiar en que el modelo lo recuerde de su entrenamiento, cosa que no ocurre.
Este artículo explica qué es un RAG (Retrieval Augmented Generation, en español «generación aumentada por recuperación»), qué es el protocolo MCP (Model Context Protocol, en español «protocolo de contexto del modelo») que hace posible esa conexión, cómo funciona el conjunto y cómo montarlo sin escribir una línea de código.
Si solo quieres las instrucciones, ve directamente a la guía rápida del final: reúne las tres que hacen falta, listas para copiar y pegar. El resto del artículo explica qué hace cada una y por qué, que es lo que permite juzgar si el resultado es bueno.
El código está publicado: el sistema completo que se describe aquí, con un fondo documental de ejemplo ya indexado, está en github.com/jjdeharo/cuadernos-rag, con licencia libre. Quien prefiera verlo antes de leer nada más, puede empezar por ahí.
Qué es un RAG
Un buscador colocado delante de una inteligencia artificial.
Un modelo de lenguaje, que es el programa que hay detrás de ChatGPT, Claude o Gemini, no puede leer mil páginas cada vez que recibe una pregunta porque no caben en una consulta y, aunque lo hiciese, resultaría lento y costoso. Lo que hace un RAG es localizar primero los pocos fragmentos que hacen falta para responder a esa pregunta concreta, y entregar solo eso. El modelo no aprende los documentos ni los memoriza: los consulta, como haría cualquiera con un libro delante, e indica de dónde ha salido cada afirmación.
La consecuencia práctica es doble. Por un lado, deja de haber límite de volumen: da igual que el fondo documental sean quinientas páginas o veinte mil, porque en cada consulta solo viajan unos pocos fragmentos. Por otro, y más importante, cada respuesta puede citar su fuente. En materia normativa o técnica, una respuesta sin fuente no tiene ningún valor.
Qué es el MCP
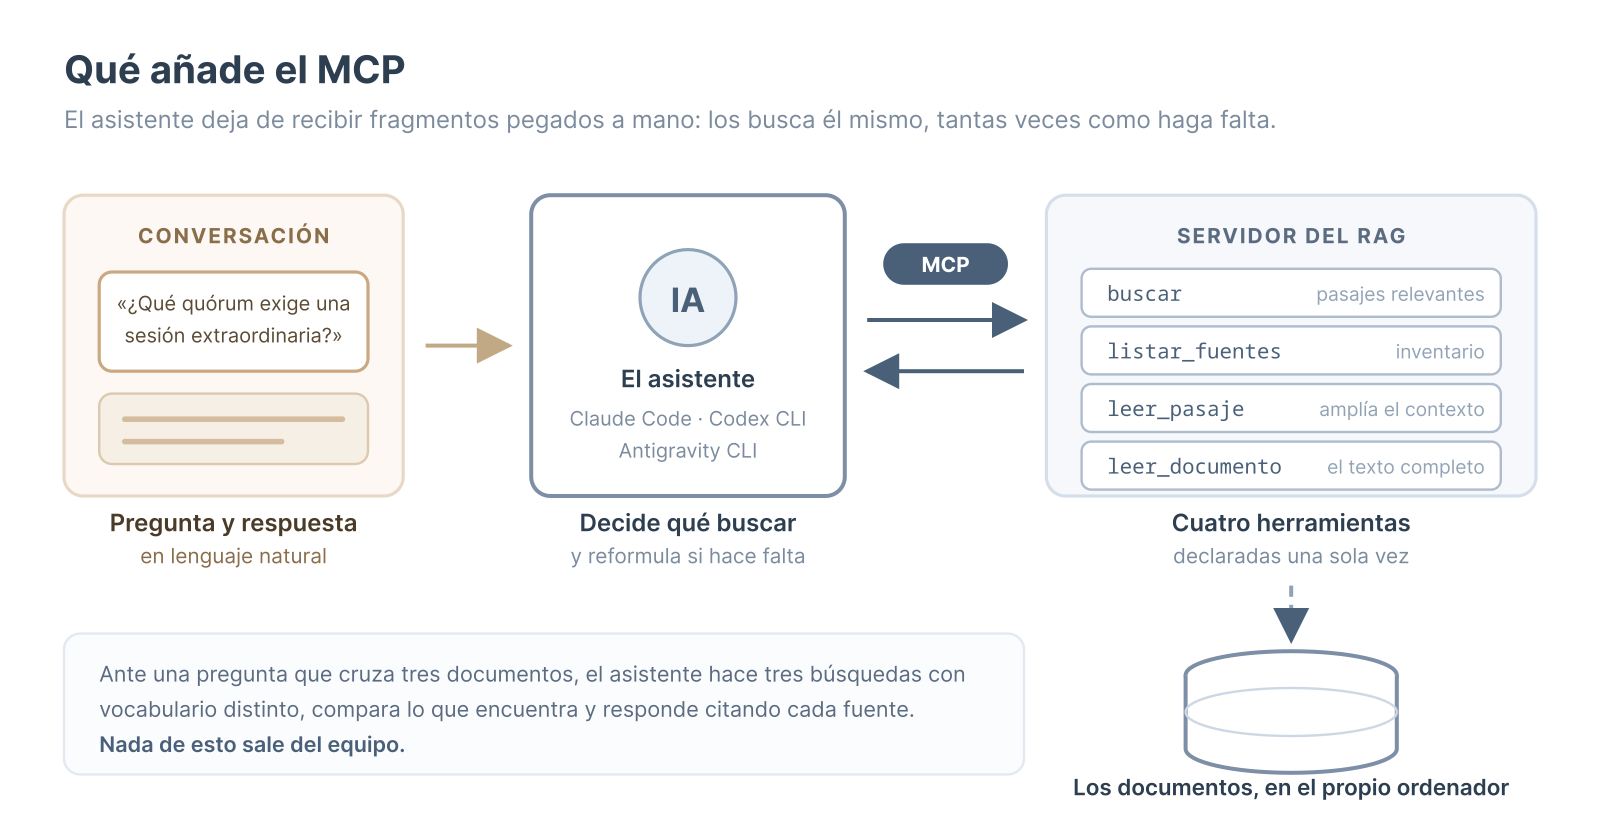
Un RAG, por sí solo, es una herramienta de línea de comandos: se le hace una pregunta y devuelve fragmentos. Útil, pero incómodo.
MCP son las siglas de Model Context Protocol, un estándar abierto propuesto por Anthropic a finales de 2024 y adoptado después por los demás asistentes. Resuelve un problema muy concreto: cómo permitir que una IA use herramientas externas sin que haya que programar una integración distinta para cada combinación de herramienta y asistente. Con MCP, quien construye la herramienta la describe una sola vez, y cualquier asistente compatible sabe cómo usarla.
Aplicado a un RAG, el cambio es importante, ya que en lugar de ejecutar búsquedas a mano y pegar los resultados en una conversación, el asistente busca por su cuenta, tantas veces como necesite. Ante una pregunta que cruza tres documentos distintos, hace tres búsquedas con vocabulario distinto, compara lo que encuentra y responde citando cada fuente. El fondo documental deja de ser un archivo aparte y pasa a estar dentro de la conversación.
Un servidor MCP no es más que un programa que declara qué sabe hacer. En el caso de un RAG documental, cuatro operaciones bastan: buscar pasajes, listar los documentos disponibles, ampliar el contexto de un pasaje concreto y recorrer un documento entero. El asistente decide cuándo usar cada una.
Conviene añadir una instrucción que gobierne su uso, porque sin ella el asistente tenderá a responder de memoria. Basta con una regla explícita: no afirmar nada que no proceda de una búsqueda, buscar varias veces reformulando con el vocabulario propio de cada fuente, citar siempre el identificador del pasaje, y decir con claridad cuándo el fondo documental no cubre la pregunta.
Cómo funciona por dentro
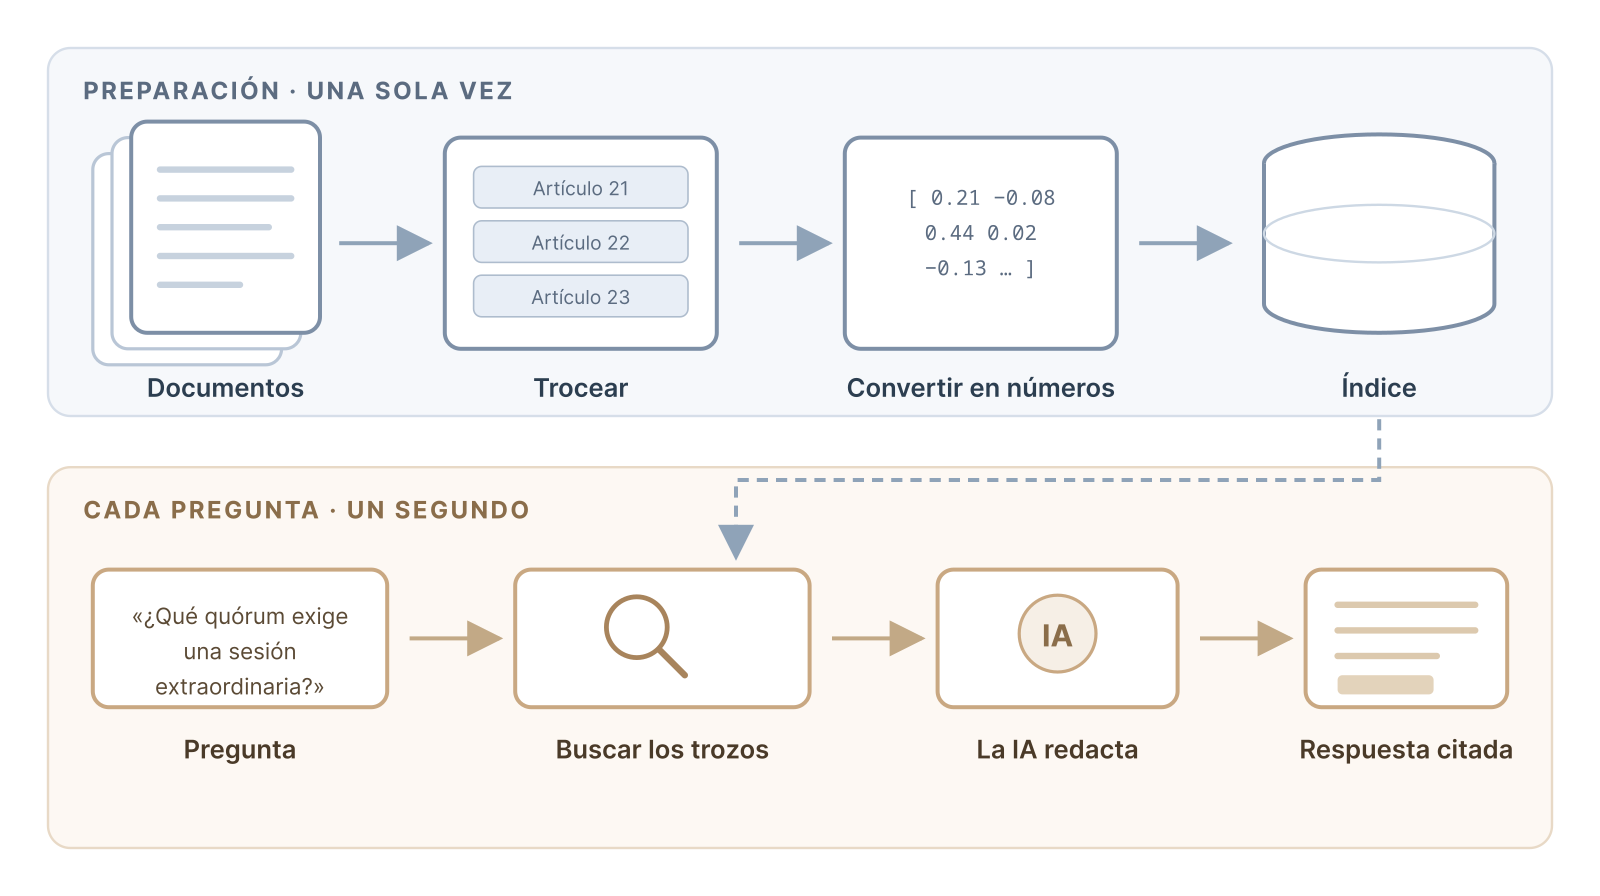
Son cuatro piezas, y solo la última tiene que ver con la inteligencia artificial tal y como la entiende la mayoría.
Convertir a texto. PDF, páginas web, documentos de Word, audio transcrito: todo tiene que acabar siendo texto plano. Un PDF no guarda un texto, guarda dónde va cada letra en la página; al leerlo hay que reconstruir el orden, y en tablas o en textos a dos columnas se falla a menudo. Es la pieza menos vistosa y la que estropea el resultado con más frecuencia.
Trocear. Consiste en partir cada documento en fragmentos manejables y, aunque parezca un detalle de poca importancia, es lo que más determina la calidad final. Un troceado rudimentario corta cada mil palabras sin atender a dónde cae el corte, mientras que uno cuidadoso respeta la estructura del texto: en una norma, por ejemplo, un fragmento por artículo. La diferencia se aprecia en cuanto se formula una consulta concreta, porque en el primer caso llega un trozo que empieza a mitad de un artículo y se interrumpe antes de acabar el siguiente, mientras que en el segundo llega el artículo completo, con su título.
Convertir cada fragmento en números. De esto no se encarga un asistente de los que conversan, sino un programa mucho más pequeño, entrenado para una sola tarea: no redacta ni responde nada, solo lee un texto y devuelve números. A cada fragmento le asigna una lista de más de mil números que funciona como unas coordenadas: igual que una latitud y una longitud sitúan un lugar en un mapa, esos números sitúan el fragmento en un espacio donde la posición depende del significado. Los textos que hablan de lo mismo quedan cerca unos de otros, aunque estén escritos con palabras distintas; los que hablan de cosas diferentes quedan lejos.
A partir de ahí, buscar deja de ser comparar palabras y pasa a ser medir distancias. La pregunta se convierte también en un punto de ese mapa, y el sistema devuelve los fragmentos que han quedado más cerca. Por eso una consulta como «¿cuánta gente hace falta para que la reunión sea válida?» encuentra un párrafo que habla del «quorum de constitución», sin que compartan una sola palabra.
Buscar y citar. La búsqueda por significado es muy eficaz y tiene un punto ciego: los nombres propios y las referencias exactas. Ante una consulta por un artículo numerado o por unas siglas, falla, porque esas expresiones no significan nada, solo nombran. Por eso se hacen dos búsquedas a la vez (la de significado y la literal, por palabras) y se combinan los resultados. Después, un segundo modelo igual de mudo, llamado reranker, relee los mejores candidatos junto a la pregunta y los reordena. De ahí salen los fragmentos que se entregan al asistente, cada uno con su procedencia.
Todo esto ocurre en el propio ordenador, y conviene distinguir las tres piezas que intervienen, porque en la jerga a las tres se las llama «modelos» y no son lo mismo:
- El conversor a números, o modelo de embeddings, que traduce cada fragmento a su lista de coordenadas. Ocupa unos dos gigabytes.
- El reordenador, o reranker, que afina la lista de candidatos que ha devuelto la búsqueda. Ocupa algo más de uno.
- El asistente, Claude, ChatGPT, Gemini, que es el que redacta la respuesta final.
Los dos primeros viven en el disco, se descargan una vez y funcionan sin conexión y sin coste. Mientras se consulta, además, se cargan en memoria: conviene tener unos cuatro gigabytes de RAM libres, aparte de los tres y medio que ocupan en el disco. Es un gasto que solo dura lo que dura la consulta, porque un sistema bien montado los suelta cuando pasan unos minutos sin preguntas. No conversan ni generan texto: entra un texto y sale un resultado numérico. Solo el tercero es lo que la mayoría llama «una IA», y no ve el fondo documental entero, sino los pocos fragmentos que la búsqueda le pone delante. Ningún documento sale del equipo.
Cómo montarlo sin saber programar
Hacen falta dos cosas: los documentos y un asistente que trabaje dentro del ordenador, con permiso para escribir programas y ejecutarlos. Hoy hay tres opciones equivalentes, y todas están disponibles tanto en el terminal como en una aplicación de escritorio, para quien prefiera no escribir órdenes:
- Claude, de Anthropic: la orden
claudeen el terminal, o la aplicación de escritorio, que reúne tres modos: conversación, Claude Code y Cowork. - Codex, de OpenAI: la orden
codexen el terminal, o su aplicación de escritorio, disponible para macOS, Windows y Linux. - Antigravity, de Google: un entorno de escritorio
propio y la orden
agyen el terminal, que desde junio de 2026 sustituye al anterior Gemini CLI.
Cualquiera de ellas sirve, y se instalan en un minuto. Lo único que importa es que el asistente pueda leer y escribir ficheros en las carpetas del equipo y ejecutar órdenes en él.
Esas tres son las que montan el sistema, y para eso conviene un modelo potente. Pero una vez montado, quien lo consulta a diario puede ser otro, y ahí entra una cuarta posibilidad: un modelo instalado en el propio ordenador. LM Studio es el camino sencillo, una aplicación de escritorio para Windows, macOS y Linux con una tienda de modelos integrada, que además reconoce el servidor del RAG igual que lo haría cualquier asistente comercial. llama.cpp es la alternativa para quien no quiera aplicación gráfica, con algo más de soltura técnica a cambio.
Merece la pena por una razón concreta. Con un asistente comercial, los documentos no salen del equipo, pero los pocos fragmentos que la búsqueda selecciona viajan con cada pregunta. Para normativa pública da igual; para un expediente o unas actas con nombres propios, no. Con un modelo local no sale nada: ni los documentos, ni los fragmentos, ni las preguntas. El precio es real, eso sí: sin una tarjeta gráfica potente, la respuesta tarda decenas de segundos, y los modelos que caben en un ordenador corriente citan con menos rigor. Para material sensible compensa; para material público, el asistente de siempre responde mejor y antes.
Conviene comprobar un detalle en las modalidades que trabajan dentro de una máquina virtual aislada, como el modo Cowork: si esa máquina es remota, los documentos salen del ordenador, que es justo lo que se pretendía evitar. Las versiones que operan directamente sobre las carpetas locales no plantean ese problema.
A partir de ahí basta con encargar el trabajo. La instrucción que sigue está escrita para el asistente, no para quien la copia: no hace falta entender cada línea, porque cada una le pide una decisión técnica concreta y le impide tomar el atajo de cobrar por el servicio o de subir el material a algún sitio.
Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.
Esa última petición es la más importante de todas, y conviene no saltársela: obliga al asistente a enseñar cómo piensa partir los documentos antes de ponerse a trabajar, que es donde se decide casi todo. Basta con leer su propuesta y comprobar que respeta la estructura del material (los artículos de una norma, los puntos del orden del día de un acta, los capítulos de un informe) en lugar de cortar cada tantas palabras.
Las tres condiciones finales también merecen explicación. La de las citas separa una herramienta de consulta de un generador de respuestas plausibles. La de la memoria evita el descuido más caro de todos: un servidor que carga los dos modelos nada más arrancar y se queda con tres gigabytes ocupados aunque nadie pregunte nada, multiplicado por cada programa que lo tenga conectado. Y la del indexado incremental evita un error frecuente: una primera versión que rehace el trabajo entero cada vez que se añade o corrige un documento, con tres cuartos de hora de cálculo en cada ocasión.
La alternativa a construirlo desde cero es partir de algo que ya funciona. El código de un sistema así, con todo lo descrito, está publicado en github.com/jjdeharo/cuadernos-rag bajo licencia libre. Incluye, a modo de ejemplo, un fondo documental de quince normas y guías sobre uso ético y legal de la IA en educación (el RGPD, la LOPDGDD, el reglamento europeo de inteligencia artificial, guías de la Agencia Española de Protección de Datos, marcos de la UNESCO), ya indexado y listo para consultar. Ese ejemplo concreto importa poco: lo aprovechable es la estructura, que sirve igual para actas municipales, bibliografía académica o documentación técnica de una empresa.
Añadir nuevos cuadernos
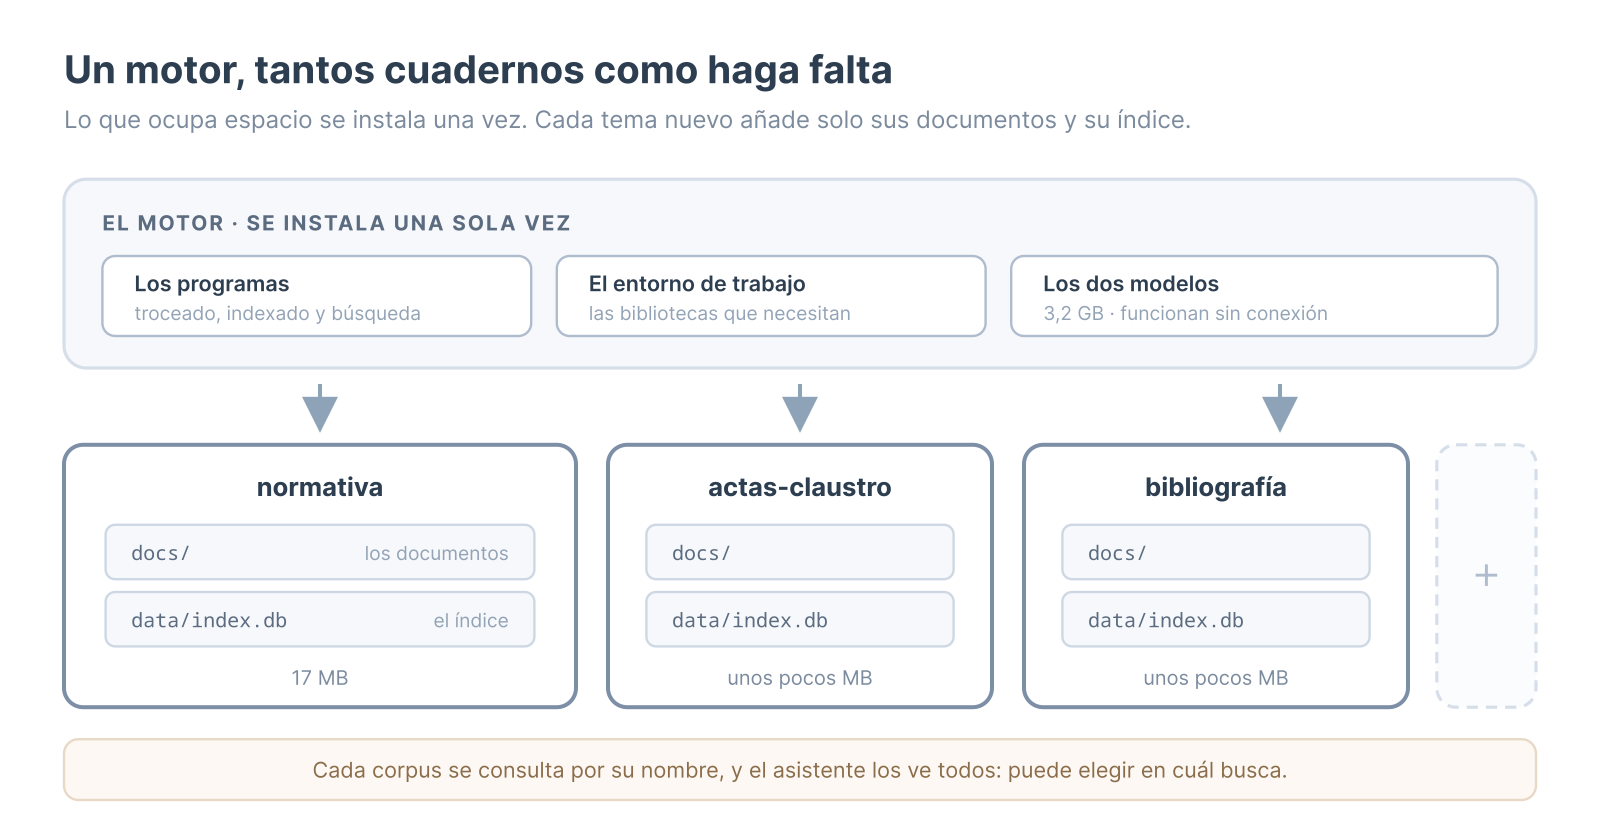
Esta es la parte que suele quedar sin explicar, y es la que convierte un experimento en una herramienta de uso diario.
Quien viene de Gemini Notebook está acostumbrado a tener un cuaderno por tema: uno de normativa, otro de actas, otro con la bibliografía de un curso. Aquí funciona igual, y con una ventaja: lo que ocupa espacio, que son los programas y los dos modelos, más de tres gigabytes, se instala una sola vez y lo comparten todos los cuadernos. Cada tema nuevo añade únicamente sus documentos y su índice, unos pocos megabytes. No hay límite de cuadernos ni cuota que agotar.
Crear uno nuevo no exige tocar nada por dentro: basta con pedírselo al asistente en la misma conversación de siempre, indicando dónde están los documentos y qué nombre quieres darle. Él prepara la carpeta, convierte los PDF a texto, repara las palabras que la maquetación parte con guiones, descarta lo que no sea texto aprovechable y construye el índice. Un cuaderno de unos cuantos PDF está listo en unos minutos.
La instrucción, otra vez escrita para el asistente y no para quien la copia:
Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.
Lo importante es la primera condición. Sin ella, el asistente puede ponerse a instalarlo todo de nuevo, con otra copia de los modelos, y el ordenador acaba con tres gigabytes repetidos por cada cuaderno.
Añadir documentos a un cuaderno que ya existe es todavía más simple: se dejan los ficheros nuevos y se pide que lo actualice. Aquí importa una de las condiciones que se le exigieron al montarlo, la del indexado incremental: el sistema guarda una huella de cada documento y solo procesa los que han cambiado, así que incorporar un PDF cuesta el tiempo de ese PDF, alrededor de un minuto por cada cien mil caracteres, y no el del fondo entero. Sin esa condición, añadir una circular de dos folios obligaría a rehacerlo todo.
Al preguntar, con un solo cuaderno no hace falta decir cuál; con varios, se nombra el que interesa. El asistente los ve todos y, si la pregunta lo pide, puede buscar en el que corresponda.
Cuándo montar un RAG
Con poco material no hace falta montar nada.
Los modelos actuales procesan cientos de miles de palabras de una sola vez. Por debajo de unas trescientas páginas, basta con dejar los documentos en una carpeta y pedirle al asistente que los lea directamente. Buscando por su cuenta, acierta más que cualquier RAG, porque puede leer, releer y afinar la búsqueda tantas veces como haga falta. Entre trescientas y mil quinientas páginas hay una zona intermedia: el material cabe, pero se relee entero en cada pregunta, y eso resulta lento y caro en una consulta diaria, por lo que se aconseja montar el RAG. Por encima de mil quinientas páginas ya no cabe, y el RAG deja de ser opcional.
El criterio es el volumen de texto, no el número de archivos. Cincuenta circulares de dos folios no llegan a cien páginas; tres memorias anuales pueden superar las mil.
Guía rápida
Las tres instrucciones, sin explicaciones. Se pegan tal cual en Claude, Codex o Antigravity, sustituyendo lo que va entre ángulos.
1. Montar el primer cuaderno. Una sola vez.
Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.
2. Crear otro cuaderno, reutilizando lo ya instalado.
Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.
3. Añadir documentos a un cuaderno que ya existe. Lo más frecuente con el tiempo.
Añade estos documentos al cuaderno <nombre>:
<carpeta o lista de ficheros>

- Trátalos igual que los que ya están: mismo troceado
  y misma limpieza.
- Aprovecha el indexado incremental: procesa solo lo
  nuevo, sin rehacer el índice entero.
- Al terminar, dime qué has añadido y qué documentos
  contiene ahora el cuaderno.
En los tres casos conviene leer lo que responde antes de dejarle continuar. Si su plan no respeta la estructura de los documentos (los artículos de una norma, los puntos del orden del día de un acta), es el momento de decírselo, porque de ese detalle depende la calidad de todas las respuestas posteriores.
Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.




Comentarios recientes