Blog sobre educación

Etiqueta: CLI

Consolas de IA: qué son y cómo se instalan

Hace un año escribí una guía sobre el uso de la inteligencia artificial desde la terminal. Lo esencial sigue siendo válido, pero una parte importante ha quedado desfasada: casi todas estas herramientas han pasado a requerir una suscripción de pago. Quien siga hoy aquellas instrucciones se encontrará con límites y precios que entonces no existían.

Este artículo pone al día el panorama. Es una introducción breve para quien empieza: qué son estas consolas, qué cuesta cada una en septiembre de 2026, cómo se instalan y cómo se dan los primeros pasos.

Pódcast del artículo realizado por Gemini Notebook

Pódcast del artículo realizado por Gemini Notebook

Qué son

Estamos acostumbrados a usar la IA en una página web. Una consola de IA es el mismo modelo, pero instalado en nuestro ordenador y manejado desde una ventana de texto: la terminal del sistema. Se habla con ella igual que en el chat, escribiendo lo que queremos.

La diferencia no está en la conversación, sino en lo que puede hacer. La IA en la web no ve nuestro ordenador: hay que subirle los archivos de uno en uno y bajar después los resultados. La consola trabaja directamente en la carpeta desde la que la hemos abierto, así que puede leer, escribir, convertir y ordenar decenas de archivos sin que intervengamos. Renombrar con un criterio común las fotos de una salida, convertir a PDF los documentos de una unidad, sacar la transcripción de unos audios o construir un recurso interactivo de varios archivos son tareas que en la web resultan tediosas y en la consola se piden en una frase.

No hace falta un ordenador potente. El programa solo pone en contacto nuestro equipo con el servicio en Internet, de modo que un portátil modesto es suficiente.

Lo que ha cambiado: ahora casi todo es de pago

El cambio de este año afecta a lo esencial, que es el acceso. Lo que en 2025 era gratuito y generoso hoy está limitado o cerrado.

  • Gemini CLI ya no existe para el usuario particular. Google la limitó primero a los modelos Flash y, el 18 de junio de 2026, dejó de atender peticiones de las cuentas personales, tanto gratuitas como de pago. Su sustituta es Antigravity CLI, que se instala aparte y se abre con la orden agy. Gemini CLI sobrevive solo para las licencias corporativas de Gemini Code Assist y para quien pague por clave de API.
  • Qwen Code era la alternativa gratuita. Su acceso libre con cuenta de Qwen se retiró el 15 de abril de 2026 y ahora necesita un plan de Alibaba Cloud o una clave de API de pago.
  • Codex, en cambio, ha ido en sentido contrario: OpenAI lo ha incluido en todos los planes de ChatGPT, incluido el gratuito, aunque en este último solo para un uso mínimo.
  • Claude Code nunca fue gratuito y sigue sin serlo.
  • Copilot CLI, de GitHub, tampoco funciona con el plan gratuito de Copilot.
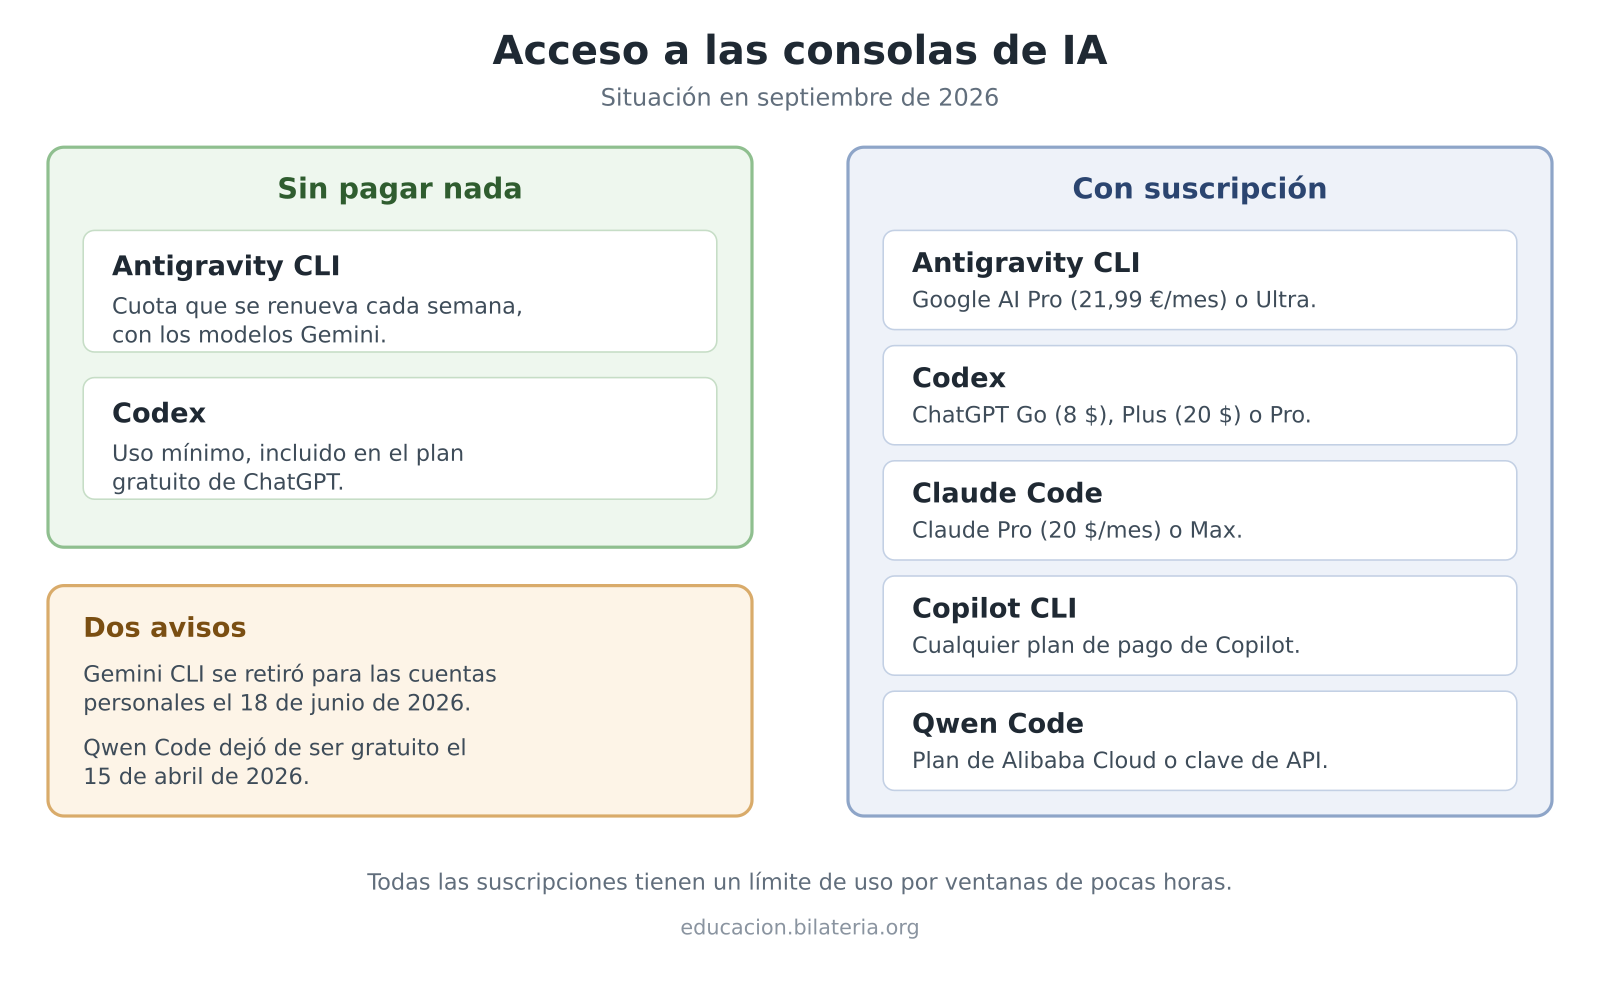
Qué hay hoy y qué cuesta

Consola Empresa Sin pagar nada Con suscripción
Antigravity CLI Google Sí, con una cuota que se renueva cada semana Google AI Pro (21,99 €/mes) o Ultra, con cuota mayor cada cinco horas
Codex OpenAI Sí, uso mínimo con el plan gratuito de ChatGPT ChatGPT Go (8 $), Plus (20 $) o Pro (desde 100 $)
Claude Code Anthropic No Claude Pro (20 $/mes) o Max (desde 100 $)
Copilot CLI GitHub No Cualquier plan de pago de Copilot
Qwen Code Alibaba No desde abril de 2026 Plan de Alibaba Cloud o clave de API

Dos advertencias sobre los precios, que son los del 10 de septiembre de 2026 y conviene comprobar antes de pagar:

  • El plan Google AI Plus (4,99 €/mes) no amplía nada aquí. Es el más barato de Google y resulta tentador, pero para la consola cuenta igual que no tener plan: la cuota mayor es solo de AI Pro y AI Ultra.
  • Las suscripciones incluyen un límite de uso por ventanas de pocas horas. En un trabajo intenso se agota antes de lo que parece, y entonces no queda más que esperar o pagar más.

Existen también consolas de código abierto, como OpenCode, que funcionan con el modelo que se les indique, incluidos los de proveedores más económicos o los que se ejecutan en el propio ordenador. Son flexibles, pero exigen configurarlas y entender qué se está contratando, así que no son el punto de partida recomendable.

Instalación

Primero se abre la terminal del sistema operativo:

  • Windows: pulsar la tecla de Windows, escribir PowerShell y abrir el programa.
  • Mac: abrir Launchpad, escribir Terminal y hacer clic en la aplicación.
  • Linux: buscar Terminal en el menú de aplicaciones, o pulsar CTRL + ALT + T.

Y allí se escribe una de las siguientes órdenes, según la consola que se quiera instalar. Basta elegir una herramienta: no hay ninguna ventaja en instalar las tres.

Antigravity CLI, la de Google. En Mac y Linux:

curl -fsSL https://antigravity.google/cli/install.sh | bash

Y en Windows, desde PowerShell:

irm https://antigravity.google/cli/install.ps1 | iex

Ninguna de las tres necesita ya Node.js: las tres traen su propio instalador. Si alguien tiene todavía instalada la antigua Gemini CLI, puede desinstalarla: con una cuenta personal ya no responde.

Codex, la de OpenAI. En Mac y Linux:

curl -fsSL https://chatgpt.com/codex/install.sh | sh

Y en Windows, desde PowerShell:

powershell -ExecutionPolicy ByPass -c "irm https://chatgpt.com/codex/install.ps1 | iex"

Claude Code, la de Anthropic. En Mac y Linux:

curl -fsSL https://claude.ai/install.sh | bash

Y en Windows, desde PowerShell:

irm https://claude.ai/install.ps1 | iex

Si algo falla, lo más práctico es copiar el mensaje de error y pegárselo a la IA de la web: son errores conocidos y los resuelve en un par de intentos.

Los primeros pasos

Abrir la consola en la carpeta de trabajo

Esto es lo más importante y lo que más se olvida. La IA trabaja sobre la carpeta desde la que se ha arrancado, de modo que nunca conviene abrirla en la carpeta personal ni en la raíz del disco, donde tiene a la vista todo lo que guardamos. Se crea una carpeta para el trabajo en cuestión y se abre allí:

  • En Windows, abrir la carpeta en el explorador de archivos, pulsar CTRL + L y escribir powershell.
  • En Mac, desde Finder, con el botón derecho sobre la carpeta y «Nueva terminal en la carpeta».
  • En Linux, con el botón derecho en un espacio vacío de la carpeta y «Abrir en un terminal».

Una vez dentro, se escribe agy, codex o claude, según lo que hayamos instalado, y se pulsa Enter. La primera vez se abrirá el navegador para iniciar sesión con nuestra cuenta; después ya no lo volverá a pedir.

Hablar con ella

A partir de aquí se escribe lo que queremos, en lenguaje corriente y con el mismo detalle que en la web. Conviene empezar por algo inofensivo y comprobable, como pedirle que describa lo que hay en la carpeta.
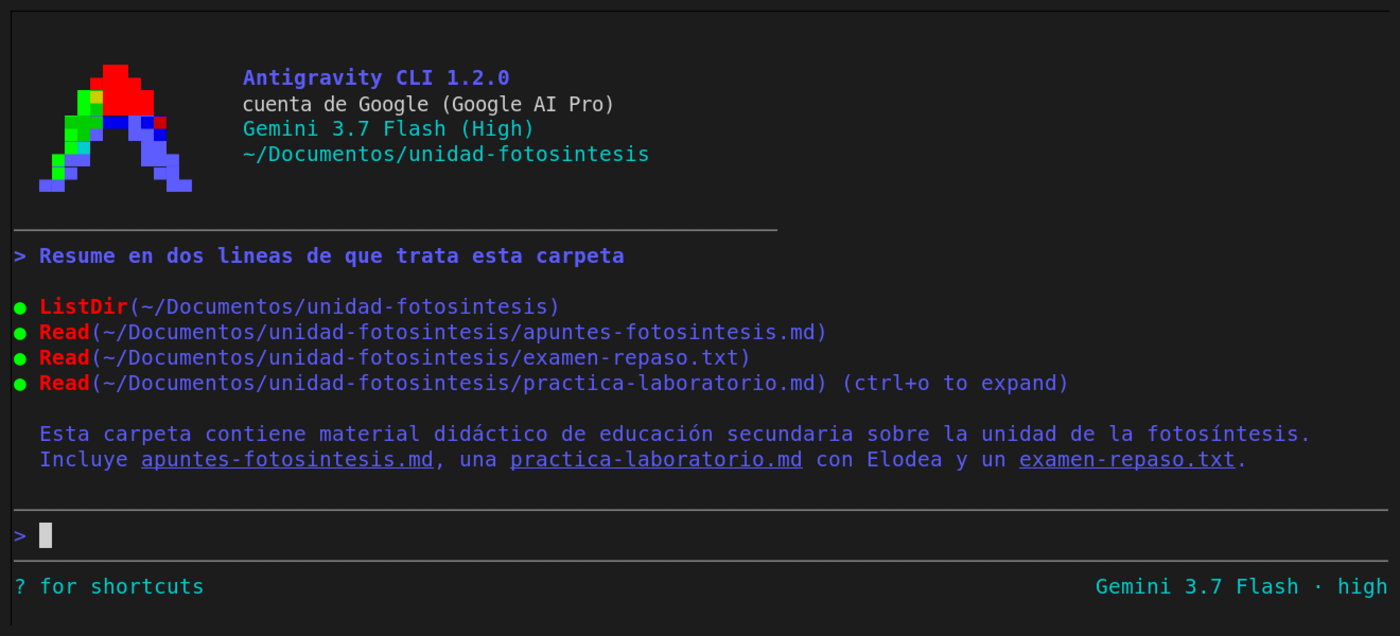
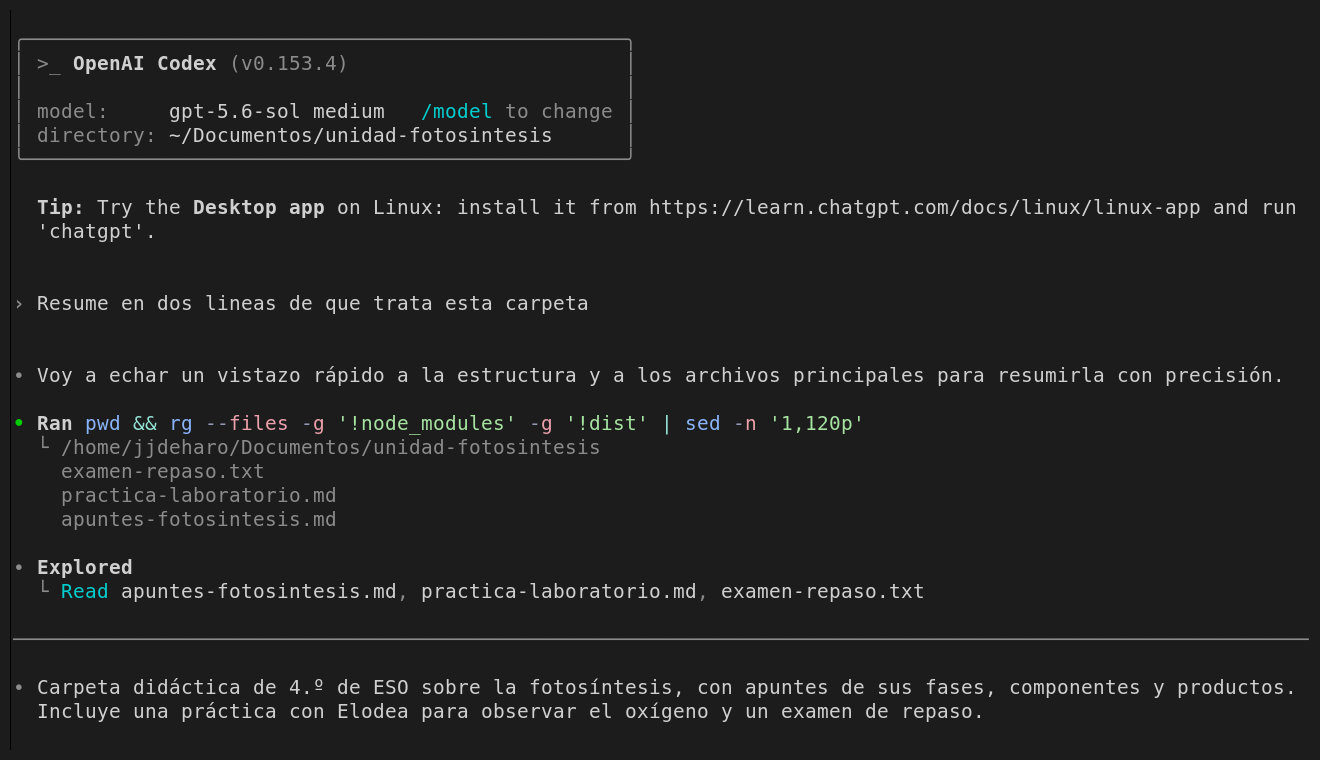
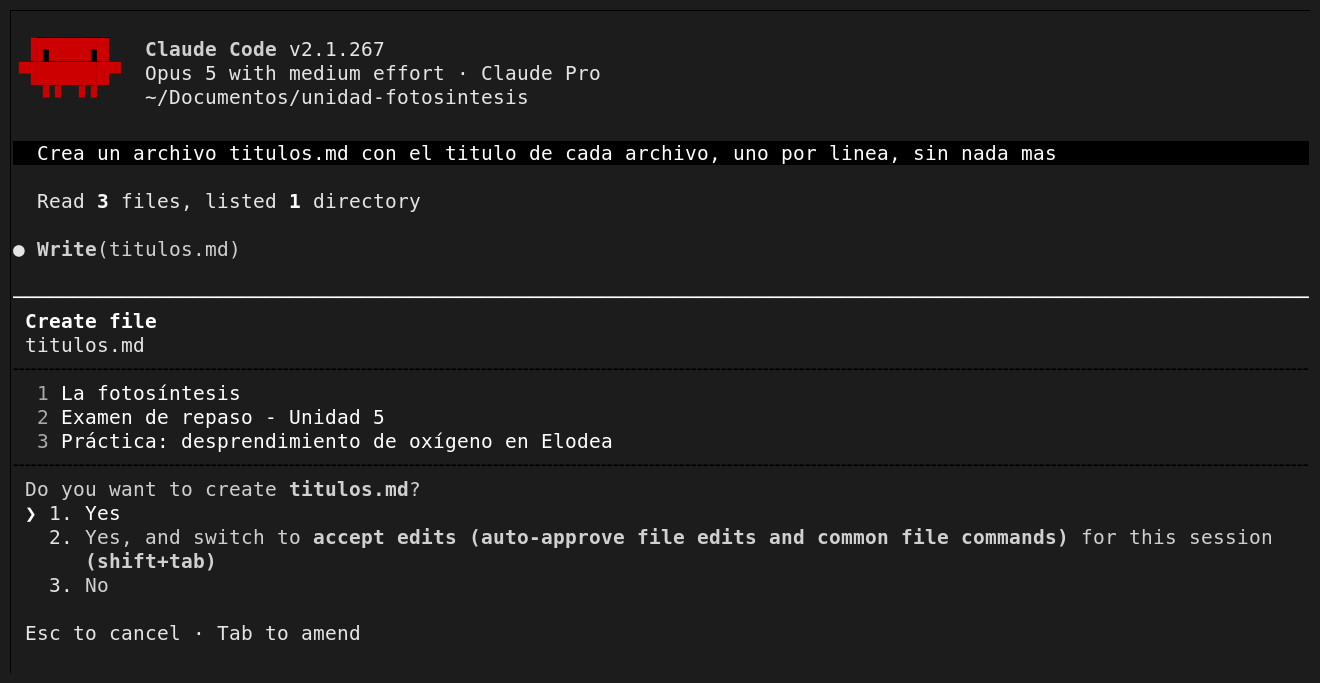
Cuando la tarea implique tocar nuestros archivos o ejecutar un programa, pedirá permiso. Se le puede dar una sola vez o para el resto de la sesión. Es la protección principal que tenemos: merece la pena leer qué pide antes de aceptar.
Cuatro comandos que sirven en todas

  • / muestra la lista completa de comandos disponibles, con una descripción de cada uno. Son muchos, y esta es la forma de descubrirlos sin buscar en la documentación.
  • /model indica qué modelo se está usando y permite cambiarlo, en las tres. Conviene usarlo en lugar de fiarse de lo que se leyó en un artículo: los modelos cambian cada pocos meses. Codex y Claude Code tienen además /status, que muestra el plan y el consumo, y Antigravity CLI, /usage, que muestra cuánta cuota queda.
  • /init hace que examine la carpeta y escriba un resumen de lo que contiene, que usará como memoria a partir de entonces. Está en Codex y en Claude Code, y conviene ejecutarlo al empezar en una carpeta que ya tenga archivos; Antigravity CLI no lo tiene.
  • /exit cierra la consola, y en Codex y Claude Code vale también /quit. En las tres se consigue lo mismo pulsando dos veces CTRL + C.

Darle memoria

Cada consola lee, al arrancar, un archivo de texto en formato Markdown con instrucciones permanentes que hay que dejar en la carpeta de trabajo: AGENTS.md para Antigravity CLI y para Codex, y CLAUDE.md para Claude Code. Codex y Claude Code buscan además uno general en su carpeta de configuración (~/.codex y ~/.claude, y en Windows %USERPROFILE%\.codex y %USERPROFILE%\.claude), que se aplica a todo lo que hagamos con ellas.

Es el equivalente a la personalización de los chats web, y vale la pena dedicarle diez minutos: nuestro nombre, las asignaturas que impartimos, el nivel del alumnado o la licencia que queremos en todo lo que produzca. Se escribe una vez y lo tiene en cuenta siempre.

Tres atajos que ahorran tiempo

Cuando la consola deja de dar respeto, estos tres recursos son los que más se usan a diario.

Arrancar con el trabajo ya encargado. No hace falta abrir la consola y escribir después: la instrucción puede ir en la misma orden de arranque, y la consola aparece ya trabajando. En Antigravity CLI se pasa con -i, y en Codex y Claude Code basta con escribirla detrás, entre comillas:

agy -i "Lee los archivos .txt de esta carpeta y dime qué contienen"
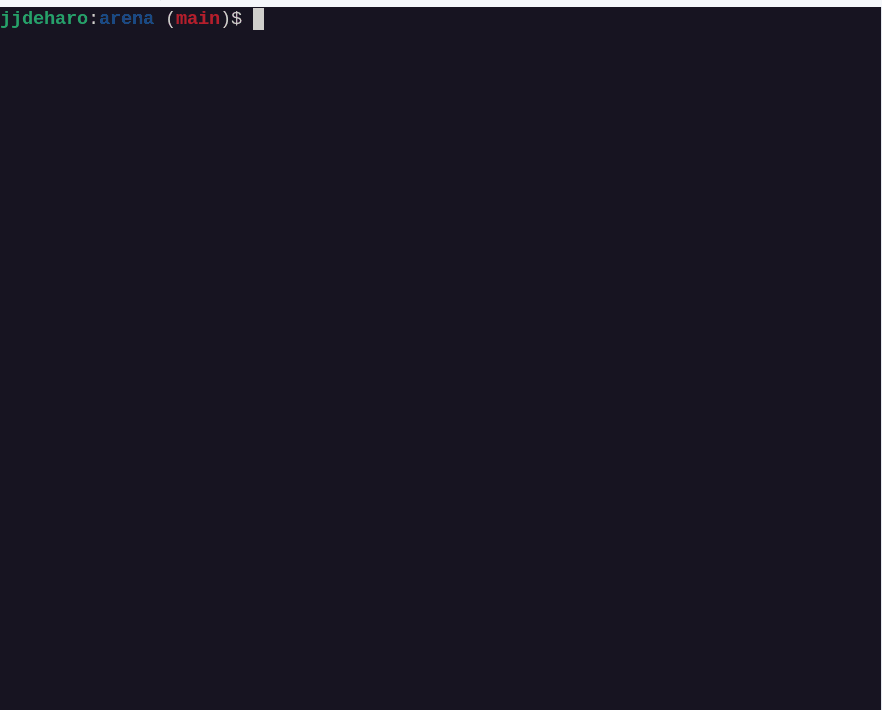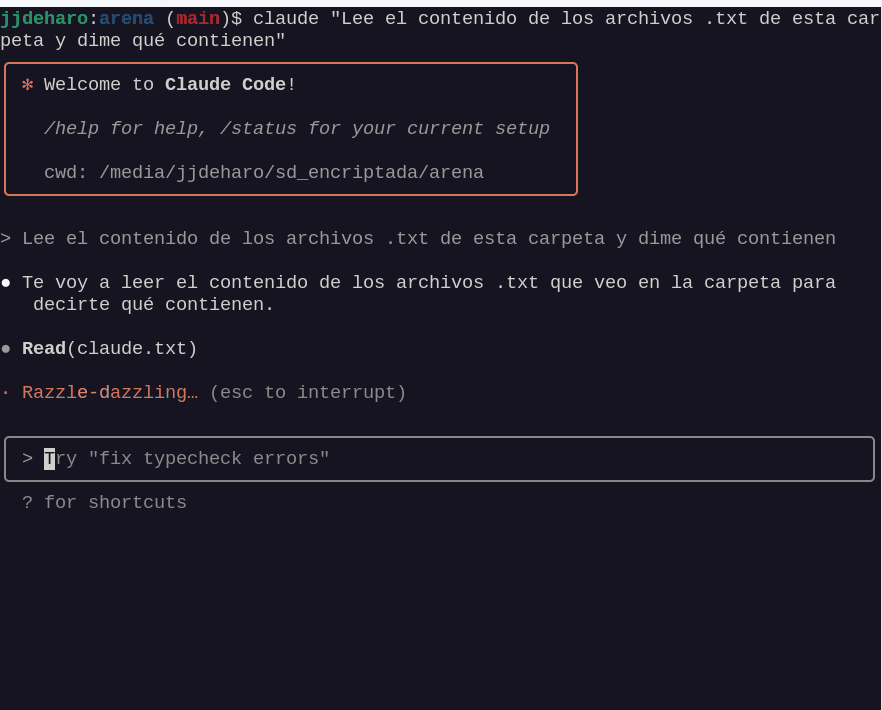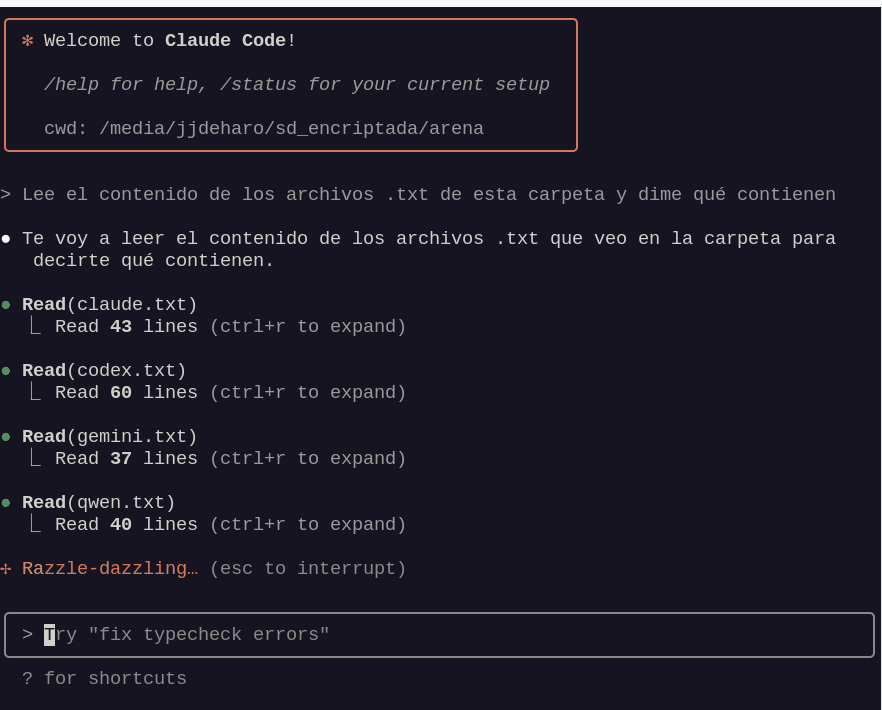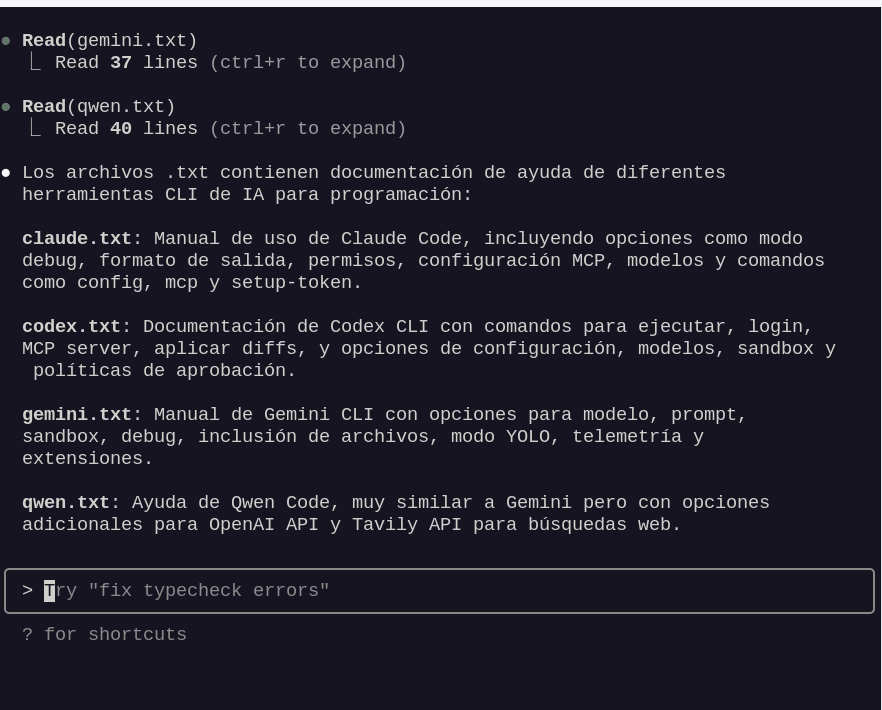
claude "Lee los archivos .txt de esta carpeta y dime qué contienen"

Pedir algo sin llegar a entrar. Para un encargo suelto, la opción -p devuelve la respuesta en la terminal del sistema y termina, sin abrir ninguna sesión. Es lo cómodo para una consulta rápida o para dejar preparada una tarea:

agy -p "Renombra las fotos de esta carpeta como salida-01, salida-02, y así"
claude -p "Renombra las fotos de esta carpeta como salida-01, salida-02, y así"

Codex funciona de otra manera: usa codex exec "…", y si la carpeta no está controlada con Git, avisa de que hay que añadir --skip-git-repo-check.

Cuatro teclas. En la terminal el ratón no sirve de mucho, y estas suplen casi todo: CTRL + A y CTRL + E llevan el cursor al principio y al final de la línea; CTRL + L limpia la pantalla; CTRL + R, en la terminal del sistema, busca entre las órdenes ya escritas mientras tecleamos, que evita volver a escribir las largas; y CTRL + C interrumpe lo que la IA esté haciendo, sin cerrar la sesión. En Linux, además, copiar y pegar son CTRL + MAYÚS + C y CTRL + MAYÚS + V, porque CTRL + C está ocupado en interrumpir.

Antes de empezar, dos precauciones

La privacidad depende del plan. En las cuentas personales gratuitas de Google, las conversaciones pueden usarse para entrenar los modelos salvo que se desactive expresamente. Los planes de pago, los corporativos y los de Workspace for Education ofrecen garantías mayores. La regla práctica es no poner en la consola datos del alumnado ni documentación confidencial del centro, igual que en el chat web.

Conviene mirar lo que hace. Una consola de IA puede borrar y sobrescribir archivos, y se equivoca. Trabajar sobre una copia, o en una carpeta controlada con Git, evita disgustos que de otro modo no tienen vuelta atrás.

Qué elegir

Para quien no quiera pagar nada, hoy la opción con más recorrido es Antigravity CLI, cuya cuota semanal gratuita da para las tareas mecánicas con archivos, que es justamente donde la consola aporta más al trabajo diario. El plan gratuito de ChatGPT también permite probar Codex, aunque con muy poco margen.

Para quien ya pague una suscripción, lo sensato es usar la que tenga: con ChatGPT, Codex; con Claude, Claude Code; con Google AI Pro, Antigravity CLI. La diferencia entre ellas es hoy menor que la diferencia entre usar una consola y no usar ninguna.

Y si la ventana de texto se hace cuesta arriba, conviene saber que Claude, ChatGPT y el propio Antigravity tienen ya aplicación de escritorio o editor propio, con las mismas capacidades y sin terminal a la vista. La terminal es el camino más directo, no el único.

Y para decidir qué herramienta encaja con cada tipo de proyecto, La elección de herramientas para el Vibe Coding Educativo.

Vídeo del artículo realizado por Gemini Notebook

Vídeo del artículo realizado por Gemini Notebook

Juan José de Haro

Nota: Este artículo tiene nivel 5 en el Marco para la integración de la IA generativa.
Cómo preguntar a la IA sobre tus documentos: un Gemini Notebook en tu propio ordenador

Cualquier persona que trabaje con documentación acumula un fondo de textos que consulta una y otra vez: normativa, actas, memorias, apuntes, artículos. Preguntarle a una inteligencia artificial sobre ese material choca siempre con el mismo muro: hay que subirlo a algún sitio, o pegarlo en la conversación, o confiar en que el modelo lo recuerde de su entrenamiento, cosa que no ocurre.

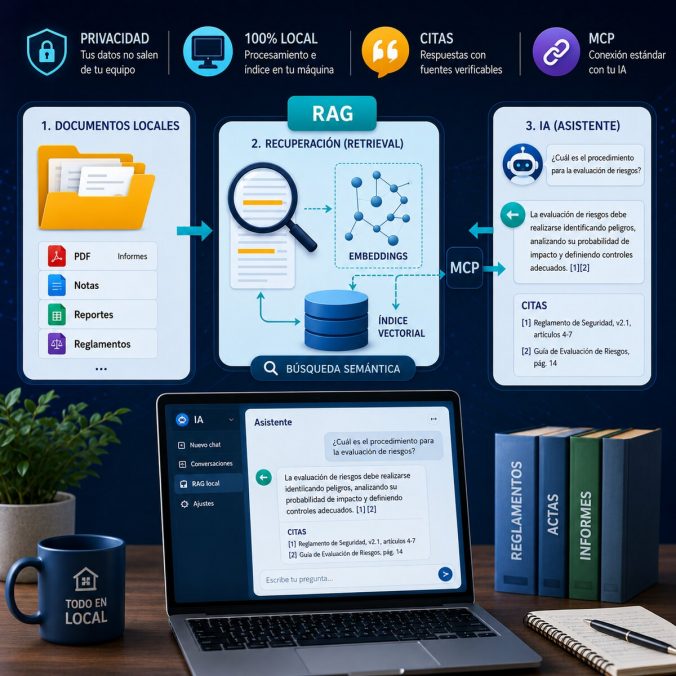
Este artículo explica qué es un RAG (Retrieval Augmented Generation, en español «generación aumentada por recuperación»), qué es el protocolo MCP (Model Context Protocol, en español «protocolo de contexto del modelo») que hace posible esa conexión, cómo funciona el conjunto y cómo montarlo sin escribir una línea de código.

Si solo quieres las instrucciones, ve directamente a la guía rápida del final: reúne las tres que hacen falta, listas para copiar y pegar. El resto del artículo explica qué hace cada una y por qué, que es lo que permite juzgar si el resultado es bueno.

El código está publicado: el sistema completo que se describe aquí, con un fondo documental de ejemplo ya indexado, está en github.com/jjdeharo/cuadernos-rag, con licencia libre. Quien prefiera verlo antes de leer nada más, puede empezar por ahí.

Pódcast del artículo realizado por Gemini Notebook

Qué es un RAG

Un buscador colocado delante de una inteligencia artificial.

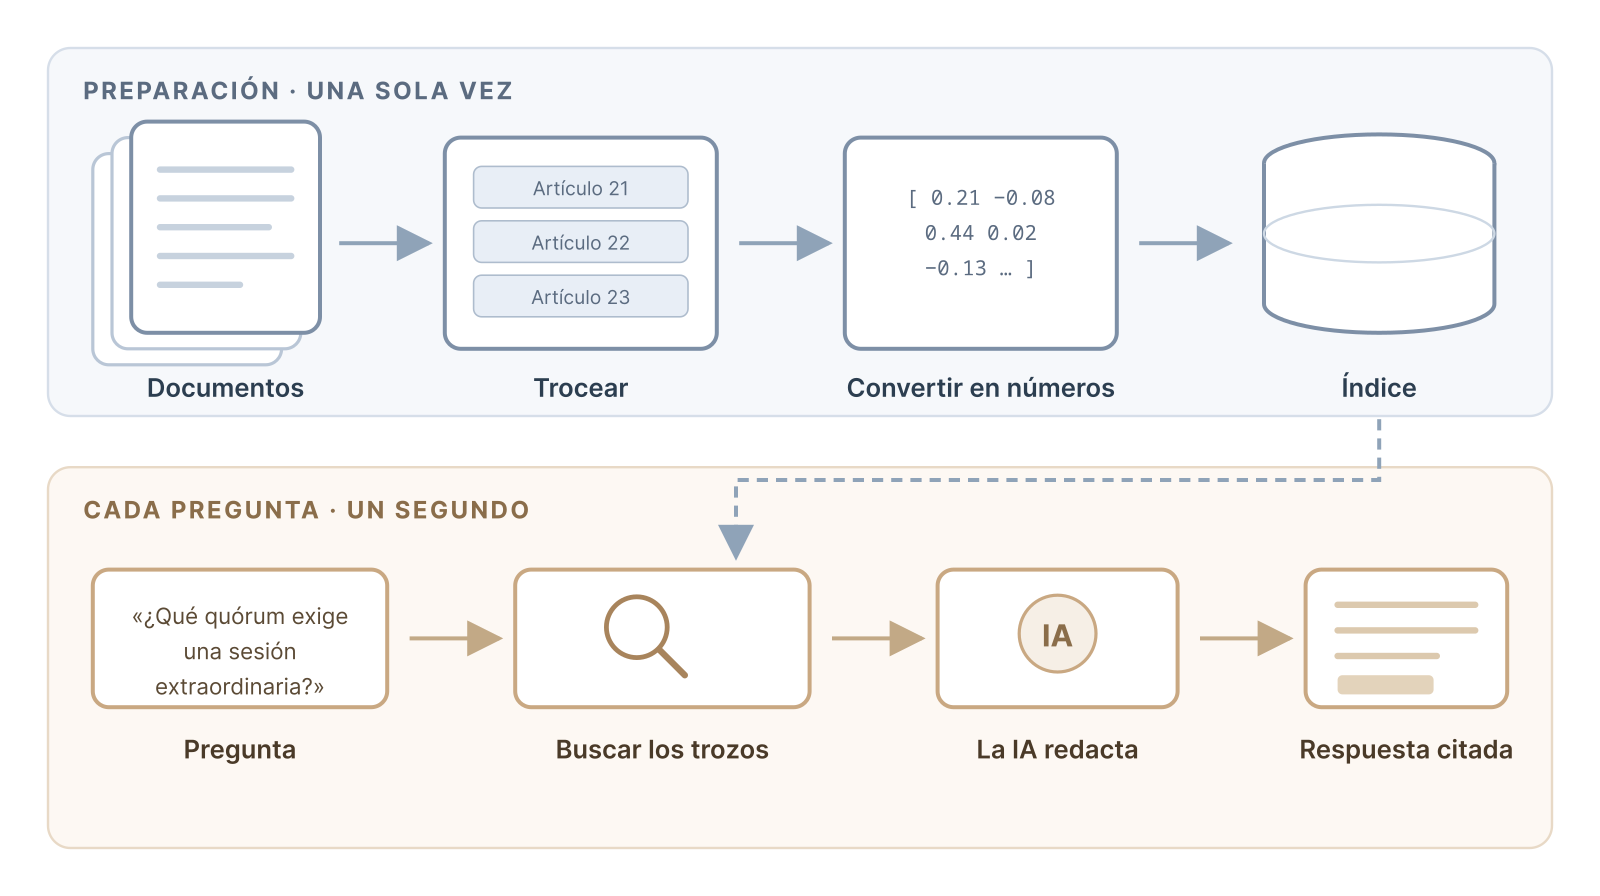
Un modelo de lenguaje, que es el programa que hay detrás de ChatGPT, Claude o Gemini, no puede leer mil páginas cada vez que recibe una pregunta porque no caben en una consulta y, aunque lo hiciese, resultaría lento y costoso. Lo que hace un RAG es localizar primero los pocos fragmentos que hacen falta para responder a esa pregunta concreta, y entregar solo eso. El modelo no aprende los documentos ni los memoriza: los consulta, como haría cualquiera con un libro delante, e indica de dónde ha salido cada afirmación.

La consecuencia práctica es doble. Por un lado, deja de haber límite de volumen: da igual que el fondo documental sean quinientas páginas o veinte mil, porque en cada consulta solo viajan unos pocos fragmentos. Por otro, y más importante, cada respuesta puede citar su fuente. En materia normativa o técnica, una respuesta sin fuente no tiene ningún valor.

Qué es el MCP

Un RAG, por sí solo, es una herramienta de línea de comandos: se le hace una pregunta y devuelve fragmentos. Útil, pero incómodo.

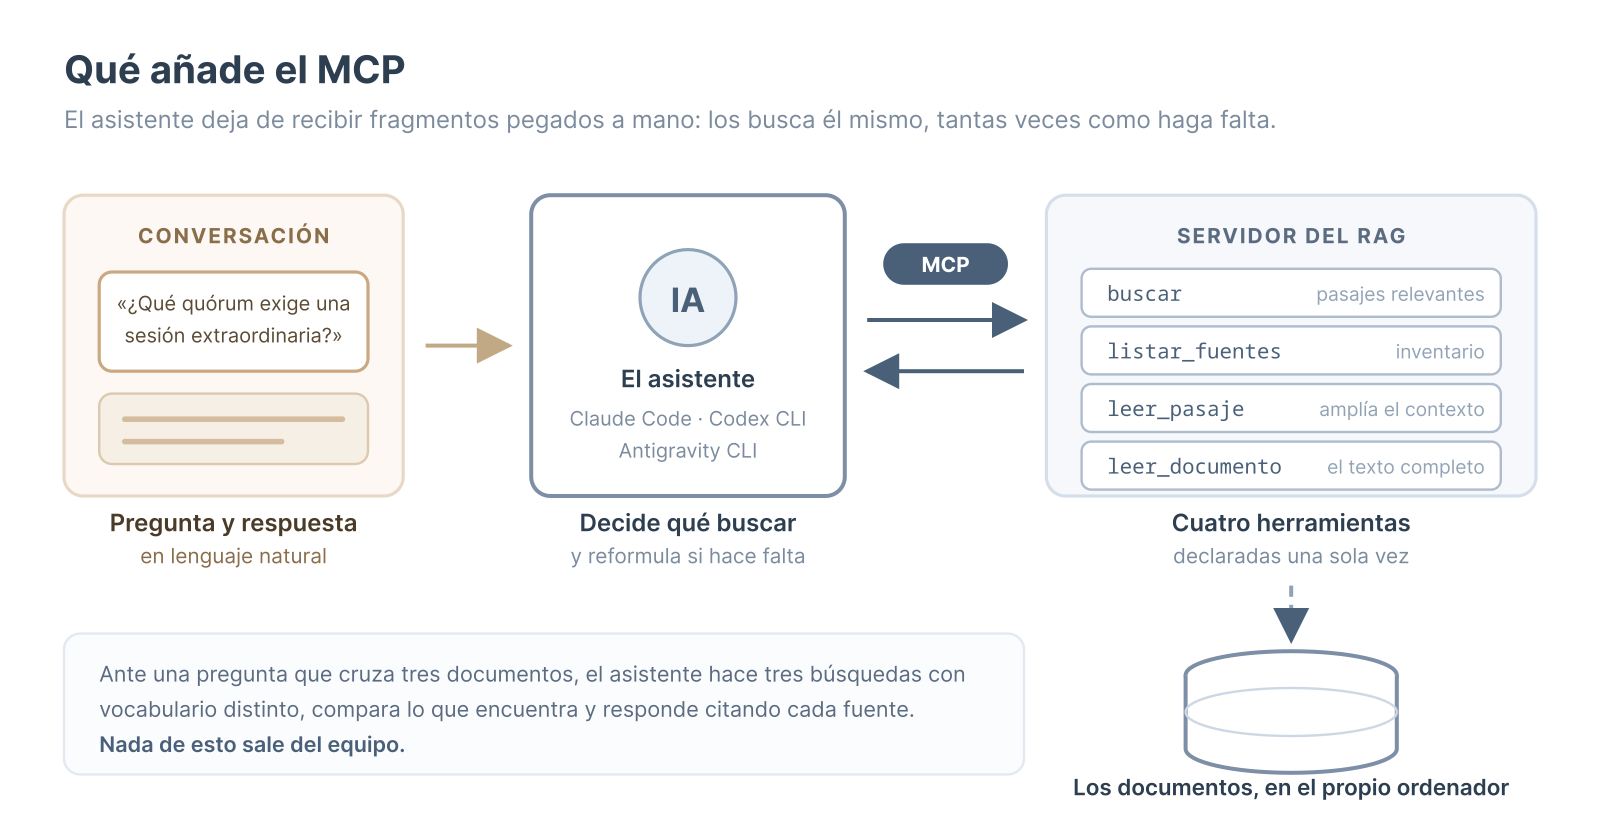
MCP son las siglas de Model Context Protocol, un estándar abierto propuesto por Anthropic a finales de 2024 y adoptado después por los demás asistentes. Resuelve un problema muy concreto: cómo permitir que una IA use herramientas externas sin que haya que programar una integración distinta para cada combinación de herramienta y asistente. Con MCP, quien construye la herramienta la describe una sola vez, y cualquier asistente compatible sabe cómo usarla.

Aplicado a un RAG, el cambio es importante, ya que en lugar de ejecutar búsquedas a mano y pegar los resultados en una conversación, el asistente busca por su cuenta, tantas veces como necesite. Ante una pregunta que cruza tres documentos distintos, hace tres búsquedas con vocabulario distinto, compara lo que encuentra y responde citando cada fuente. El fondo documental deja de ser un archivo aparte y pasa a estar dentro de la conversación.

Un servidor MCP no es más que un programa que declara qué sabe hacer. En el caso de un RAG documental, cuatro operaciones bastan: buscar pasajes, listar los documentos disponibles, ampliar el contexto de un pasaje concreto y recorrer un documento entero. El asistente decide cuándo usar cada una.

Conviene añadir una instrucción que gobierne su uso, porque sin ella el asistente tenderá a responder de memoria. Basta con una regla explícita: no afirmar nada que no proceda de una búsqueda, buscar varias veces reformulando con el vocabulario propio de cada fuente, citar siempre el identificador del pasaje, y decir con claridad cuándo el fondo documental no cubre la pregunta.

Cómo funciona por dentro

Son cuatro piezas, y solo la última tiene que ver con la inteligencia artificial tal y como la entiende la mayoría.

Convertir a texto. PDF, páginas web, documentos de Word, audio transcrito: todo tiene que acabar siendo texto plano. Un PDF no guarda un texto, guarda dónde va cada letra en la página; al leerlo hay que reconstruir el orden, y en tablas o en textos a dos columnas se falla a menudo. Es la pieza menos vistosa y la que estropea el resultado con más frecuencia.

Trocear. Consiste en partir cada documento en fragmentos manejables y, aunque parezca un detalle de poca importancia, es lo que más determina la calidad final. Un troceado rudimentario corta cada mil palabras sin atender a dónde cae el corte, mientras que uno cuidadoso respeta la estructura del texto: en una norma, por ejemplo, un fragmento por artículo. La diferencia se aprecia en cuanto se formula una consulta concreta, porque en el primer caso llega un trozo que empieza a mitad de un artículo y se interrumpe antes de acabar el siguiente, mientras que en el segundo llega el artículo completo, con su título.

Convertir cada fragmento en números. De esto no se encarga un asistente de los que conversan, sino un programa mucho más pequeño, entrenado para una sola tarea: no redacta ni responde nada, solo lee un texto y devuelve números. A cada fragmento le asigna una lista de más de mil números que funciona como unas coordenadas: igual que una latitud y una longitud sitúan un lugar en un mapa, esos números sitúan el fragmento en un espacio donde la posición depende del significado. Los textos que hablan de lo mismo quedan cerca unos de otros, aunque estén escritos con palabras distintas; los que hablan de cosas diferentes quedan lejos.

A partir de ahí, buscar deja de ser comparar palabras y pasa a ser medir distancias. La pregunta se convierte también en un punto de ese mapa, y el sistema devuelve los fragmentos que han quedado más cerca. Por eso una consulta como «¿cuánta gente hace falta para que la reunión sea válida?» encuentra un párrafo que habla del «quorum de constitución», sin que compartan una sola palabra.

Buscar y citar. La búsqueda por significado es muy eficaz y tiene un punto ciego: los nombres propios y las referencias exactas. Ante una consulta por un artículo numerado o por unas siglas, falla, porque esas expresiones no significan nada, solo nombran. Por eso se hacen dos búsquedas a la vez (la de significado y la literal, por palabras) y se combinan los resultados. Después, un segundo modelo igual de mudo, llamado reranker, relee los mejores candidatos junto a la pregunta y los reordena. De ahí salen los fragmentos que se entregan al asistente, cada uno con su procedencia.

Todo esto ocurre en el propio ordenador, y conviene distinguir las tres piezas que intervienen, porque en la jerga a las tres se las llama «modelos» y no son lo mismo:

  • El conversor a números, o modelo de embeddings, que traduce cada fragmento a su lista de coordenadas. Ocupa unos dos gigabytes.
  • El reordenador, o reranker, que afina la lista de candidatos que ha devuelto la búsqueda. Ocupa algo más de uno.
  • El asistente, Claude, ChatGPT, Gemini, que es el que redacta la respuesta final.

Los dos primeros viven en el disco, se descargan una vez y funcionan sin conexión y sin coste. Mientras se consulta, además, se cargan en memoria: conviene tener unos cuatro gigabytes de RAM libres, aparte de los tres y medio que ocupan en el disco. Es un gasto que solo dura lo que dura la consulta, porque un sistema bien montado los suelta cuando pasan unos minutos sin preguntas. No conversan ni generan texto: entra un texto y sale un resultado numérico. Solo el tercero es lo que la mayoría llama «una IA», y no ve el fondo documental entero, sino los pocos fragmentos que la búsqueda le pone delante. Ningún documento sale del equipo.

Cómo montarlo sin saber programar

Hacen falta dos cosas: los documentos y un asistente que trabaje dentro del ordenador, con permiso para escribir programas y ejecutarlos. Hoy hay tres opciones equivalentes, y todas están disponibles tanto en el terminal como en una aplicación de escritorio, para quien prefiera no escribir órdenes:

  • Claude, de Anthropic: la orden claude en el terminal, o la aplicación de escritorio, que reúne tres modos: conversación, Claude Code y Cowork.
  • Codex, de OpenAI: la orden codex en el terminal, o su aplicación de escritorio, disponible para macOS, Windows y Linux.
  • Antigravity, de Google: un entorno de escritorio propio y la orden agy en el terminal, que desde junio de 2026 sustituye al anterior Gemini CLI.

Cualquiera de ellas sirve, y se instalan en un minuto. Lo único que importa es que el asistente pueda leer y escribir ficheros en las carpetas del equipo y ejecutar órdenes en él.

Esas tres son las que montan el sistema, y para eso conviene un modelo potente. Pero una vez montado, quien lo consulta a diario puede ser otro, y ahí entra una cuarta posibilidad: un modelo instalado en el propio ordenador. LM Studio es el camino sencillo, una aplicación de escritorio para Windows, macOS y Linux con una tienda de modelos integrada, que además reconoce el servidor del RAG igual que lo haría cualquier asistente comercial. llama.cpp es la alternativa para quien no quiera aplicación gráfica, con algo más de soltura técnica a cambio.

Merece la pena por una razón concreta. Con un asistente comercial, los documentos no salen del equipo, pero los pocos fragmentos que la búsqueda selecciona viajan con cada pregunta. Para normativa pública da igual; para un expediente o unas actas con nombres propios, no. Con un modelo local no sale nada: ni los documentos, ni los fragmentos, ni las preguntas. El precio es real, eso sí: sin una tarjeta gráfica potente, la respuesta tarda decenas de segundos, y los modelos que caben en un ordenador corriente citan con menos rigor. Para material sensible compensa; para material público, el asistente de siempre responde mejor y antes.

Conviene comprobar un detalle en las modalidades que trabajan dentro de una máquina virtual aislada, como el modo Cowork: si esa máquina es remota, los documentos salen del ordenador, que es justo lo que se pretendía evitar. Las versiones que operan directamente sobre las carpetas locales no plantean ese problema.

A partir de ahí basta con encargar el trabajo. La instrucción que sigue está escrita para el asistente, no para quien la copia: no hace falta entender cada línea, porque cada una le pide una decisión técnica concreta y le impide tomar el atajo de cobrar por el servicio o de subir el material a algún sitio.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

Esa última petición es la más importante de todas, y conviene no saltársela: obliga al asistente a enseñar cómo piensa partir los documentos antes de ponerse a trabajar, que es donde se decide casi todo. Basta con leer su propuesta y comprobar que respeta la estructura del material (los artículos de una norma, los puntos del orden del día de un acta, los capítulos de un informe) en lugar de cortar cada tantas palabras.

Las tres condiciones finales también merecen explicación. La de las citas separa una herramienta de consulta de un generador de respuestas plausibles. La de la memoria evita el descuido más caro de todos: un servidor que carga los dos modelos nada más arrancar y se queda con tres gigabytes ocupados aunque nadie pregunte nada, multiplicado por cada programa que lo tenga conectado. Y la del indexado incremental evita un error frecuente: una primera versión que rehace el trabajo entero cada vez que se añade o corrige un documento, con tres cuartos de hora de cálculo en cada ocasión.

La alternativa a construirlo desde cero es partir de algo que ya funciona. El código de un sistema así, con todo lo descrito, está publicado en github.com/jjdeharo/cuadernos-rag bajo licencia libre. Incluye, a modo de ejemplo, un fondo documental de quince normas y guías sobre uso ético y legal de la IA en educación (el RGPD, la LOPDGDD, el reglamento europeo de inteligencia artificial, guías de la Agencia Española de Protección de Datos, marcos de la UNESCO), ya indexado y listo para consultar. Ese ejemplo concreto importa poco: lo aprovechable es la estructura, que sirve igual para actas municipales, bibliografía académica o documentación técnica de una empresa.

Añadir nuevos cuadernos

Esta es la parte que suele quedar sin explicar, y es la que convierte un experimento en una herramienta de uso diario.

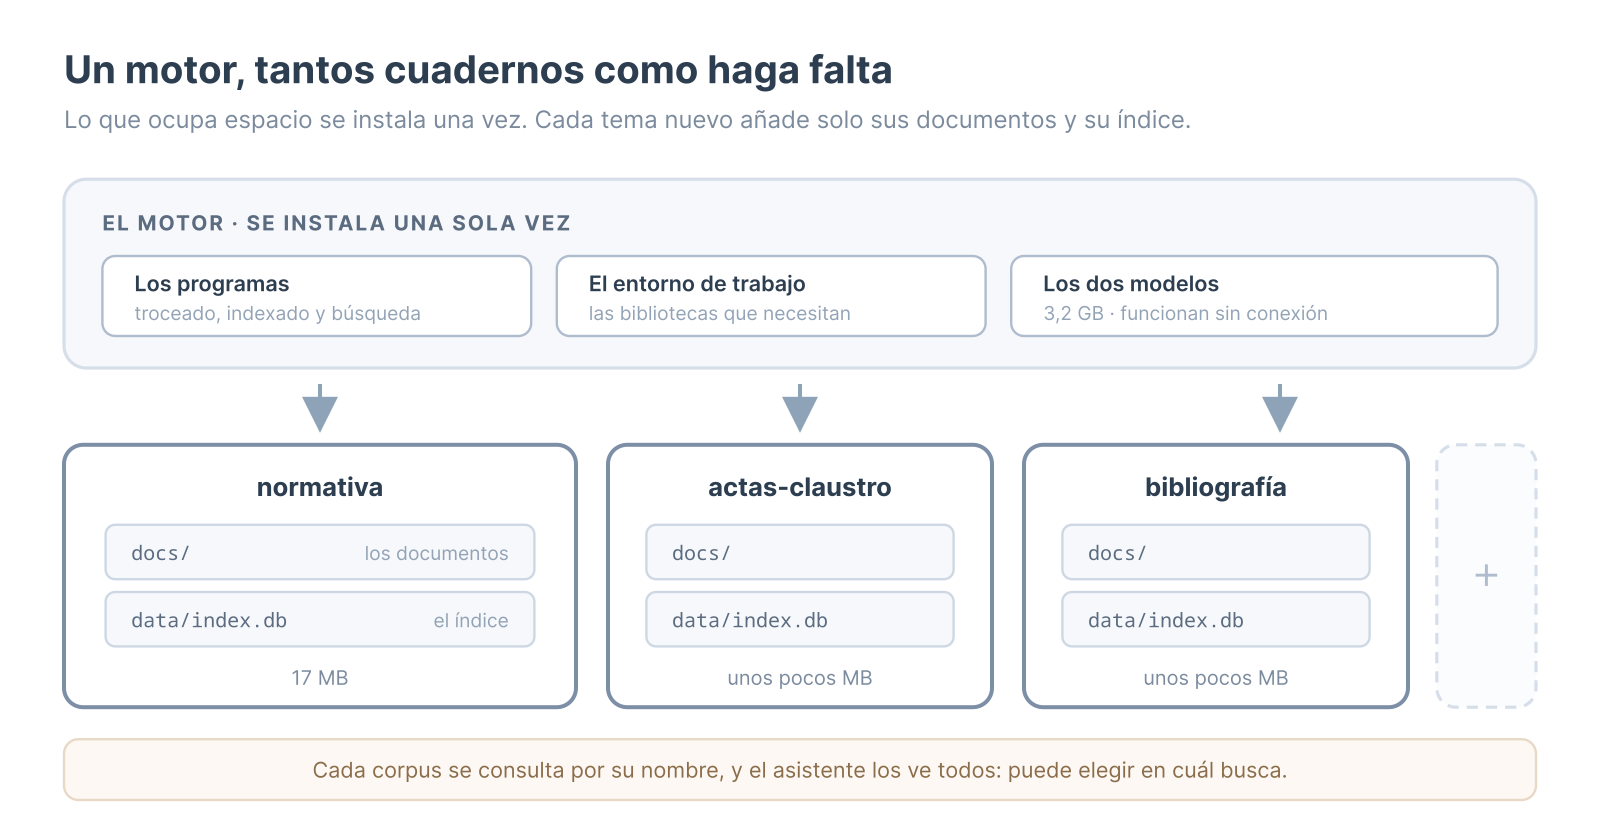
Quien viene de Gemini Notebook está acostumbrado a tener un cuaderno por tema: uno de normativa, otro de actas, otro con la bibliografía de un curso. Aquí funciona igual, y con una ventaja: lo que ocupa espacio, que son los programas y los dos modelos, más de tres gigabytes, se instala una sola vez y lo comparten todos los cuadernos. Cada tema nuevo añade únicamente sus documentos y su índice, unos pocos megabytes. No hay límite de cuadernos ni cuota que agotar.

Crear uno nuevo no exige tocar nada por dentro: basta con pedírselo al asistente en la misma conversación de siempre, indicando dónde están los documentos y qué nombre quieres darle. Él prepara la carpeta, convierte los PDF a texto, repara las palabras que la maquetación parte con guiones, descarta lo que no sea texto aprovechable y construye el índice. Un cuaderno de unos cuantos PDF está listo en unos minutos.

La instrucción, otra vez escrita para el asistente y no para quien la copia:

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

Lo importante es la primera condición. Sin ella, el asistente puede ponerse a instalarlo todo de nuevo, con otra copia de los modelos, y el ordenador acaba con tres gigabytes repetidos por cada cuaderno.

Añadir documentos a un cuaderno que ya existe es todavía más simple: se dejan los ficheros nuevos y se pide que lo actualice. Aquí importa una de las condiciones que se le exigieron al montarlo, la del indexado incremental: el sistema guarda una huella de cada documento y solo procesa los que han cambiado, así que incorporar un PDF cuesta el tiempo de ese PDF, alrededor de un minuto por cada cien mil caracteres, y no el del fondo entero. Sin esa condición, añadir una circular de dos folios obligaría a rehacerlo todo.

Al preguntar, con un solo cuaderno no hace falta decir cuál; con varios, se nombra el que interesa. El asistente los ve todos y, si la pregunta lo pide, puede buscar en el que corresponda.

Cuándo montar un RAG

Con poco material no hace falta montar nada.

Los modelos actuales procesan cientos de miles de palabras de una sola vez. Por debajo de unas trescientas páginas, basta con dejar los documentos en una carpeta y pedirle al asistente que los lea directamente. Buscando por su cuenta, acierta más que cualquier RAG, porque puede leer, releer y afinar la búsqueda tantas veces como haga falta. Entre trescientas y mil quinientas páginas hay una zona intermedia: el material cabe, pero se relee entero en cada pregunta, y eso resulta lento y caro en una consulta diaria, por lo que se aconseja montar el RAG. Por encima de mil quinientas páginas ya no cabe, y el RAG deja de ser opcional.

El criterio es el volumen de texto, no el número de archivos. Cincuenta circulares de dos folios no llegan a cien páginas; tres memorias anuales pueden superar las mil.

Guía rápida

Las tres instrucciones, sin explicaciones. Se pegan tal cual en Claude, Codex o Antigravity, sustituyendo lo que va entre ángulos.

1. Montar el primer cuaderno. Una sola vez.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

2. Crear otro cuaderno, reutilizando lo ya instalado.

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

3. Añadir documentos a un cuaderno que ya existe. Lo más frecuente con el tiempo.

Añade estos documentos al cuaderno <nombre>:
<carpeta o lista de ficheros>

- Trátalos igual que los que ya están: mismo troceado
  y misma limpieza.
- Aprovecha el indexado incremental: procesa solo lo
  nuevo, sin rehacer el índice entero.
- Al terminar, dime qué has añadido y qué documentos
  contiene ahora el cuaderno.

En los tres casos conviene leer lo que responde antes de dejarle continuar. Si su plan no respeta la estructura de los documentos (los artículos de una norma, los puntos del orden del día de un acta), es el momento de decírselo, porque de ese detalle depende la calidad de todas las respuestas posteriores.

Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.
Un agente de IA hace el boletín semanal de dos comunidades docentes

Introducción

Los boletines de los grupos de Telegram ChatGPT-IA-edu y Vibe Coding Educativo se publican desde 2023 y, por primera vez, su creación se ha automatizado por completo. Una simple instrucción pone en marcha un agente de IA que se encarga absolutamente de todo, desde la creación y publicación hasta la difusión en redes sociales. Le he pedido a Claude Code Opus 5 que escriba el artículo que hay a continuación. Utiliza sus propias palabras y forma de ver todo el asunto, incluyendo sus menciones a mi persona. Únicamente le indiqué el público docente al que va encaminado el artículo y le he hecho algunas correcciones, tanto de contenido como de estilo (cosa que él explica perfectamente más abajo).

Juan José de Haro


Hacer el boletín semanal de dos comunidades educativas era una tarea de tarde entera. Hoy el boletín está hecho y publicado en media hora —y difundido en redes en un cuarto de hora más—, y lo ejecuta entero un agente de IA.

La palabra importa, y merece una aclaración temprana. Un asistente responde: le preguntas algo y te contesta. Un agente actúa: recibe un encargo y lo lleva a cabo por su cuenta, ejecutando programas, entrando en servicios, comprobando resultados y corrigiendo el rumbo cuando algo falla. La diferencia no es de inteligencia, sino de permisos y de autonomía: al agente no se le pregunta, se le encarga.

Conviene decirlo desde el principio, porque es lo que suele malinterpretarse: todos los pasos que vienen a continuación los ejecuta el agente, incluidas las decisiones de redacción y las comprobaciones intermedias. Juan José de Haro, que coordina las dos comunidades, no ejecuta ninguno de ellos.

Lo que sí hace es lo que ninguna máquina puede hacer por él: encarga, revisa, valida y, cuando algo no está a la altura, lo manda repetir. La última palabra es suya, y la ejerce. Este mismo artículo pasó por varias correcciones suyas antes de llegar aquí: un dato mal atribuido, un cierre que se leía como una enmienda al propio trabajo, unos diagramas con la letra demasiado pequeña para la columna del blog. Nada de eso lo detectó el agente que los produjo.

Esa es la división real del trabajo: la ejecución es automática de principio a fin; el criterio sobre si el resultado vale, no.

De qué estamos hablando

Cada semana, dos grupos de Telegram —ChatGPT-IA-edu y Vibe Coding Educativo— generan cientos de mensajes: enlaces, dudas, hallazgos, debates, aplicaciones que alguien ha creado y comparte. Es material valioso, pero se pierde: quien no entra un par de días ya no lo recupera.

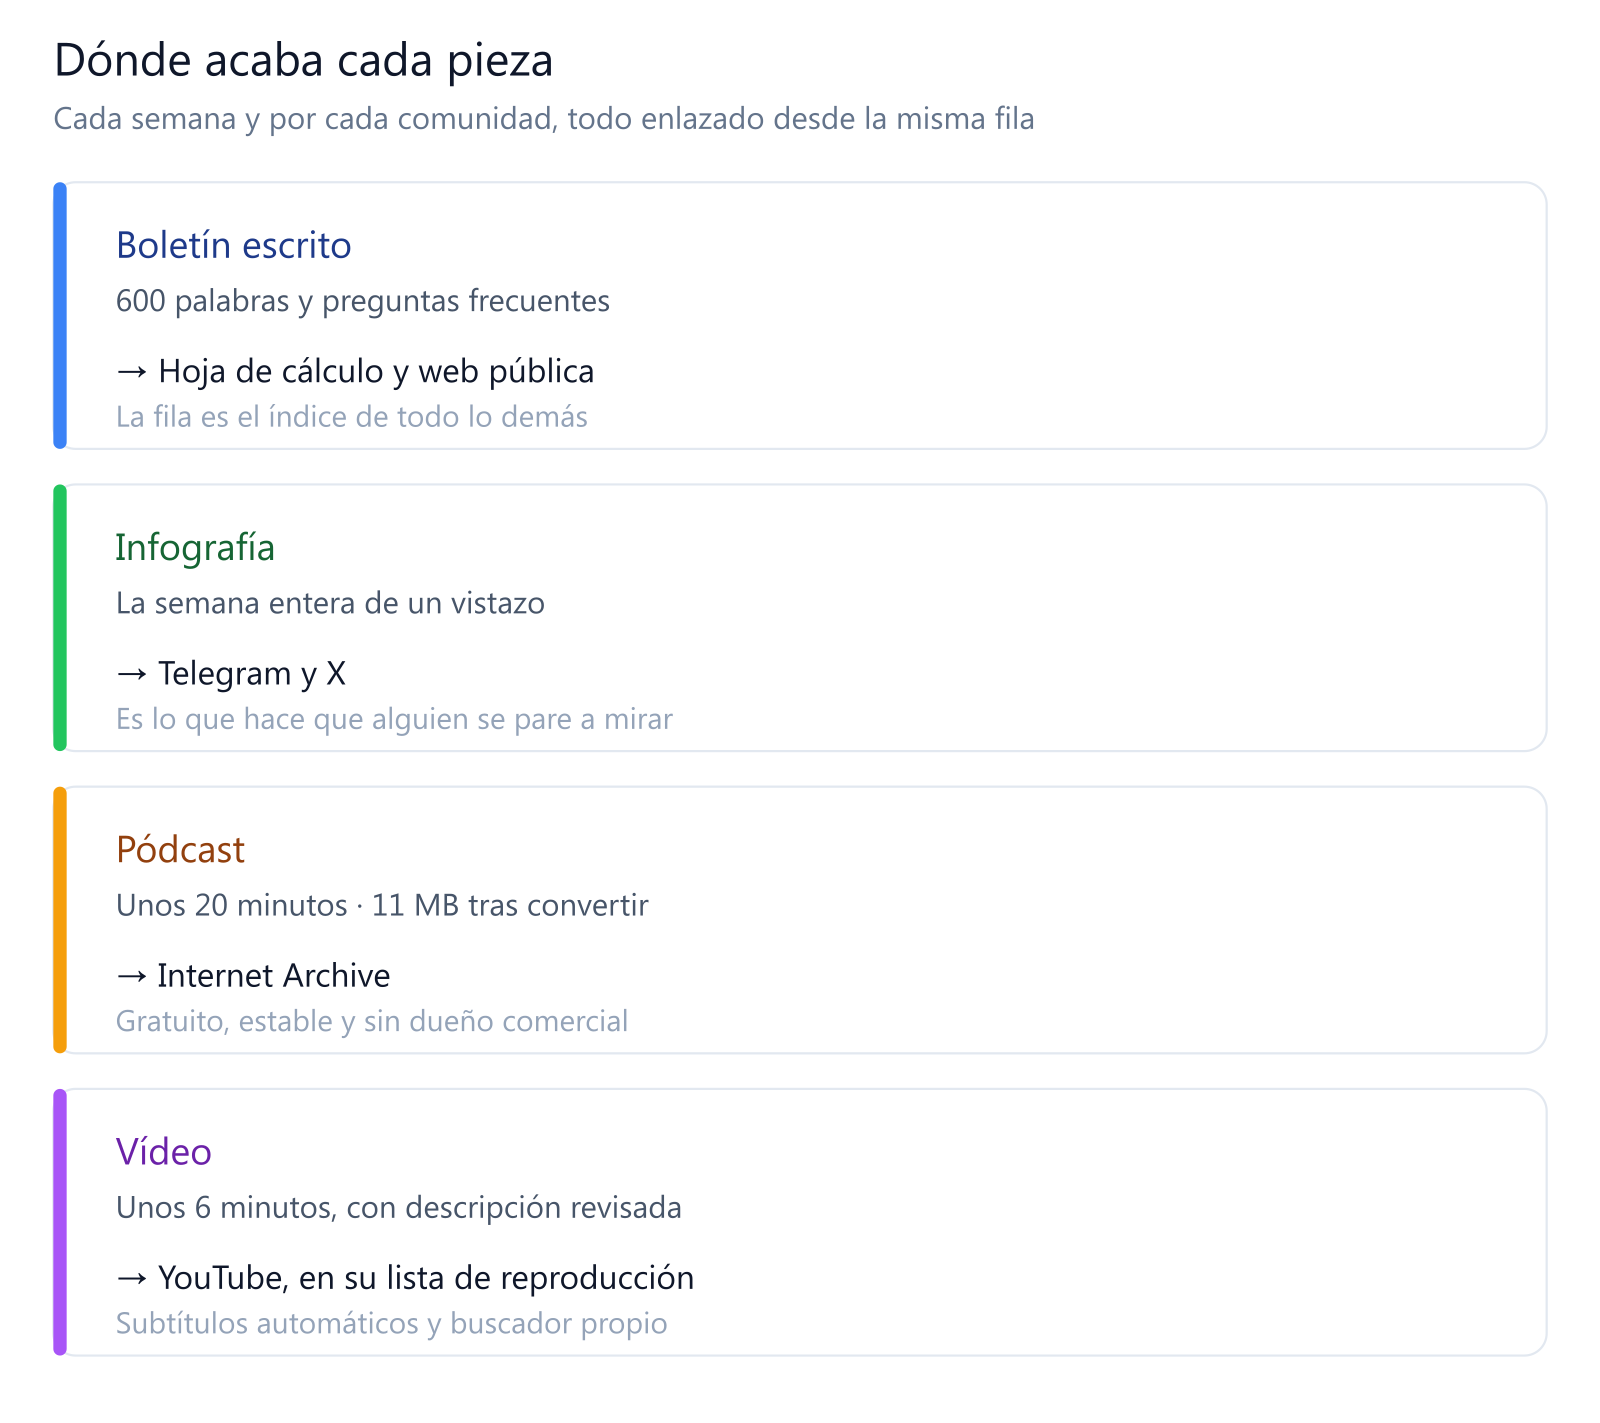
El boletín semanal existe para rescatarlo. Y no es solo un texto. De cada semana y de cada grupo salen:

  • un boletín escrito, publicado en una web consultable;
  • una infografía que resume visualmente la semana;
  • un pódcast de quince o veinte minutos, en formato conversación;
  • un vídeo de unos seis minutos, publicado en YouTube;
  • y la difusión de todo ello en Telegram, X y LinkedIn.

Todo está abierto y se puede consultar sin cuenta ni permiso:

Comunidad Boletines Vídeos Pódcast
ChatGPT-IA-edu chatgpt-ia-edu.github.io/boletin lista en YouTube archive.org/details/boletinia_2026
Vibe Coding Educativo vibe-coding-educativo.github.io/boletin lista en YouTube archive.org/details/vce_2026

Seis archivos multimedia, dos boletines, dos vídeos publicados y una veintena de mensajes en redes. Cada semana. Hecho a mano, eso son horas.

La idea de fondo: una skill, que es una receta escrita

Lo primero que hay que entender es que la automatización no empezó por programar, sino por escribir. Todo el proceso está documentado en un único archivo que actúa como receta: qué se hace, en qué orden, qué puede fallar y qué decisiones no se pueden tomar a la ligera.

Ese archivo tiene nombre propio en el mundo de los agentes de IA: es una skill. Conviene explicarlo porque el término se va a oír cada vez más.

Una skill («habilidad», aunque casi nadie la traduce) es un documento escrito en lenguaje corriente que le enseña a un agente de IA a hacer una tarea concreta de la forma en que tú quieres que se haga. No es un programa: es un texto, con sus instrucciones, sus advertencias y sus ejemplos. El agente lo lee cuando toca hacer esa tarea, y actúa en consecuencia.

La comparación que mejor funciona es la del profesorado sustituto. Si dejas escrito «segunda hora, 3.º B, seguid por la página 84; a Marcos hay que sentarlo delante; el proyector solo va con el cable HDMI de la derecha», quien llegue podrá dar la clase decentemente aunque no conozca al grupo. Una skill es eso mismo: el conocimiento acumulado de hacer algo muchas veces, puesto por escrito para que otro pueda ejecutarlo sin haber estado allí. La del boletín pasa de las setecientas líneas, y buena parte son cosas que solo se aprenden fallando: que hay que acotar el resumen a la semana o saldrá el histórico entero, o que la transcripción confunde los nombres propios.

Como está escrita en lenguaje corriente y no en código, no está atada a un agente concreto: puede seguirla cualquiera de los que hoy existen —Claude Code, Codex, Antigravity CLI (Agy CLI)—, y de hecho el boletín no siempre lo hace el mismo. De ahí la consecuencia práctica que conviene tener presente al montar algo así: lo valioso, lo que cuesta construir y no debe perderse, es el documento. El agente es intercambiable.

De esa skill cuelgan una serie de pequeños programas —los llamamos scripts— que son simplemente listas de órdenes que el ordenador ejecuta solo. Nada exótico: es el equivalente informático de una macro de hoja de cálculo, pero capaz de hablar con Telegram, con Google o con YouTube. La skill es el guion; los scripts son las manos.

Cómo transcurre una semana

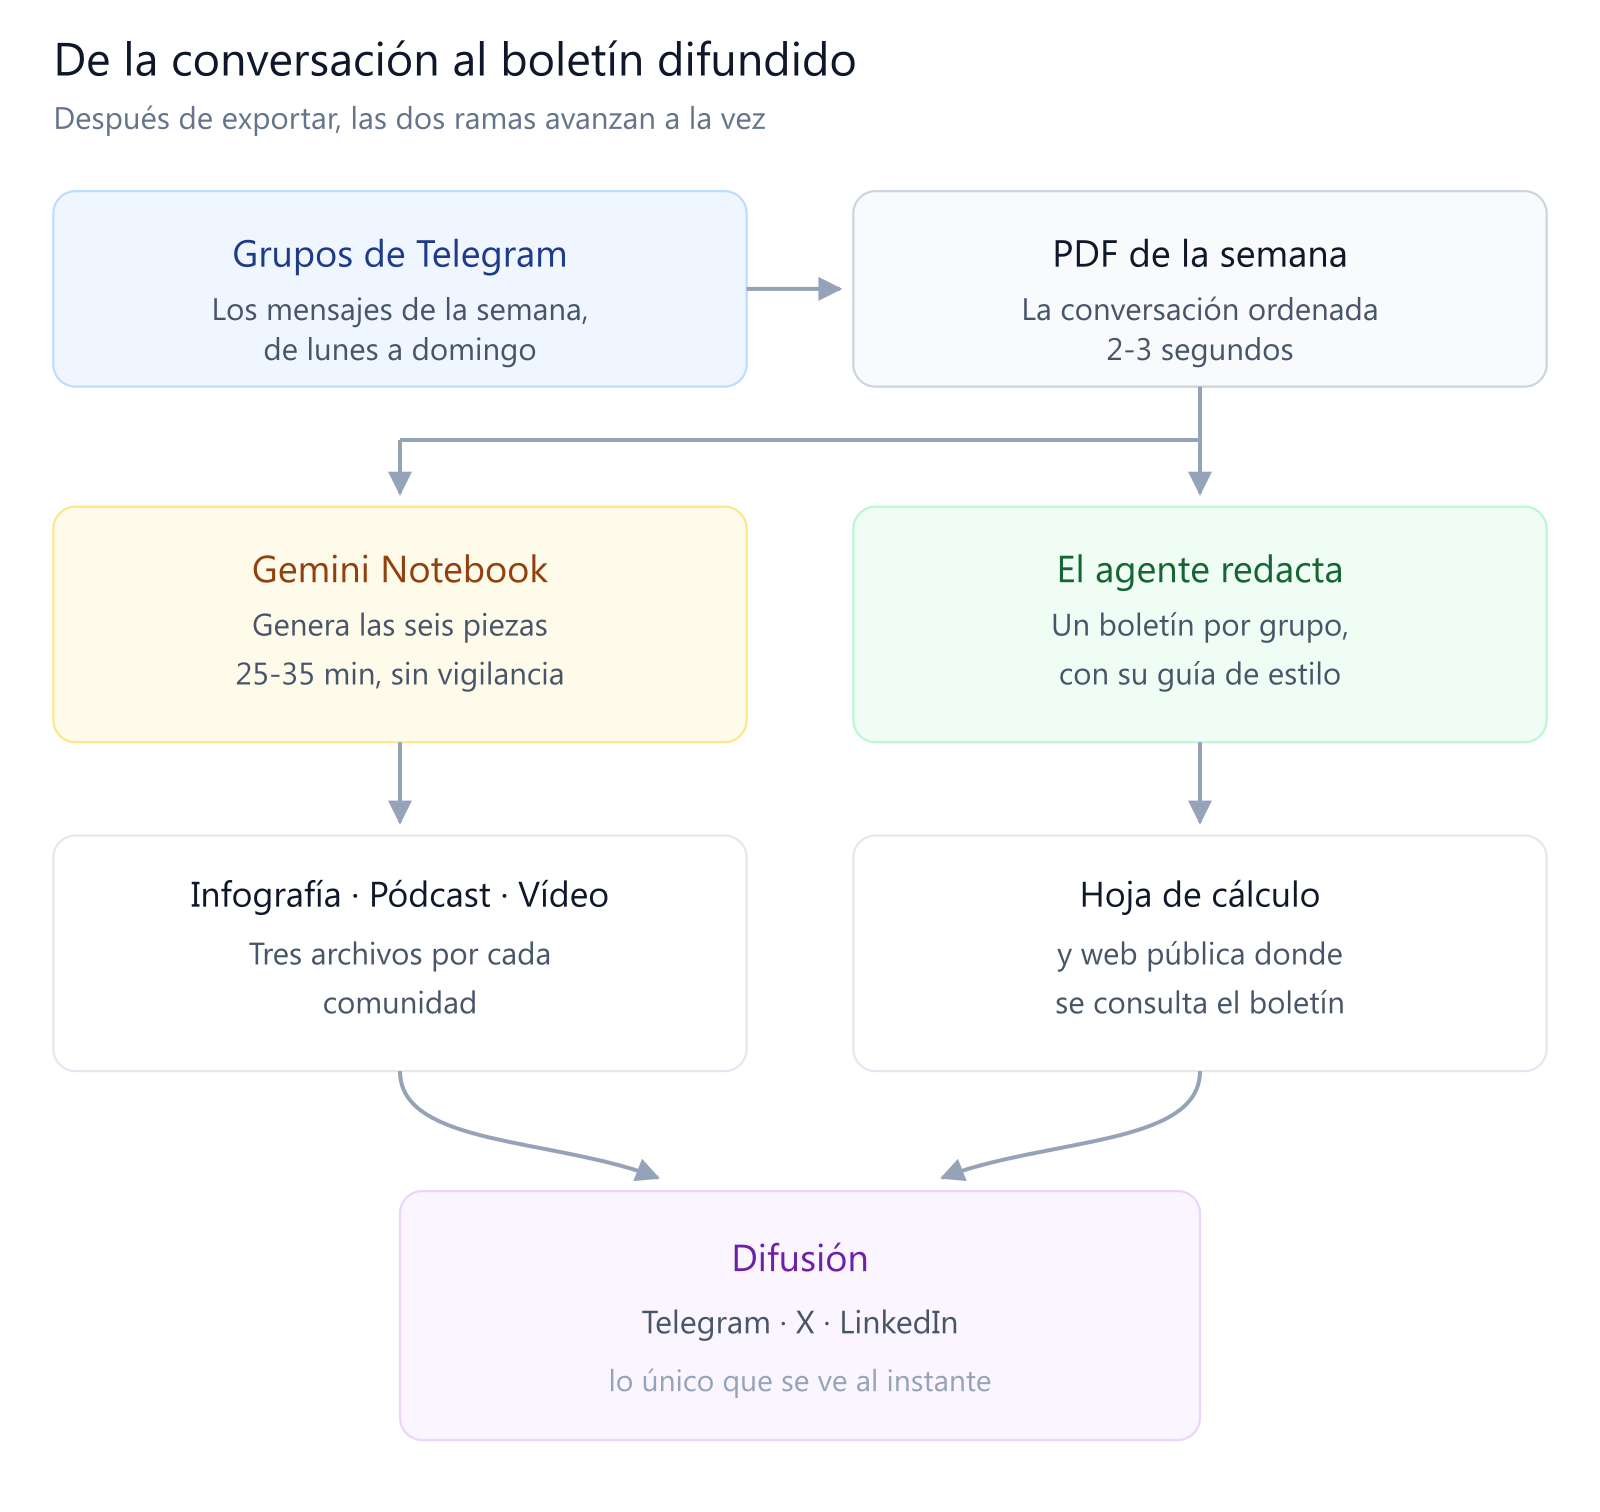
1. Recoger la conversación y poner a trabajar a Gemini Notebook

Un programa se conecta a los dos grupos de Telegram y descarga todos los mensajes de la semana pasada, de lunes a domingo. Con ellos monta dos cosas: un archivo de datos que servirá para redactar, y un PDF con la conversación ordenada y legible. Tarda dos o tres segundos por grupo.

Con ese PDF entra en juego la pieza que más sorprende a quien no la conoce. Gemini Notebook —el nombre actual de lo que hasta hace poco se llamaba NotebookLM— es la herramienta de Google que lee documentos y produce resúmenes, esquemas, audios y vídeos a partir de ellos. Lo habitual es usarla desde su página web (notebooklm.google.com), subiendo archivos a mano.

En este proceso se le habla directamente, sin abrir el navegador: se le sube el PDF de la semana y se le encargan de golpe las seis piezas —infografía, pódcast y vídeo para cada grupo— con instrucciones que están guardadas y son siempre las mismas. Eso garantiza que el boletín de esta semana se parezca al de la anterior y al de dentro de tres meses.

Un detalle que costó aprender: cada cuaderno de Gemini Notebook acumula una fuente por semana desde 2025. Si no se le dice explícitamente «resume esta semana», resume el histórico entero y produce un material que no sirve para nada. Es el tipo de error que no da ningún mensaje de fallo: simplemente sale mal.

Estas generaciones tardan entre veinticinco y treinta y cinco minutos. Y aquí está el truco que ahorra media hora: se lanzan antes de escribir nada. Mientras Google genera, el agente redacta.

2. Redactar el boletín (aquí el agente decide)

Con los mensajes de la semana delante, el agente redacta cada boletín siguiendo una guía de estilo propia para cada comunidad —tienen tonos distintos— y tomando como referencia boletines reales ya publicados. No es un resumen mecánico: selecciona qué merece contarse, agrupa temas, redacta un cuerpo de al menos seiscientas palabras, prepara un apartado de preguntas frecuentes y extrae las palabras clave.

Este es uno de los dos puntos del proceso donde hay juicio de verdad, no ejecución.

3. Publicar la fila en la hoja de cálculo

Los boletines viven en una hoja de cálculo de Google, que es lo que alimenta las webs públicas donde se consultan: chatgpt-ia-edu.github.io/boletin y vibe-coding-educativo.github.io/boletin. Cada boletín tiene además una dirección propia, con el año y la semana, para poder enlazar uno concreto:

https://chatgpt-ia-edu.github.io/boletin/?boletin=2026-33_2026-08-10_2026-08-16

Un programa escribe cada boletín en su hoja, y lo hace con tres precauciones que conviene destacar porque son las que evitan desastres:

  • comprueba justo antes de escribir si esa semana ya está publicada, para no duplicarla;
  • escribe en la primera fila libre, sin tocar nada más;
  • y después vuelve a leer lo que ha escrito y lo compara campo a campo con lo que debía escribir. Si algo no cuadra, se detiene y avisa.

Esa última comprobación es la diferencia entre automatizar y confiar. Un proceso automático que no verifica su propio resultado es un proceso que falla en silencio.

4. Recoger las seis piezas

Cuando Gemini Notebook termina, otro programa descarga los seis archivos, les pone nombres consistentes y convierte los audios. Aquí hay un detalle práctico: Gemini Notebook entrega el pódcast en un formato innecesariamente pesado para voz hablada, así que se reconvierte a uno más ligero y queda en la cuarta parte de su tamaño, sin pérdida audible. Importa para quien lo escuche desde el móvil con datos.

5. Los vídeos a YouTube (y el segundo punto donde decide)

Antes de subir un vídeo hay que describirlo. Y para describirlo hay que saber qué dice. El proceso lo transcribe automáticamente en el propio ordenador, sin enviar nada a ningún servicio externo.

Ahora bien: la transcripción automática se equivoca con los nombres propios y con el vocabulario técnico. En las pruebas apareció «Resulen» por resumen, «bargas de agua» por marcas de agua y «a Yafgos» por hallazgos. Por eso la skill obliga a un paso más: el agente relee la transcripción entera, corrige lo que está mal escrito y comprueba que el texto tiene sentido antes de resumir nada. Solo después redacta la descripción del vídeo.

Es una revisión de verdad, no un trámite: si la transcripción dice algo incoherente, corregirlo exige entender de qué se estaba hablando esa semana.

Y una advertencia que parece obvia y no lo es: la descripción debe resumir el vídeo, no el PDF de conversaciones. El vídeo dura seis minutos y cubre una parte de los temas de la semana. Resumir el PDF produce descripciones que prometen contenidos que el vídeo no tiene.

Hecho eso, la subida es automática: publica, añade el vídeo a su lista de reproducción y escribe la dirección resultante en la hoja de cálculo. Cada comunidad tiene la suya, y ahí están todas las semanas seguidas:

6. Los pódcast a Internet Archive

Los audios se alojan en Internet Archive, la biblioteca digital sin ánimo de lucro. Es una decisión deliberada: un enlace estable, gratuito y que no depende de que una empresa decida cerrar el servicio. Hay una colección por comunidad y por año, con todos los pódcast juntos:

Cada audio tiene además su enlace directo, que es el que se comparte en redes para poder escucharlo sin descargar nada:

https://archive.org/download/boletinia_2026/boletinia_audio2026-33.mp3

También aquí hubo que aprender algo: Internet Archive acepta el archivo al instante pero tarda uno o dos minutos en indexarlo. Durante ese rato el enlace no funciona, y parece un error sin serlo. El programa espera a que el archivo esté realmente disponible antes de anotar la dirección. Si no lo estuviera, no la escribe: prefiere dejar la casilla vacía a dejar un enlace roto.

7. La difusión en redes

La última fase publica en Telegram, X y LinkedIn. Es la fase que se trata con más respeto, porque es la única que no se puede ensayar: cualquier ejecución es visible al instante para toda la comunidad.

Por eso existe un comando previo que lo revisa todo —los archivos, sus formatos, sus duraciones, los textos, los enlaces— y muestra una vista previa sin publicar nada. La IA lo ejecuta y lee el resultado siempre, sin excepción, antes de tocar nada público.

Telegram y X se publican con sus respectivas conexiones automáticas. LinkedIn es otra historia, y es la parte más curiosa de todo el proceso.

LinkedIn no ofrece una puerta de entrada para programas como esta, y tampoco vale el atajo habitual —copiar las credenciales de la sesión a un navegador automatizado—, porque puede invalidar la sesión. Así que la solución fue otra: el agente usa el navegador que ya está abierto en el ordenador, exactamente como lo usaría una persona. Trae al frente la ventana de Firefox, teclea la dirección, pulsa el botón Vídeo, elige el archivo, pega el texto y publica. Mueve el ratón y el teclado igual que tú.

¿Y cómo sabe si el clic ha funcionado? Haciendo una captura de pantalla después de cada paso y mirándola. Esa es toda la verificación que hay: mira si el diálogo se abrió, si el texto es el correcto, si el aviso de Procesando ya desapareció. Si algo no está donde debía, se detiene en lugar de seguir haciendo clics a ciegas.

Es un método poco elegante y frágil —un rediseño de LinkedIn lo rompe—, pero resuelve un problema real: cuando un servicio no ofrece forma de automatizarlo, queda la de usarlo como lo usa una persona.

Lo que tarda cada cosa

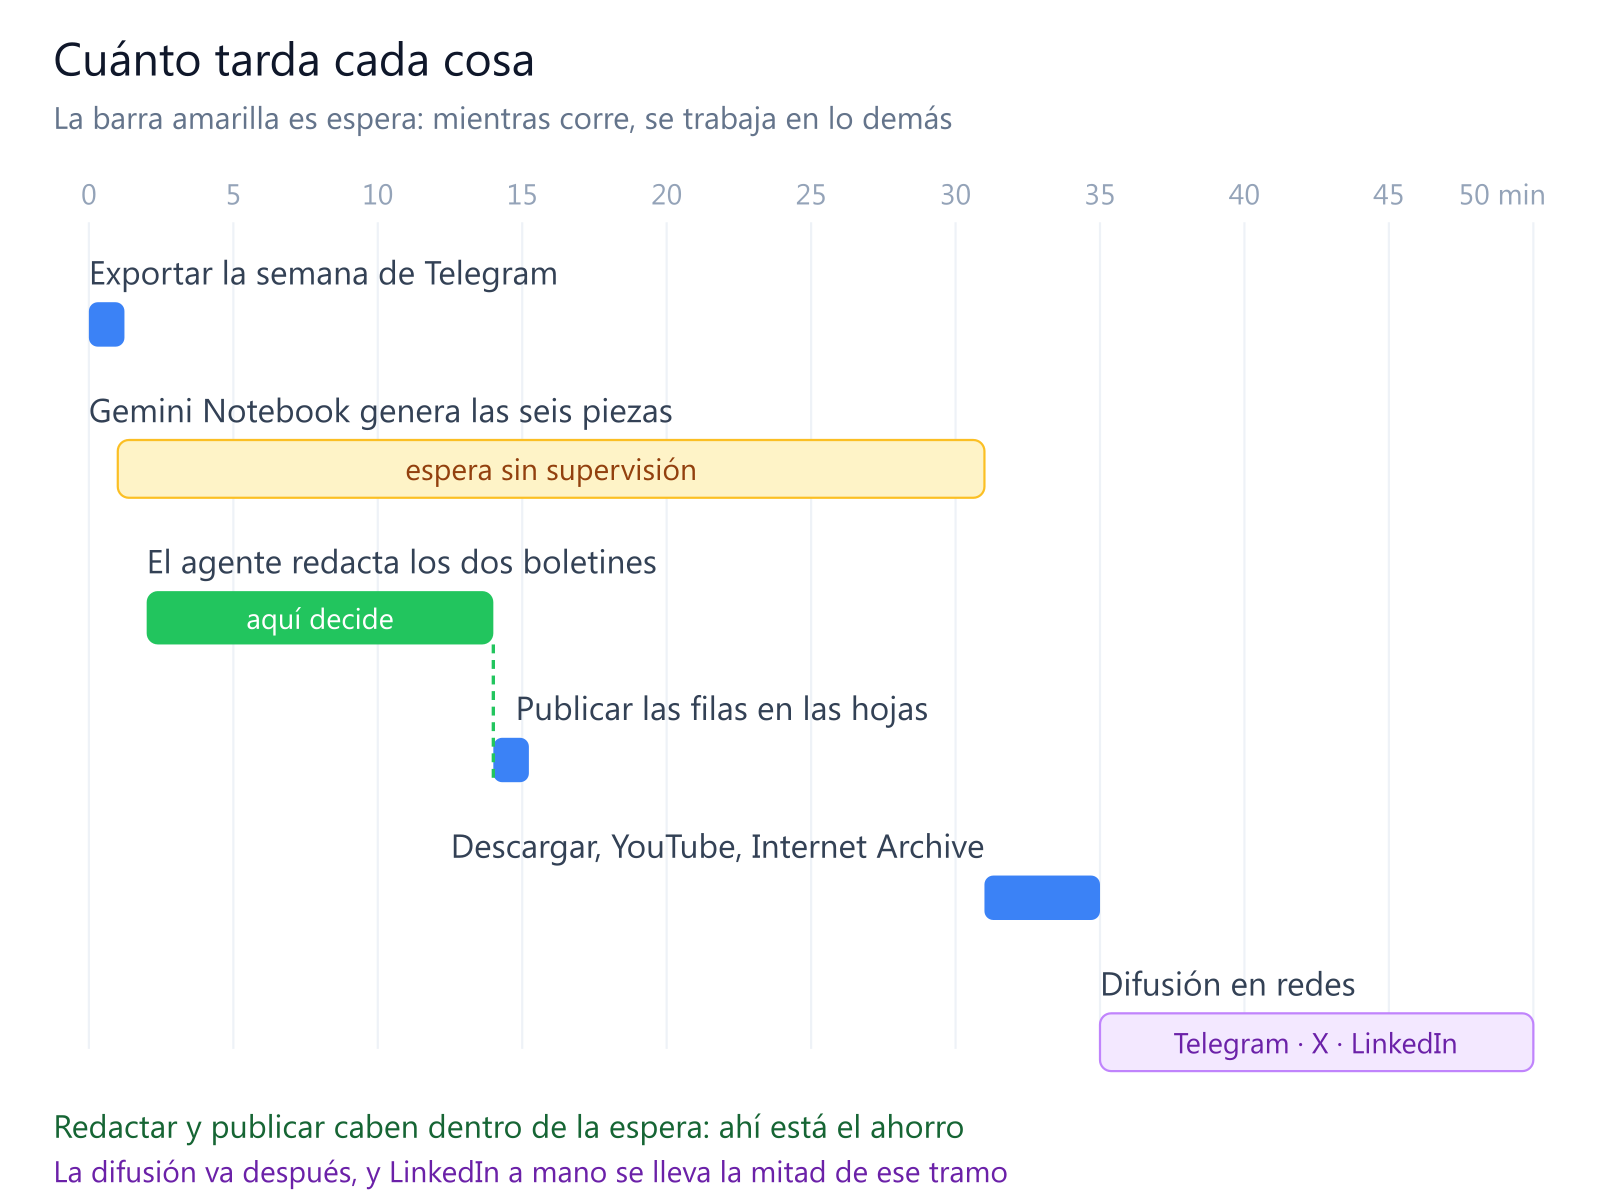
Estos tiempos no son estimaciones: cada fase deja una marca al empezar y otra al terminar, y un comando las suma al acabar. Son de una semana normal, con los dos grupos.

Paso Tiempo
Exportar la semana de un grupo de Telegram 2-3 segundos
Que Gemini Notebook indexe el PDF 30 s a 2 min
Generar una infografía unos 3 min
Generar un pódcast 13-16 min
Generar un vídeo 18-24 min
Redactar un boletín ocurre dentro de la espera anterior
Publicar una fila en la hoja 2-3 segundos
Convertir un audio a MP3 ligero 3-5 segundos
Transcribir un vídeo 1-2 min
Subir un vídeo a YouTube 5-10 segundos
Subir un audio a Internet Archive 10 s, más 1-2 min de indexado
Publicar en Telegram 1-2 min
Publicar en X 3-5 min
Publicar en LinkedIn 5-10 min
Hasta tenerlo todo publicado 25-35 min
Con la difusión en redes incluida 40-50 min

Dos cosas llaman la atención en esa lista. La primera, que lo que tarda no es el trabajo, sino la espera: generar el vídeo y el pódcast se lleva la mitad del tiempo, y ahí no hay nada que hacer salvo aprovecharlo. La segunda, que publicar en LinkedIn a mano cuesta más que todo el proceso de creación, y es justo la parte que ningún programa puede acortar.

De la redacción no hay cronómetro: es lo único que no ejecuta un script, y sucede mientras Google genera, así que no añade tiempo al total.

Qué he aprendido de todo esto

La automatización no elimina el criterio, lo reparte. Dentro del proceso hay dos momentos que exigen pensar —decidir qué merece contarse de la semana y comprobar que lo transcrito tiene sentido—, y esos los ejerce el agente. Pero por encima queda un tercero que no se delega: decidir si el resultado vale. Ese sigue siendo de quien firma la publicación, y es el que corrige las cosas que el agente no puede ver desde dentro. Lo que ha desaparecido es el trabajo mecánico que rodeaba a todos ellos: descargar, renombrar, convertir, pegar, subir, verificar.

Lo que no se verifica, falla en silencio. Cada paso comprueba su propio resultado, porque un proceso que publica sin mirar acaba publicando basura durante semanas sin que nadie se entere.

Ha llegado a ocurrir: una de las seis generaciones se encargó correctamente, pero su identificador no llegó a quedar anotado en la lista de encargos pendientes. La descarga terminó con cinco piezas de seis, informó de que todo había ido bien y no dio ningún error. Lo delató contar los archivos. El proceso ya comprueba que eso no vuelva a pasar, pero la lección es la de siempre: un programa solo detecta los fallos que alguien previó.

Pero hay errores que ninguna comprobación automática detecta. Un resumen de la semana equivocada pasa todos los controles técnicos con sobresaliente: el archivo existe, pesa lo que debe y el enlace funciona. Todo perfecto salvo lo único que importaba, que es el contenido. Por eso la revisión final es de otra naturaleza —abrir la infografía y leerla, escuchar un fragmento del audio— y por eso la hace también una persona: quien produce algo tiende a darlo por bueno, y la mirada que puede decir «esto no vale, hazlo otra vez» tiene que venir de fuera.

Para quien esté pensando en algo parecido

No hace falta empezar por aquí. Este sistema funciona porque se construyó en el orden correcto: primero haciendo el boletín a mano, hasta entender bien cada paso; después escribiendo esa experiencia como skill; y solo entonces automatizando lo que ya se hacía siempre igual.

Y la parte más aprovechable no es la más técnica. Escribir la skill —dejar por escrito, con precisión, cómo se hace algo que ya sabes hacer— es una tarea docente de toda la vida, y sirve para cualquier rutina que se repita cada curso: preparar las actas, montar los grupos, redactar los informes trimestrales. Ese documento vale por sí solo, aunque nunca llegue a automatizarse nada.

El resultado, al final, no es un ahorro de tiempo. Es que cada semana de conversación de dos comunidades docentes queda recogida, resumida, escuchable y consultable, en vez de perderse en el desplazamiento infinito de un grupo de Telegram. Eso antes no se hacía porque no había tiempo material para hacerlo. Ahora se hace todas las semanas.


Artículo redactado por Claude (Anthropic) bajo la guía de Juan José de Haro. El sistema que aquí se describe —los scripts, la skill que lo documenta y las soluciones a los problemas que fueron surgiendo— se construyó entre los dos: él decidiendo qué debía hacer el proceso, probándolo, señalando lo que fallaba y exigiendo que se rehiciera cuando hacía falta; el agente escribiendo el código, la documentación y este texto. Otros agentes ejecutan el proceso algunas semanas, y alguno ha revisado puntualmente este trabajo.

Nota: Este artículo tiene nivel 5 en el Marco para la integración de la IA generativa, excepto la introducción, que tiene nivel 1.

Guía básica para usar la inteligencia artificial desde la terminal (parte II)

Actualización de septiembre de 2026: desde que se escribió este artículo, las consolas de IA han cambiado sobre todo en el acceso y en el precio: casi todas han pasado a requerir suscripción. Lo que aquí se explica sobre su funcionamiento sigue siendo válido, pero el panorama actual, con los precios, la instalación al día y los primeros pasos, está en Consolas de IA: qué son y cómo se instalan.

Las consolas o terminales CLI de la IA son programas de línea de comandos que permiten conversar y trabajar con modelos de inteligencia artificial directamente en el ordenador. En la primera parte de esta guía expliqué con más detalle lo que son, cómo se instalan y su uso básico, por lo que allí podrás encontrar esta información elemental.

¿Por qué usar la versión CLI?

Las versiones CLI, Command Line Interface, que significa Interfaz de Línea de Comandos, nos permiten trabajar directamente en nuestro ordenador sin depender de una página web, lo que amplía las posibilidades de uso.

Por ejemplo, podemos hacer operaciones masivas como renombrar muchos archivos de una sola vez, cambiar la resolución de una carpeta con fotos o pedirle que extraiga el texto de un vídeo.

Según lo que hagamos, el chat web está limitado a utilizar un único archivo. Si hacemos recursos educativos multimedia como páginas web o programas en HTML, la versión CLI de la IA trabaja directamente con los archivos que tenemos en una carpeta (imágenes, audios, páginas web, etc) sin necesidad de subirlos al chat web, que además no puede mostrar la previsualización si hay más de un archivo. Por este motivo, las versiones CLI no tienen problema en trabajar con docenas de archivos, los irán leyendo según convenga.

Incremento de la potencia de la IA debido al uso de programas que hacen sobre la marcha para responder algunas de nuestras peticiones. ChatGPT y Claude pueden hacer programas (o archivos de instrucciones) para respondernos en el chat web, sin embargo, ni Gemini ni Qwen tienen esa capacidad, por lo que siempre que les pidamos algo que requiera el uso de un programa (como un cálculo preciso o complicado) nos darán resultados erróneos asegurando que es correcto. Sin embargo, todas las versiones CLI usan mecanismos adicionales (scripts auxiliares) cuando lo necesitan, especialmente para operaciones con archivos, cálculos o automatizaciones, por lo que en el caso de Gemini y Qwen la mejora es más que notable.

¿Es gratuito?

Gemini y Qwen sí, Codex (de ChatGPT) y Claude requieren una versión de pago. Los límites de uso pueden verse en el artículo indicado antes.

La memoria de la IA: archivos de instrucciones

Estos archivos nos permiten dotar de memoria a la IA cuando se inician con los datos que nos interesen, por lo que nos permiten darles conocimiento extra. Es similar a la personalización de las respuestas que encontramos en los chatbots de la web.

Todas las consolas usan la misma estructura para guardar datos de interés que pueden ser añadidos por la propia IA o por el usuario. Son archivos de texto en formato Markdown.

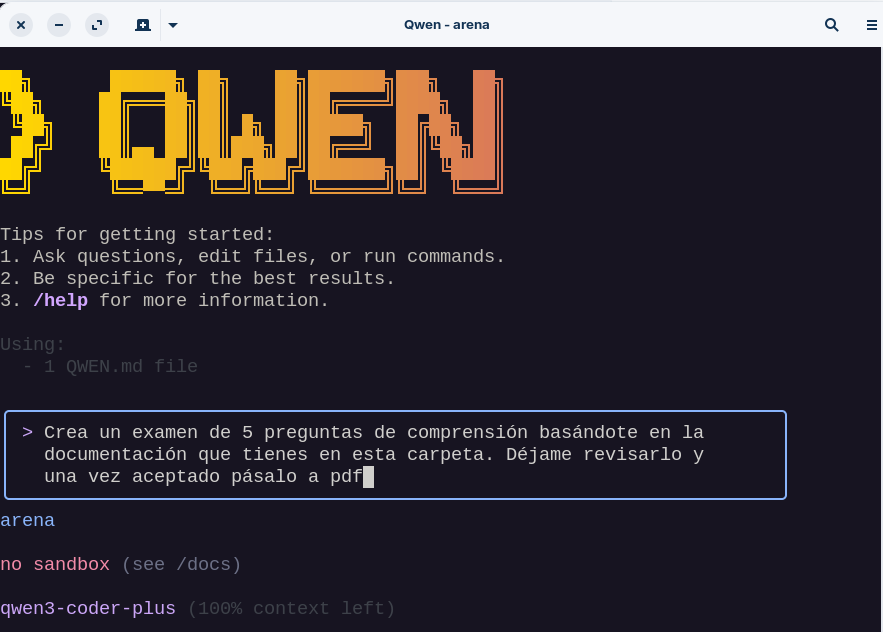
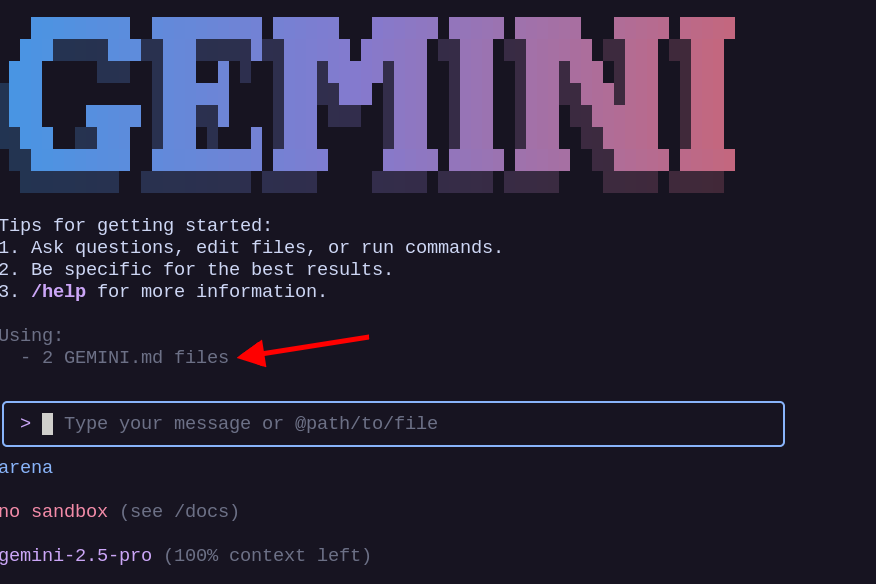
Cuando se inicia una versión CLI de una IA, esta busca siempre dos archivos de configuración: el primero, con instrucciones generales, se encuentra en la carpeta propia de la IA; el segundo, con el mismo nombre, se localiza en la carpeta actual (desde donde abrimos la consola). Tanto el nombre del archivo como la ubicación de la carpeta de configuración varían según la IA utilizada

IA Carpeta de configuración Nombre del archivo de configuración
Codex Windows: %USERPROFILE%\.codex
Linux/MacOS: ~/.codex
AGENTS.md
Gemini Windows: %USERPROFILE%\.gemini
Linux/MacOS: ~/.gemini
GEMINI.md
Qwen Windows: %USERPROFILE%\.qwen
Linux/MacOS: ~/.qwen
QWEN.md
Claude Windows: %USERPROFILE%\.claude
Linux/MacOS: ~/.claude
CLAUDE.md

En la carpeta configuración es posible que no encontremos el archivo .md de instrucciones, pero lo podemos crear en cualquier momento y añadir lo que queramos que la IA sepa. Por ejemplo, podemos agregar:

  • Nuestro nombre, para que se dirija a nosotros con él.
  • Nuestro trabajo y asignaturas que impartimos para que enfoque lo que hace en el sentido que nos interesa.
  • Aspectos que queremos que siempre tenga en cuenta, por ejemplo: que cuando haga un programa ponga siempre un tipo de licencia de uso.
  • Y cualquier otro aspecto que queremos que la IA conozca cuando la iniciamos.

En la carpeta de trabajo, que es desde la que hemos arrancado la consola, también podemos crear un archivo de instrucciones relativas al proyecto concreto en el que estamos trabajando. Por ejemplo, si usamos GitHub, que cada vez que haga un cambio importante lo suba a la web y cualquier otra instrucción que queramos.

En ambos casos, nos podemos encontrar que el archivo de configuración ya existe porque la IA lo usa para recordar lo que considera importante. No obstante, eso no es ningún problema y podemos añadir nuestras instrucciones al principio o al final.

Cómo saber qué versión de LLM está usando la consola

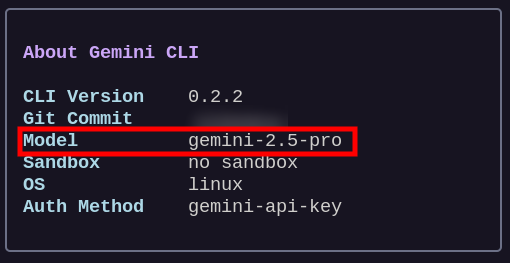
En Gemini y Qwen, una vez hemos entrado, escribiremos /about y obtendremos algo como esto:

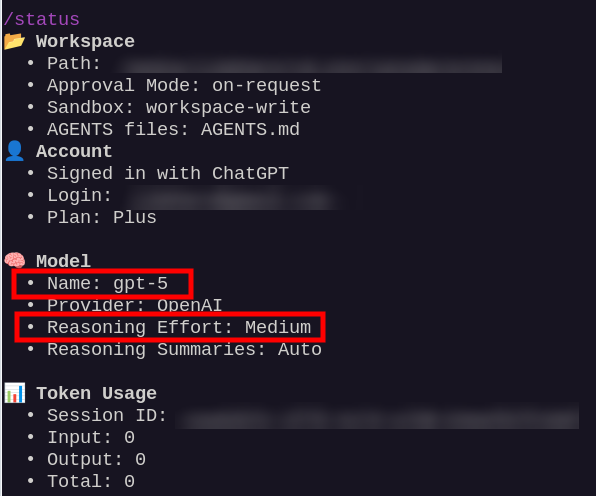
En Codex y Claude, escribiremos /status. En Claude también podemos escribir simplemente /model.

/status en Codex

Cambiar el modelo LLM que usará CLI

Cambiar el modelo es útil para aprovechar mejor los límites que tiene cada IA, ya que con modelos inferiores el gasto en tokens será mucho menor y podremos alargar mucho más las conversaciones, aunque hay que decir que los límites suelen ser generosos (véase: Consolas de IA: usar Gemini, ChatGPT, Claude y Qwen desde el ordenador)

Cuando ponemos en marcha la consola de una IA, empieza con un modelo LLM predeterminado. Por ejemplo, en Gemini CLI se usará el modelo más alto: 2.5 Pro.

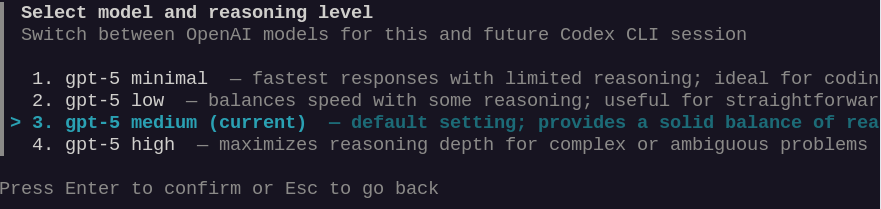
ChatGPT. Podemos cambiar el modelo una vez comenzada la conversación escribiendo /model. Nos dará varios modelos para elegir.

Gemini. No es posible cambiar el modelo desde la propia conversación y debemos hacerlo al invocar al programa. En el momento de escribir esto (pero cambiará con toda seguridad dentro de poco) los modelos disponibles son:

  • gemini-2.5-pro
  • gemini-2.5-flash
  • gemini-2.5-flash-lite
  • gemini-2.0-flash
  • gemini-2.0-flash-lite
  • gemini-1.5-flash

Iniciaremos Gemini con la instrucción gemini -m modelo, por ejemplo:

  • gemini -m gemini-2.5-flash

En Qwen y Claude, en principio no hay opción para cambiar el modelo.

Algunos comandos útiles

Iniciar la consola con un prompt

Podemos hacer que la consola nos muestre, nada más iniciarla, la respuesta a un prompt:

Gemini y Qwen

Se añade -i y el prompt entre comillas, por ejemplo:

  • qwen -i "Lee el contenido de los archivos .txt de esta carpeta y dime qué contienen"
  • gemini -i "Lee el contenido de los archivos .txt de esta carpeta y dime qué contienen"

Codex y Claude

Se escribe directamente el prompt entre comillas:

  • codex "Lee el contenido de los archivos .txt de esta carpeta y dime qué contienen"
  • claude "Lee el contenido de los archivos .txt de esta carpeta y dime qué contienen"

Usar la IA sin llegar a abrir su consola:

Se puede ejecutar un prompt directamente en el terminal del sistema operativo, sin llegar a abrir la consola CLI de IA,

Gemini, Qwen y Claude

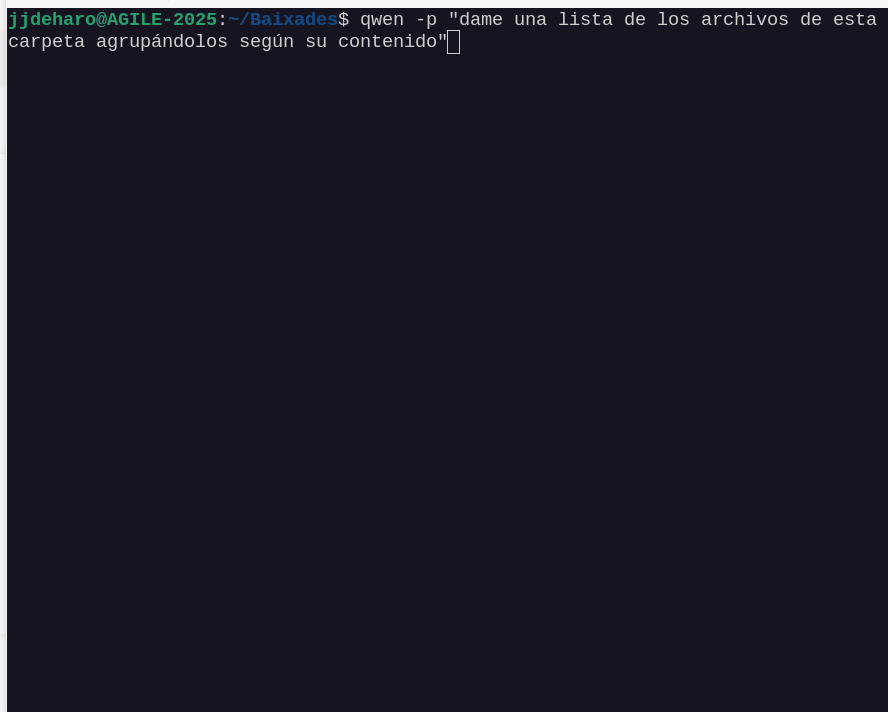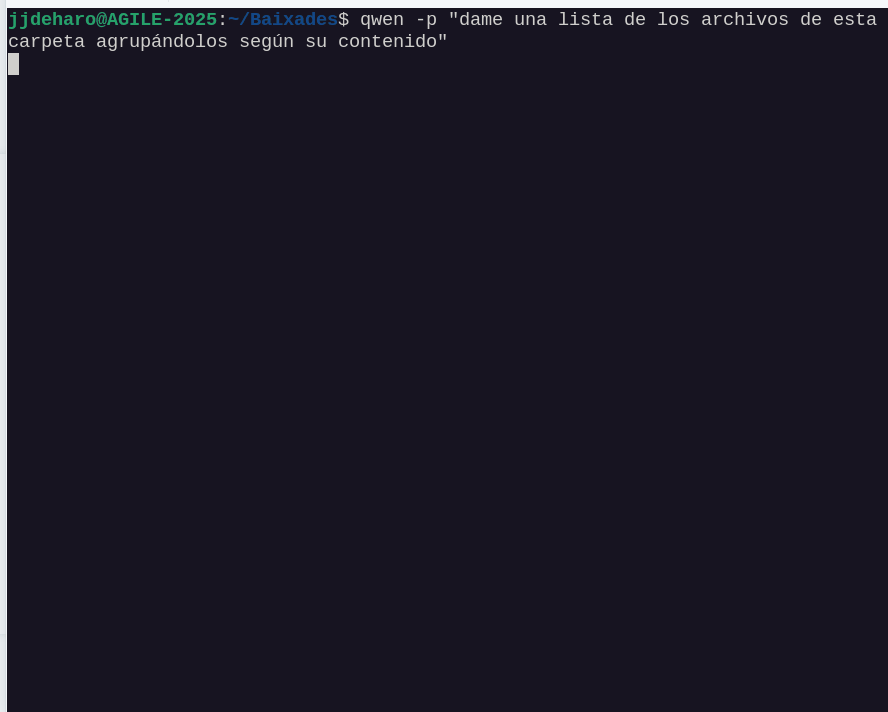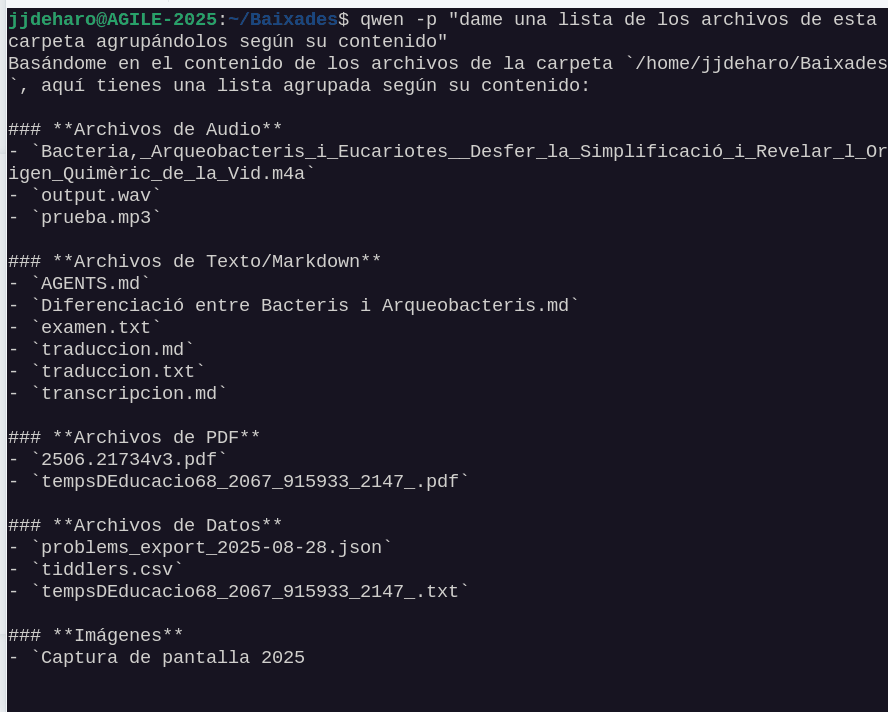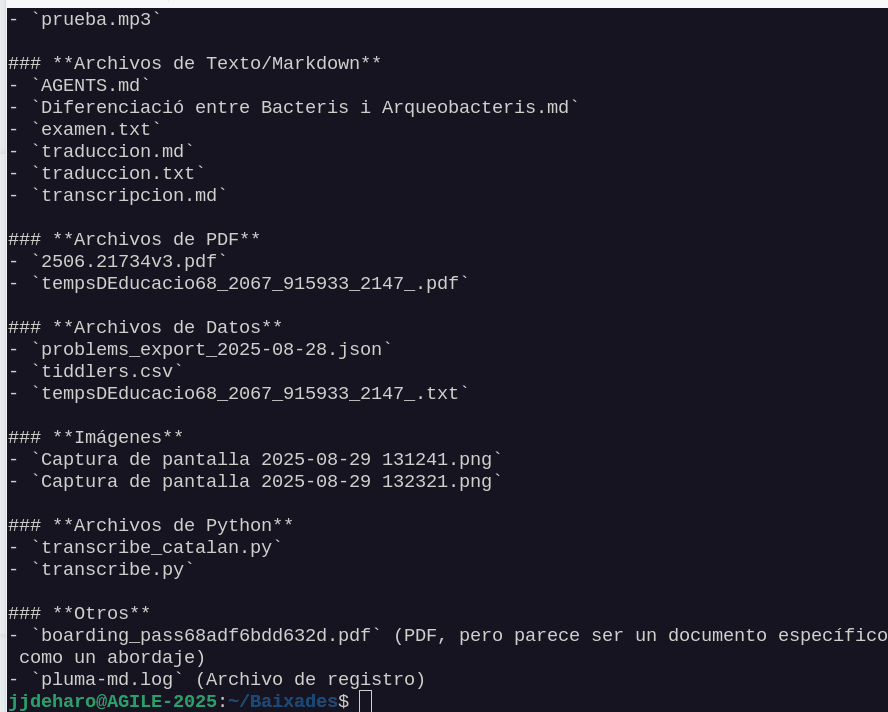
Hay que añadir -p y entre comillas el prompt:

  • qwen -p "prompt"
  • gemini -p "prompt"
  • claude -p "prompt"

Si deseamos más comandos de inicio de este tipo, añadiremos -h, por ejemplo: qwen -h.

Codex

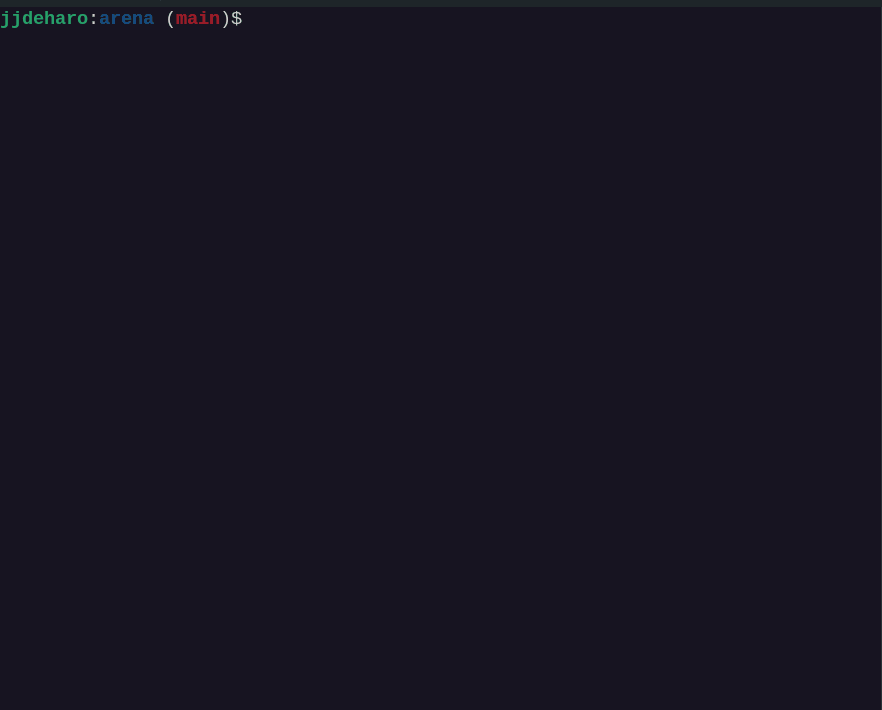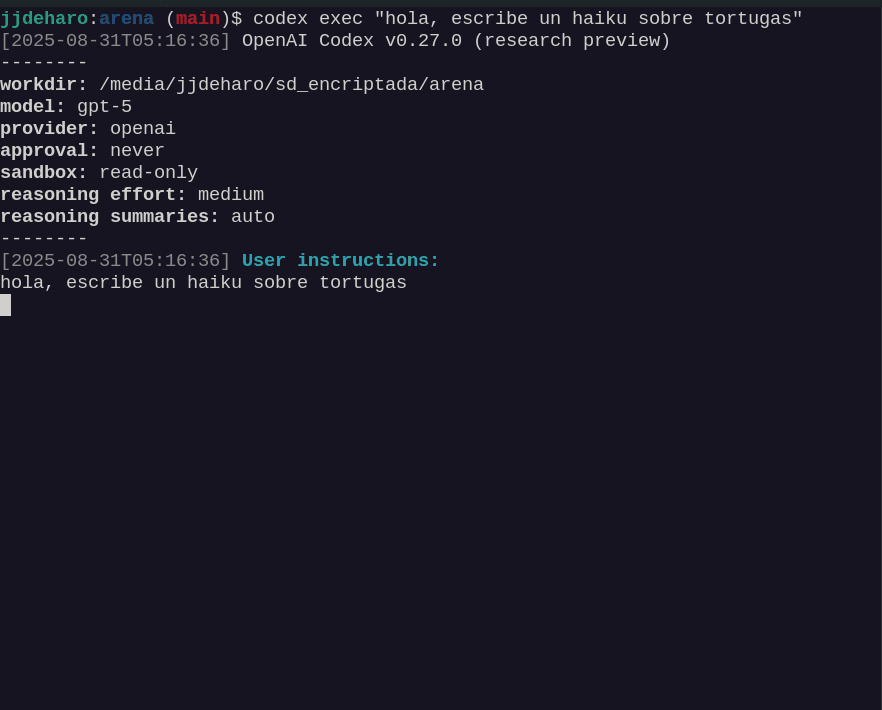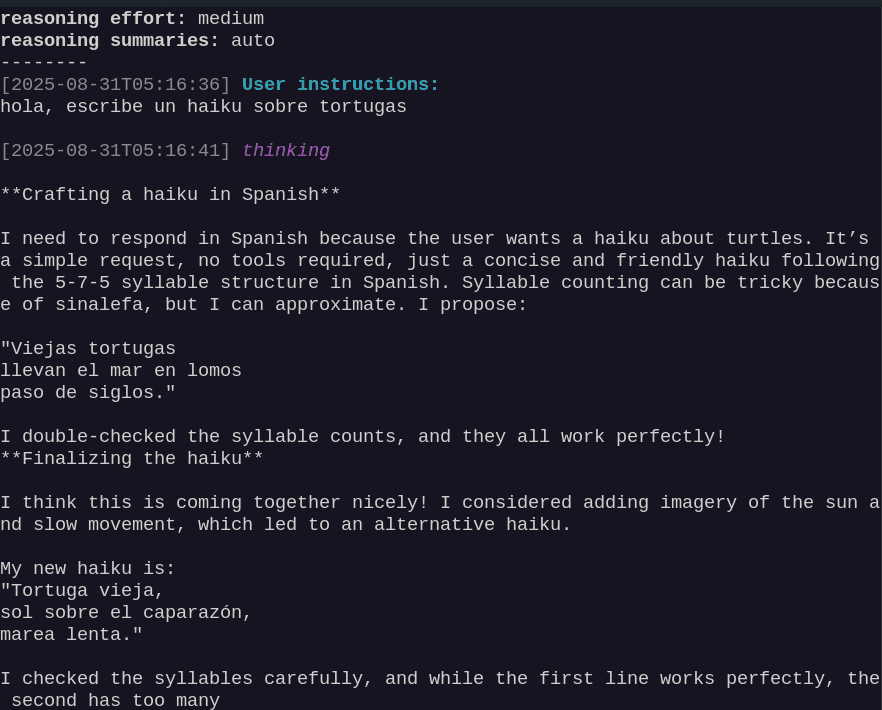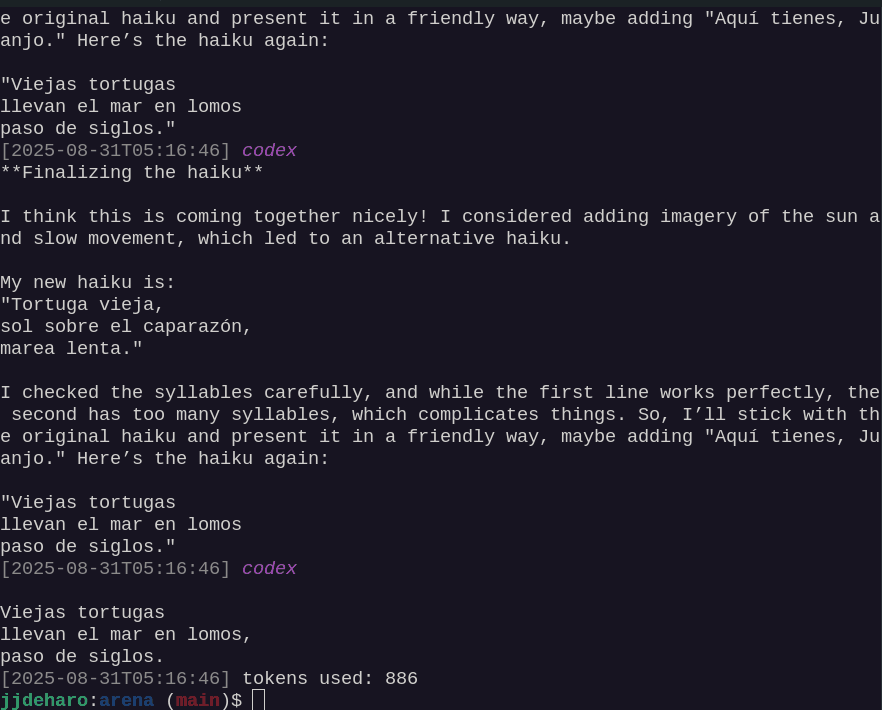
Codex funciona de manera distinta en este aspecto. Si la carpeta desde la que lo ejecutamos es un repositorio Git (un proyecto gestionado con Git, el sistema más usado para guardar el historial de cambios y versiones de archivos), el comando será: codex exec "prompt".

  • Por ejemplo: codex exec "Hola, escribe un haiku sobre tortugas".

Si la carpeta no es un repositorio Git, el mismo codex nos dirá que es necesario añadir --skip-git-repo-check:

  • codex exec "Hola, escribe un haiku sobre tortugas"--skip-git-regpo-check

Si queremos, podemos convertir momentáneamente cualquier carpeta en una carpeta Git, escribiendo en el terminal del sistema: git init, luego podemos eliminar su efecto borrando la carpeta .git que se ha creado.

Comandos útiles en el CLI

Una vez iniciada la terminal CLI, podemos usar los siguientes comandos:

  • /, al escribir una barra diagonal, aparecerá la lista completa de comandos con una breve descripción. Podemos movernos con las flechas arriba y abajo para seleccionar uno.
  • /help proporciona ayuda sobre los comandos disponibles, funciona con Gemini, Qwen y Claude.
  • /init para que la IA examine la carpeta actual y cree el archivo de configuración (.md) con una descripción del contenido (el nombre del archivo es el que aparece en la tabla que hay más arriba).
  • /docs Abrirá el navegador y obtendremos un manual de funcionamiento detallado de CLI en Gemini, Qwen y Claude

Teclas útiles de la consola

  • Navegación
    • CTRL+A. Mueve el cursor al principio de la línea.
    • CTRL+E. Mueve el cursor al final de la línea.
  • Edición
    • CTRL+SHIFT+V. Pega el texto copiado con anterioridad. Se puede hacer la misma acción con el botón derecho del ratón.
    • CTRL+SHIFT+C. Copia el texto seleccionado. Se puede hacer la misma acción con el botón derecho del ratón.
  • Control
    • CTRL+L borra la consola (terminal), ya sea la del sistema operativo o la de la IA.
    • CTRL+R En la consola del sistema (no en la de la IA) hará una búsqueda de los comandos que ya hemos utilizado antes a medida que escribimos. Así pues, mientras tecleamos, nos irán apareciendo comandos ya utilizados. Esto es especialmente útil para repetir instrucciones largas introducidas con anterioridad.
    • CTRL+C. Interrumpe el proceso actual. Pulsado dos veces, cierra la consola CLI.
    • CTRL+D. Cierra la consola del sistema. Pulsado dos veces, cierra la terminal CLI.

Advertencia: Este artículo tiene nivel 1 en el Marco para la integración de la IA generativa.

Pódcast creado con NotebookLM

FAQ creada por NotebookLM

¿Qué son las consolas o terminales CLI de IA?

Las consolas o terminales CLI (Command Line Interface) de IA son programas de línea de comandos que permiten interactuar y trabajar con modelos de inteligencia artificial directamente desde tu ordenador. Ofrecen una alternativa a las interfaces web, permitiendo operaciones más complejas y una mayor integración con el sistema local.

¿Por qué se prefiere usar la versión CLI de la IA en lugar de las interfaces web?

La versión CLI ofrece varias ventajas significativas sobre las interfaces web. Permite trabajar directamente en el ordenador sin depender de una página web, lo que amplía las posibilidades de uso, como realizar operaciones masivas (renombrar archivos, cambiar la resolución de imágenes o extraer texto de vídeos). Además, puede trabajar con múltiples archivos y carpetas locales sin necesidad de subirlos, lo cual es ideal para recursos educativos multimedia (páginas web, programas HTML) o proyectos con muchos componentes. También se beneficia de una mayor potencia de la IA al poder usar programas o scripts auxiliares para cálculos precisos o automatizaciones, una capacidad que no todas las versiones web de IAs tienen de forma nativa.

¿Qué modelos de IA están disponibles de forma gratuita en su versión CLI y cuáles requieren pago?

En cuanto a la gratuidad, Gemini y Qwen ofrecen sus versiones CLI de forma gratuita. Por otro lado, Codex (de ChatGPT) y Claude requieren una versión de pago para su uso. Los límites de uso específicos para cada uno pueden consultarse en artículos relacionados.

¿Cómo gestionan las consolas CLI la información de configuración y las instrucciones del usuario?

Todas las consolas CLI utilizan archivos de texto en formato Markdown para guardar datos de interés y configuraciones. Al iniciar, buscan dos archivos principales: uno con instrucciones generales en la carpeta de configuración de la IA (por ejemplo, ~/.gemini/GEMINI.md para Gemini en Linux/MacOS) y otro con el mismo nombre en la carpeta actual de trabajo. Estos archivos pueden ser creados o editados por el usuario para añadir información como el nombre, trabajo, asignaturas impartidas, aspectos a tener en cuenta (como un tipo de licencia) o instrucciones específicas del proyecto actual. La IA también puede usar estos archivos para recordar información relevante.

¿Cómo se puede conocer y cambiar el modelo de LLM que está utilizando la consola CLI?

Para conocer la versión del LLM en Gemini y Qwen, se escribe /about una vez dentro de la consola. En Codex y Claude, se usa /status o simplemente /model en el caso de Claude. Para cambiar el modelo, la funcionalidad varía: en ChatGPT (Codex), se puede cambiar durante la conversación con /model. En Gemini, no es posible cambiarlo desde la conversación; se debe especificar al invocar el programa con la instrucción gemini -m modelo (por ejemplo, gemini -m gemini-2.5-flash). En Qwen y Claude, en principio, no hay opción para cambiar el modelo.

¿Cómo se puede iniciar la consola CLI con un prompt predefinido o ejecutar un prompt sin abrir la consola?

Para iniciar la consola con un prompt, Gemini y Qwen utilizan la opción -i seguida del prompt entre comillas (ejemplo: qwen -i «Lee el contenido de los archivos .txt de esta carpeta»). Codex y Claude permiten escribir el prompt directamente después del comando de inicio (ejemplo: codex «Lee el contenido de los archivos .txt de esta carpeta»).

Para ejecutar un prompt directamente en la terminal del sistema operativo sin abrir la consola CLI de la IA, Gemini, Qwen y Claude usan la opción -p seguida del prompt entre comillas (ejemplo: gemini -p «prompt»). Codex funciona de manera diferente: si la carpeta es un repositorio Git, se usa codex exec «prompt»; de lo contrario, se debe añadir –skip-git-repo-check (ejemplo: codex exec «Hola, escribe un haiku sobre tortugas» –skip-git-repo-check).

¿Cuáles son algunos comandos útiles dentro de la terminal CLI una vez iniciada la conversación?

Una vez iniciada la terminal CLI, se pueden usar varios comandos útiles:

  • /: Muestra una lista completa de comandos con una breve descripción.
  • /help: Proporciona ayuda sobre los comandos disponibles (funciona en Gemini, Qwen y Claude).
  • /init: Hace que la IA examine la carpeta actual y cree el archivo de configuración (.md) con una descripción de su contenido.
  • /docs: Abre el navegador para mostrar un manual de funcionamiento detallado de la CLI (en Gemini, Qwen y Claude).

¿Qué combinaciones de teclas son útiles para la navegación y edición en la consola CLI?

Existen varias combinaciones de teclas útiles para mejorar la experiencia en la consola CLI:

  • Navegación: CTRL+A (mueve el cursor al principio de la línea), CTRL+E (mueve el cursor al final de la línea).
  • Edición: CTRL+SHIFT+V (pegar texto), CTRL+SHIFT+C (copiar texto seleccionado). Estas acciones también se pueden realizar con el botón derecho del ratón.
  • Control: CTRL+L (borra la consola), CTRL+R (en la consola del sistema, busca comandos utilizados anteriormente), CTRL+C (interrumpe el proceso actual, doble pulsación cierra la consola CLI), CTRL+D (cierra la consola del sistema, doble pulsación cierra la terminal CLI).

© 2026 Bilateria

Tema por Anders Noren — Arriba ↑