Blog sobre educación

Etiqueta: agentes de IA

Agentes de IA con mente colectiva que aprenden mientras duermen

Los agentes de inteligencia artificial que trabajan en el ordenador, como Claude Code, Codex o Antigravity, empiezan cada sesión sin recordar nada de la anterior. Lo que se les explicó ayer sobre un proyecto, una corrección o la forma de trabajar de la persona que los usa se pierde al cerrar la conversación, y hay que repetirlo. Una forma de evitarlo es organizar lo que necesitan saber en varias capas, de modo que cada sesión empiece sabiendo lo importante. Este artículo describe un sistema de este tipo, de dónde salen sus ideas y qué hace falta para montarlo.

Actualizado el 16 de noviembre de 2026: el perfil se divide en núcleo, anexos y una bandeja de entrada, y una pasada semanal del repaso lo ordena y lo mantiene por debajo de un tamaño máximo.

Pódcast del artículo realizado por Gemini Notebook

El olvido entre sesiones

Un agente trabaja con lo que cabe en su contexto, que es el texto que el modelo tiene delante en cada momento: las instrucciones, la conversación y los archivos que ha leído. Al terminar la sesión, ese contexto desaparece. Las herramientas ofrecen algunos remedios, como un archivo de instrucciones que se lee al empezar o una memoria donde el agente apunta lo que aprende, pero cada remedio por separado tiene un problema. Si se carga todo al empezar, el contexto se llena de información que casi nunca hace falta. Si se apunta sin orden, las notas se contradicen, se duplican y se quedan viejas.

El 6 de noviembre de 2026, Anthropic publicó un artículo de Lance Martin, «The components of agent memory», que ordena el problema en cuatro capas. Además, propone un proceso de consolidación al que llama dreaming (soñar). El sistema que se describe aquí sigue esa misma estructura, adaptada a un ordenador personal y sin servicios de pago aparte de la suscripción al agente.

Las cuatro capas de la memoria

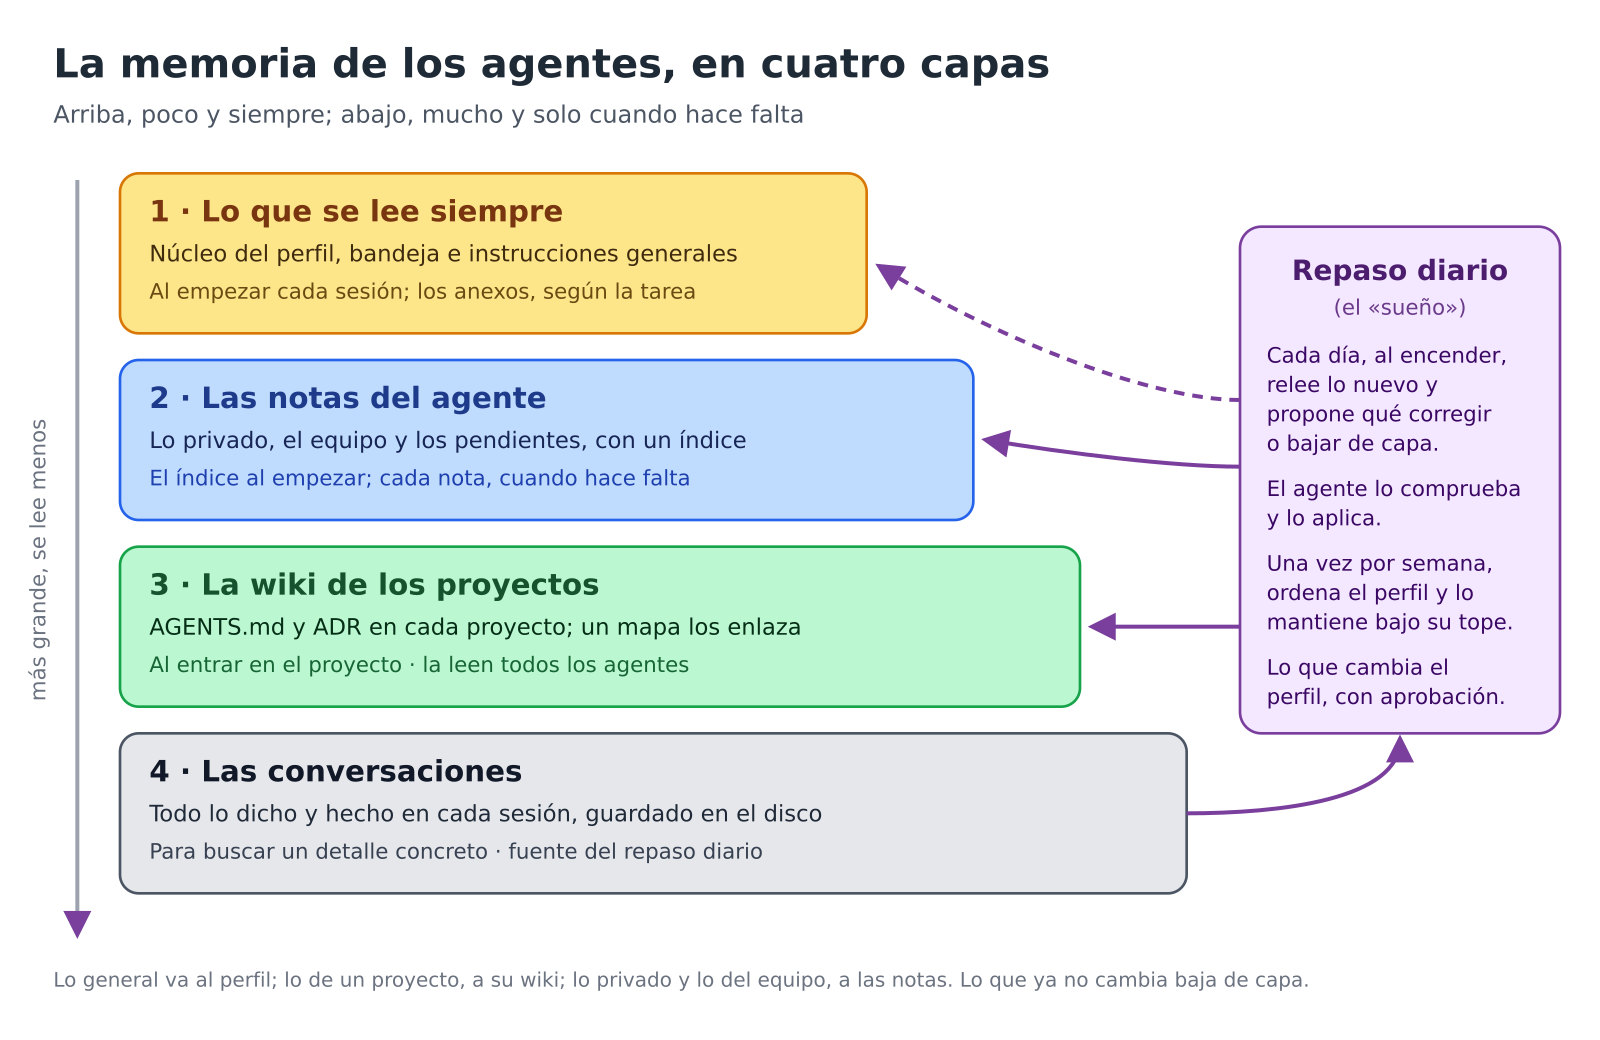
Cada capa guarda un tipo de información y se lee en un momento distinto. Las de arriba son pequeñas y se leen siempre; las de abajo son grandes y se consultan solo cuando hace falta.
Lo que se lee siempre

La primera capa es un perfil con la forma de trabajar y de decidir de la persona: qué le importa, cómo quiere que se le presenten las propuestas y qué errores no quiere que se repitan. Junto al perfil van unas instrucciones generales, por ejemplo dónde se guardan los informes o qué hacer antes de publicar algo. Todos los agentes lo leen al empezar cada sesión, y por eso tiene que ser breve. Cada criterio se anota una sola vez, con un único ejemplo, y solo entra lo general, lo que serviría igual en cualquier otro trabajo. El agente puede sacar un primer perfil de las conversaciones que ya tenga guardadas; solo un agente recién instalado empieza con el perfil vacío, y entonces se llena con el uso.

Con el uso, el perfil crece, y todo lo que se lee siempre ocupa espacio en cada sesión. Por eso se organiza en un núcleo, unos anexos y una bandeja de entrada:

  • El núcleo recoge lo que vale en cualquier tarea y se lee siempre.
  • Los anexos recogen lo que solo sirve en un tipo de trabajo, como diseñar una página, programar o escribir para otras personas. El núcleo dice al principio cuándo se lee cada uno, y el agente lo abre solo cuando la tarea lo pide.
  • La bandeja de entrada es el único sitio del perfil donde escriben los agentes. Cuando la persona corrige algo o aprueba una propuesta, el agente añade una línea con la fecha, el criterio y una cita breve, y se lo dice en una frase. La bandeja se lee con el núcleo, así que lo apuntado vale desde ese momento.

El núcleo y los anexos solo cambian en la pasada semanal del repaso, que se explica más adelante.

Las notas del agente

La segunda capa es la memoria del agente: notas cortas, una por tema, con un índice que el agente lee al empezar y que le dice qué hay en cada nota. Claude Code la trae activada y carga al empezar las primeras 200 líneas del índice; el resto de notas las abre cuando las necesita. Aquí va lo privado y lo del propio equipo: qué servidores hay, dónde están las credenciales (nunca las contraseñas), qué trucos tiene cada herramienta y qué tareas quedaron pendientes.

Las tareas pendientes con fecha se recuerdan con un pequeño programa que se ejecuta al abrir cada sesión y que en Claude Code se llama hook (gancho). Si la tarea es de la persona, el aviso aparece una vez al día como mucho. Si es trabajo del agente, se le pasa a él, que la hace y solo cuenta el resultado.

La wiki de los proyectos

La tercera capa está formada por documentos dentro de cada proyecto, en la misma carpeta que su código o su contenido:

  • El archivo AGENTS.md recoge lo que hay que saber para trabajar en ese proyecto: cómo se prueba, dónde se publica, qué no se puede olvidar. Es un formato abierto que mantiene la Agentic AI Foundation, de la Linux Foundation, y que leen Codex, Claude Code y otros agentes al entrar en la carpeta.
  • Los ADR, siglas en inglés de Architecture Decision Record (registro de decisiones de arquitectura), guardan el porqué de cada decisión importante y las alternativas que se descartaron. El formato lo propuso Michael Nygard en 2011 en «Documenting Architecture Decisions», y la guía Vibe coding responsable explica cómo usarlos al programar con IA.

Estos documentos se actualizan en el mismo cambio que la decisión que recogen, y por eso no se quedan viejos con tanta facilidad como una copia guardada en otro sitio. Por encima de todos ellos hay un mapa de proyectos, con una ficha por proyecto que recoge su estado, sus temas y los enlaces a su AGENTS.md y a sus ADR. El mapa tiene un buscador que mira a la vez en las fichas y en todos esos documentos. Es la misma idea que Andrej Karpathy describe en «LLM Wiki»: un conjunto de archivos Markdown enlazados que la propia IA mantiene al día.

Las conversaciones

La cuarta capa son las conversaciones completas, que los agentes guardan en el disco. Son el material en bruto: no se leen en cada sesión, pero cualquier agente puede consultarlas cuando hace falta recuperar lo que se dijo o se decidió en una sesión concreta, y son la fuente del repaso diario. Como cada agente las guarda a su manera, en formatos distintos y llenas de resultados de las herramientas, conviene un pequeño buscador común: reúne las conversaciones de todos los agentes y, ante una pregunta, devuelve solo los fragmentos del diálogo que tratan de ella, con su fecha y su proyecto. Lo programa el propio agente, y las instrucciones generales de todos indican cómo usarlo. Conviene comprobar cuánto tiempo las guarda cada agente: Claude Code, por ejemplo, las borra a los 30 días si no se amplía ese plazo en sus ajustes.

Una mente colectiva

Cada sesión es, en la práctica, un agente nuevo: empieza sin recordar nada y desaparece al cerrarla. Con este sistema, al empezar recibe lo que han aprendido todas las sesiones anteriores, de ese mismo agente o de otro, como Claude Code, Codex o Antigravity. Lee el mismo perfil, la misma wiki y puede buscar en todas las conversaciones. Ese conocimiento cambia su forma de trabajar desde el primer momento, y lo que aprende durante la sesión vuelve al conjunto con sus notas y con el repaso diario. El resultado se parece al colectivo Borg de Star Trek: muchos individuos que comparten una misma memoria. Pero cada sesión conserva su individualidad: razona por su cuenta, puede equivocarse y lo que aporta se revisa antes de entrar en el perfil.

Dónde va cada cosa

Con varias capas, la duda frecuente es dónde apuntar algo nuevo. La regla es sencilla: lo general sobre la persona va al perfil, a través de su bandeja; lo de un proyecto, a su AGENTS.md o a un ADR; lo privado y lo del equipo, a la memoria del agente. Hay que tener en cuenta que muchos proyectos son públicos, así que en su AGENTS.md no puede aparecer nada personal, como direcciones de la red de casa, nombres o cuestiones económicas.

La información también cambia de capa con el tiempo. Una nota que empezó en la memoria mientras se probaba algo pasa al AGENTS.md del proyecto cuando ya no cambia, y desde ahí la ven todos los agentes, no solo el que la apuntó. Esta regla está escrita en las instrucciones generales de todos los agentes, para que cualquiera de ellos la aplique.

El repaso diario

Durante el día los agentes apuntan con prisa, en medio del trabajo, y algunas notas salen mal o se quedan viejas. El artículo de Anthropic propone un proceso de consolidación, inspirado en lo que hace el cerebro durante el sueño, que repasa las conversaciones y las notas para corregir errores y reorganizar lo aprendido. En sus pruebas, una wiki construida así hizo que el agente pasara de responder bien el 13 % de las preguntas sobre un conjunto de documentos al 48 %.

El ejemplo de Anthropic hace el repaso cada noche. En un ordenador personal, que de noche suele estar apagado, se hace una vez al día en cuanto se enciende: el día del repaso empieza de madrugada, a una hora en que el equipo nunca está en marcha, y un programa comprueba cada pocos minutos si ya se ha hecho. Si no, lanza un agente que lee lo que ha escrito la persona en todas las conversaciones desde el repaso anterior y lo compara con el perfil, las notas y la wiki. Si ese día no ha habido conversaciones, no lanza nada. Busca criterios que nadie apuntó, notas que ya no son ciertas, duplicados e información que debería bajar de capa. El agente del repaso solo puede leer y escribir un archivo, así que no cambia nada: deja una propuesta por escrito, con el texto actual y el propuesto en cada punto. Las instrucciones que recibe el agente del repaso están en el archivo repaso-diario-memoria.txt. No hace falta tocarlas: el agente que monta el sistema las adapta al ordenador.

En la siguiente sesión, el agente revisa esa propuesta y comprueba cada punto antes de aplicarlo, porque el repaso también se equivoca: en el primero, que abarcó una semana entera, uno de sus once hallazgos era falso. Lo que toca a la memoria y a la wiki lo aplica directamente. Los criterios nuevos que el repaso propone para la bandeja los presenta a la persona, todos juntos, y no se apuntan hasta que los aprueba.

Una vez por semana, el repaso hace además una pasada por el perfil entero. Primero coloca cada entrada de la bandeja en su sitio: si el criterio ya estaba, no se añade; si contradice otro, lo corrige; si es nuevo, va al núcleo o al anexo que toque. Después busca criterios repetidos, contradicciones y puntos mal situados. Por último, mira lo que mide cada documento, que tiene un tope y un objetivo más bajo. Cuando un documento pasa del tope, el repaso propone recortarlo hasta el objetivo, para dejar margen y no tener que recortar cada día. Lo que se quita va a un archivo aparte, que no se lee en cada sesión, con la fecha y el motivo, y así se puede recuperar. La pasada la hace el agente del repaso, que no escribió esas anotaciones y las lee con ojos nuevos.

La persona no tiene que aprobarlo todo. Colocar una entrada en su sitio se hace sin preguntar, porque ya se le dijo al apuntarla. Fundir dos criterios cambiando la redacción o retirar uno sí necesita su aprobación, con el texto de antes al lado del de después.

Anthropic ofrece este proceso como servicio en su plataforma para desarrolladores, con un ejemplo publicado que se paga por uso. Con un agente instalado en el ordenador, en cambio, el repaso corre con la misma suscripción que el resto del trabajo.

La copia de seguridad

Todo esto vive en archivos del ordenador: el perfil, las notas, las conversaciones, los ajustes de los agentes y la lista de tareas programadas. Por eso conviene incluirlo en la copia de seguridad, cifrada, porque las conversaciones contienen de todo. Conviene también tener por escrito cómo recuperarlo en otro ordenador, con los pasos en orden, para que un cambio de equipo no obligue a empezar de cero.

Límites y precauciones

El sistema tiene algunos inconvenientes que conviene conocer:

  • El perfil y el índice cuestan contexto. Todo lo que se carga al empezar ocupa espacio en cada sesión, y un error apuntado ahí se repite en todas. Sin una medida, cada anotación parece pequeña y el conjunto solo crece: en el sistema descrito, el perfil llegó a casi 11.000 palabras en dos meses. Al repartirlo en núcleo y anexos, la parte del perfil que se lee siempre bajó a unas 6.300 palabras, más la bandeja. Cada documento se mide a diario, y en las próximas semanas se verá si con la pasada semanal el tamaño se mantiene estable.
  • El repaso se equivoca. Sus propuestas se comprueban antes de aplicarlas, y el perfil necesita la aprobación de la persona.
  • Las conversaciones son sensibles. Contienen todo lo que se ha dicho y todo lo que el agente ha leído, así que no deben salir del ordenador sin cifrar.
  • Cada herramienta guarda su memoria a su manera. La memoria de Claude Code no la lee Codex, y al revés. Lo que deben saber todos los agentes tiene que ir al perfil o a la wiki, que sí leen todos.

Qué hace falta para montarlo

Solo hace falta un agente instalado en el propio ordenador, en su versión de consola o de escritorio, como Claude Code, Codex o Antigravity. No hace falta ningún servidor: el repaso diario se hace al encender el ordenador. El artículo «Consolas de IA: qué son y cómo se instalan» explica cuáles hay y cómo se instalan. En las versiones web no funciona, porque no pueden leer ni escribir los archivos del ordenador, que es donde vive la memoria.

No hay que montarlo a mano. Se le da al agente una sola vez el prompt que viene a continuación: él crea todas las piezas y solo pregunta lo que no puede saber. Desde ese momento, cada sesión nueva trabaja con este sistema, y lo único que hay que hacer es aprobar o rechazar los cambios del perfil que proponga el repaso diario.

Lee el artículo https://educacion.bilateria.org/agentes-de-ia-que-aprenden-mientras-duermen y monta en este ordenador su sistema de memoria, adaptado a mí. Decide tú los detalles técnicos, eligiendo siempre lo más sencillo y seguro, y créalo todo: el perfil, las notas, el aviso de tareas pendientes, el buscador de conversaciones, el repaso diario y la copia de seguridad. Si en este ordenador hay otros agentes, como Codex o Antigravity, haz que compartan el mismo sistema. No uses servicios de pago aparte de la suscripción: nada de la API. Para el repaso, parte de las instrucciones que enlaza el artículo; el agente del repaso solo puede leer archivos y escribir su propuesta. Asegúrate también de que las conversaciones no se borren solas. Para empezar el perfil, lee las conversaciones que tengas guardadas y tu memoria, y apunta solo lo que yo haya dicho o hecho; si no hay nada, hazme como mucho tres preguntas cortas. El repaso no debe cambiar nada por su cuenta: lo que toque al perfil me lo enseñarás para que diga sí o no. Pregúntame solo lo que no puedas saber tú, de una en una, con preguntas de sí o no o con dos opciones explicadas en palabras sencillas. Al terminar, cuéntame en cinco líneas qué has montado, qué tendré que hacer yo de forma habitual y cómo deshacerlo si no me convence.

Referencias

Juan José de Haro

Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.
Cómo preguntar a la IA sobre tus documentos: un Gemini Notebook en tu propio ordenador

Cualquier persona que trabaje con documentación acumula un fondo de textos que consulta una y otra vez: normativa, actas, memorias, apuntes, artículos. Preguntarle a una inteligencia artificial sobre ese material choca siempre con el mismo muro: hay que subirlo a algún sitio, o pegarlo en la conversación, o confiar en que el modelo lo recuerde de su entrenamiento, cosa que no ocurre.

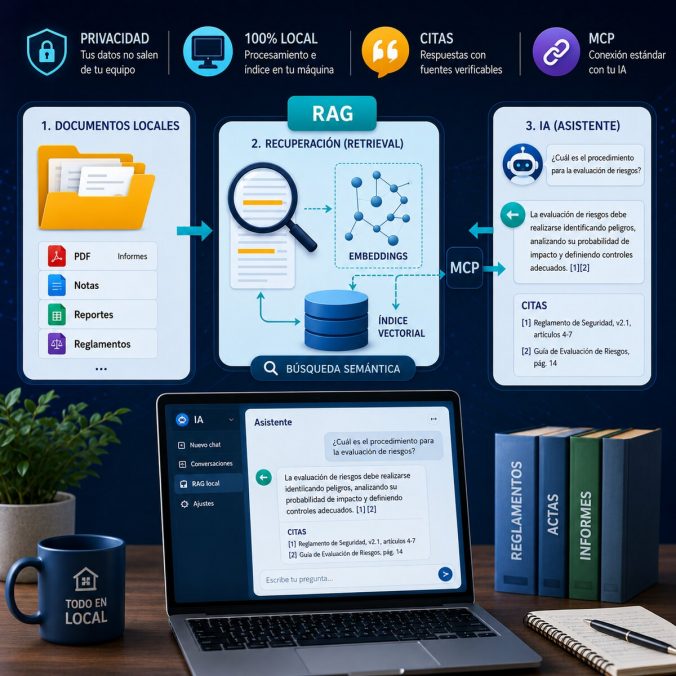
Este artículo explica qué es un RAG (Retrieval Augmented Generation, en español «generación aumentada por recuperación»), qué es el protocolo MCP (Model Context Protocol, en español «protocolo de contexto del modelo») que hace posible esa conexión, cómo funciona el conjunto y cómo montarlo sin escribir una línea de código.

Si solo quieres las instrucciones, ve directamente a la guía rápida del final: reúne las tres que hacen falta, listas para copiar y pegar. El resto del artículo explica qué hace cada una y por qué, que es lo que permite juzgar si el resultado es bueno.

El código está publicado: el sistema completo que se describe aquí, con un fondo documental de ejemplo ya indexado, está en github.com/jjdeharo/cuadernos-rag, con licencia libre. Quien prefiera verlo antes de leer nada más, puede empezar por ahí.

Pódcast del artículo realizado por Gemini Notebook

Qué es un RAG

Un buscador colocado delante de una inteligencia artificial.

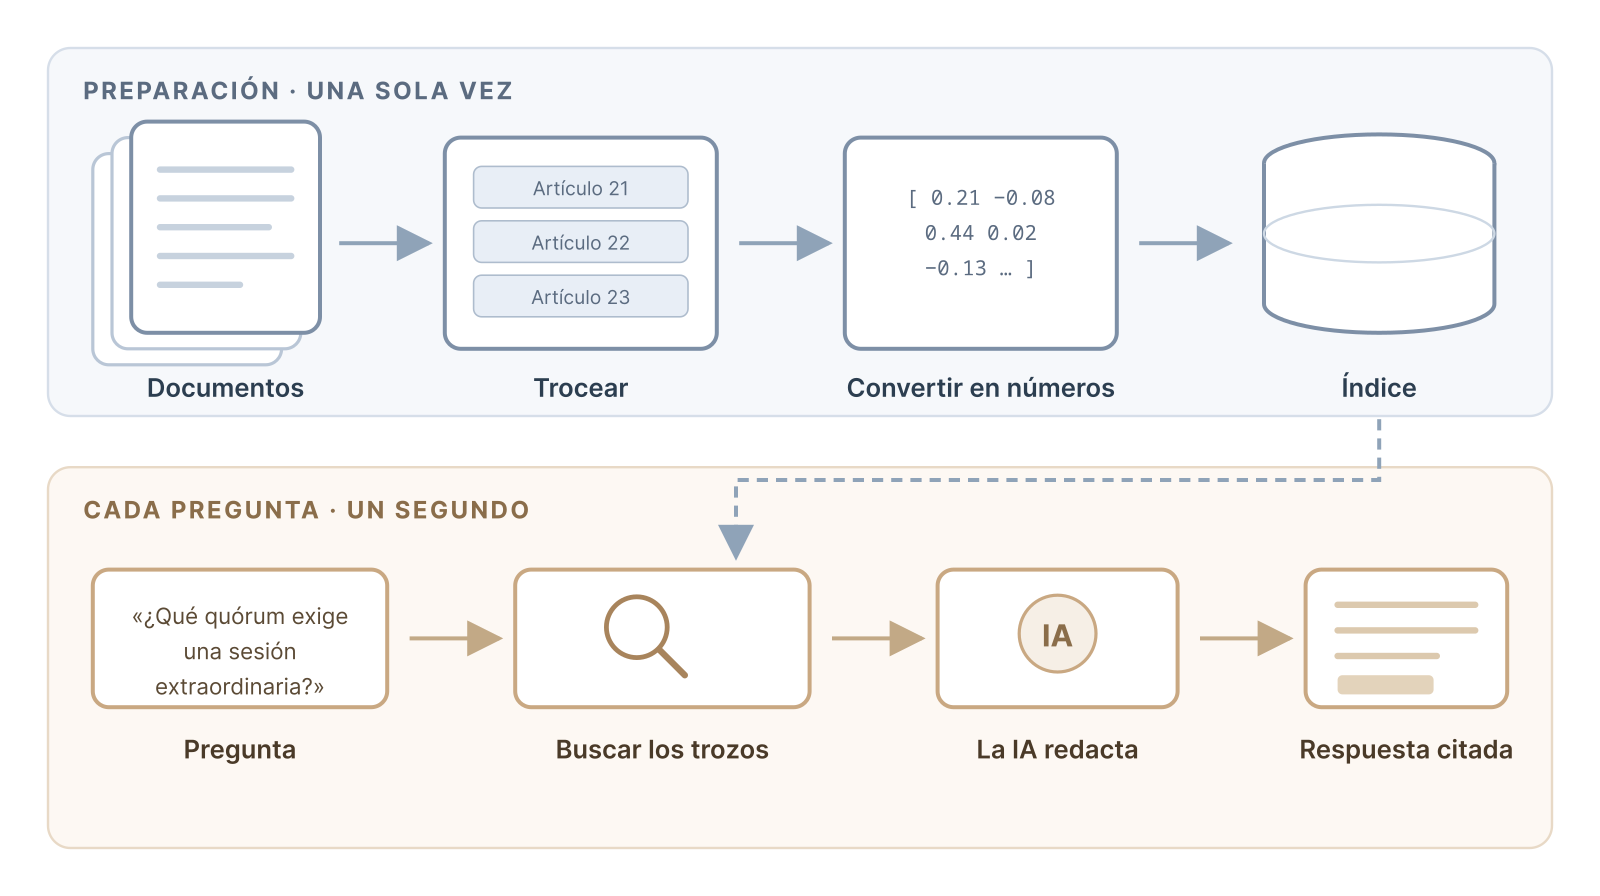
Un modelo de lenguaje, que es el programa que hay detrás de ChatGPT, Claude o Gemini, no puede leer mil páginas cada vez que recibe una pregunta porque no caben en una consulta y, aunque lo hiciese, resultaría lento y costoso. Lo que hace un RAG es localizar primero los pocos fragmentos que hacen falta para responder a esa pregunta concreta, y entregar solo eso. El modelo no aprende los documentos ni los memoriza: los consulta, como haría cualquiera con un libro delante, e indica de dónde ha salido cada afirmación.

La consecuencia práctica es doble. Por un lado, deja de haber límite de volumen: da igual que el fondo documental sean quinientas páginas o veinte mil, porque en cada consulta solo viajan unos pocos fragmentos. Por otro, y más importante, cada respuesta puede citar su fuente. En materia normativa o técnica, una respuesta sin fuente no tiene ningún valor.

Qué es el MCP

Un RAG, por sí solo, es una herramienta de línea de comandos: se le hace una pregunta y devuelve fragmentos. Útil, pero incómodo.

MCP son las siglas de Model Context Protocol, un estándar abierto propuesto por Anthropic a finales de 2024 y adoptado después por los demás asistentes. Resuelve un problema muy concreto: cómo permitir que una IA use herramientas externas sin que haya que programar una integración distinta para cada combinación de herramienta y asistente. Con MCP, quien construye la herramienta la describe una sola vez, y cualquier asistente compatible sabe cómo usarla.

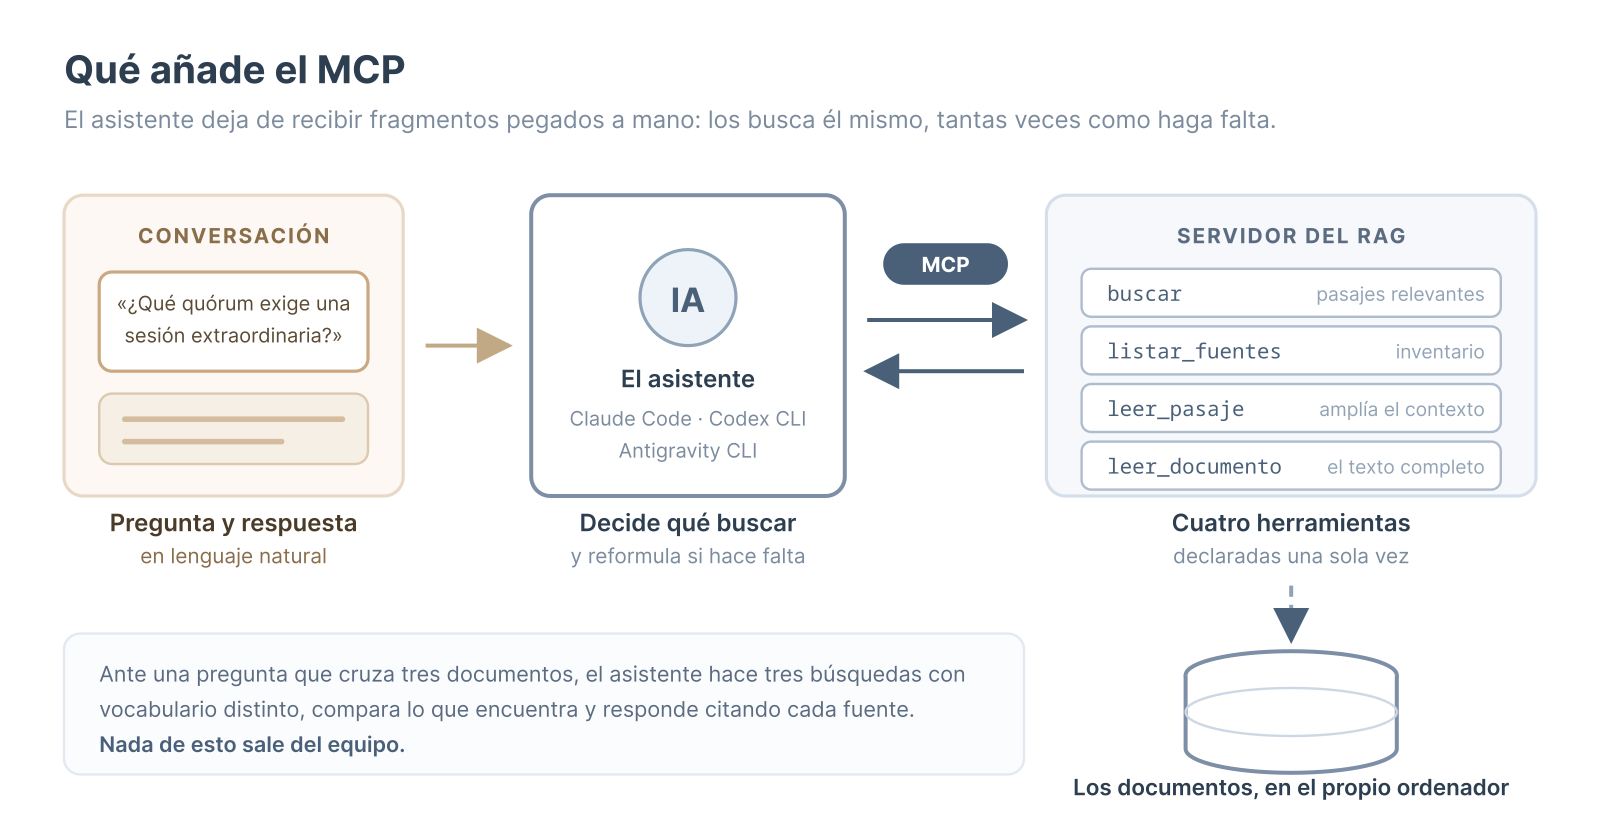
Aplicado a un RAG, el cambio es importante, ya que en lugar de ejecutar búsquedas a mano y pegar los resultados en una conversación, el asistente busca por su cuenta, tantas veces como necesite. Ante una pregunta que cruza tres documentos distintos, hace tres búsquedas con vocabulario distinto, compara lo que encuentra y responde citando cada fuente. El fondo documental deja de ser un archivo aparte y pasa a estar dentro de la conversación.

Un servidor MCP no es más que un programa que declara qué sabe hacer. En el caso de un RAG documental, cuatro operaciones bastan: buscar pasajes, listar los documentos disponibles, ampliar el contexto de un pasaje concreto y recorrer un documento entero. El asistente decide cuándo usar cada una.

Conviene añadir una instrucción que gobierne su uso, porque sin ella el asistente tenderá a responder de memoria. Basta con una regla explícita: no afirmar nada que no proceda de una búsqueda, buscar varias veces reformulando con el vocabulario propio de cada fuente, citar siempre el identificador del pasaje, y decir con claridad cuándo el fondo documental no cubre la pregunta.

Cómo funciona por dentro

Son cuatro piezas, y solo la última tiene que ver con la inteligencia artificial tal y como la entiende la mayoría.

Convertir a texto. PDF, páginas web, documentos de Word, audio transcrito: todo tiene que acabar siendo texto plano. Un PDF no guarda un texto, guarda dónde va cada letra en la página; al leerlo hay que reconstruir el orden, y en tablas o en textos a dos columnas se falla a menudo. Es la pieza menos vistosa y la que estropea el resultado con más frecuencia.

Trocear. Consiste en partir cada documento en fragmentos manejables y, aunque parezca un detalle de poca importancia, es lo que más determina la calidad final. Un troceado rudimentario corta cada mil palabras sin atender a dónde cae el corte, mientras que uno cuidadoso respeta la estructura del texto: en una norma, por ejemplo, un fragmento por artículo. La diferencia se aprecia en cuanto se formula una consulta concreta, porque en el primer caso llega un trozo que empieza a mitad de un artículo y se interrumpe antes de acabar el siguiente, mientras que en el segundo llega el artículo completo, con su título.

Convertir cada fragmento en números. De esto no se encarga un asistente de los que conversan, sino un programa mucho más pequeño, entrenado para una sola tarea: no redacta ni responde nada, solo lee un texto y devuelve números. A cada fragmento le asigna una lista de más de mil números que funciona como unas coordenadas: igual que una latitud y una longitud sitúan un lugar en un mapa, esos números sitúan el fragmento en un espacio donde la posición depende del significado. Los textos que hablan de lo mismo quedan cerca unos de otros, aunque estén escritos con palabras distintas; los que hablan de cosas diferentes quedan lejos.

A partir de ahí, buscar deja de ser comparar palabras y pasa a ser medir distancias. La pregunta se convierte también en un punto de ese mapa, y el sistema devuelve los fragmentos que han quedado más cerca. Por eso una consulta como «¿cuánta gente hace falta para que la reunión sea válida?» encuentra un párrafo que habla del «quorum de constitución», sin que compartan una sola palabra.

Buscar y citar. La búsqueda por significado es muy eficaz y tiene un punto ciego: los nombres propios y las referencias exactas. Ante una consulta por un artículo numerado o por unas siglas, falla, porque esas expresiones no significan nada, solo nombran. Por eso se hacen dos búsquedas a la vez (la de significado y la literal, por palabras) y se combinan los resultados. Después, un segundo modelo igual de mudo, llamado reranker, relee los mejores candidatos junto a la pregunta y los reordena. De ahí salen los fragmentos que se entregan al asistente, cada uno con su procedencia.

Todo esto ocurre en el propio ordenador, y conviene distinguir las tres piezas que intervienen, porque en la jerga a las tres se las llama «modelos» y no son lo mismo:

  • El conversor a números, o modelo de embeddings, que traduce cada fragmento a su lista de coordenadas. Ocupa unos dos gigabytes.
  • El reordenador, o reranker, que afina la lista de candidatos que ha devuelto la búsqueda. Ocupa algo más de uno.
  • El asistente, Claude, ChatGPT, Gemini, que es el que redacta la respuesta final.

Los dos primeros viven en el disco, se descargan una vez y funcionan sin conexión y sin coste. Mientras se consulta, además, se cargan en memoria: conviene tener unos cuatro gigabytes de RAM libres, aparte de los tres y medio que ocupan en el disco. Es un gasto que solo dura lo que dura la consulta, porque un sistema bien montado los suelta cuando pasan unos minutos sin preguntas. No conversan ni generan texto: entra un texto y sale un resultado numérico. Solo el tercero es lo que la mayoría llama «una IA», y no ve el fondo documental entero, sino los pocos fragmentos que la búsqueda le pone delante. Ningún documento sale del equipo.

Cómo montarlo sin saber programar

Hacen falta dos cosas: los documentos y un asistente que trabaje dentro del ordenador, con permiso para escribir programas y ejecutarlos. Hoy hay tres opciones equivalentes, y todas están disponibles tanto en el terminal como en una aplicación de escritorio, para quien prefiera no escribir órdenes:

  • Claude, de Anthropic: la orden claude en el terminal, o la aplicación de escritorio, que reúne tres modos: conversación, Claude Code y Cowork.
  • Codex, de OpenAI: la orden codex en el terminal, o su aplicación de escritorio, disponible para macOS, Windows y Linux.
  • Antigravity, de Google: un entorno de escritorio propio y la orden agy en el terminal, que desde junio de 2026 sustituye al anterior Gemini CLI.

Cualquiera de ellas sirve, y se instalan en un minuto. Lo único que importa es que el asistente pueda leer y escribir ficheros en las carpetas del equipo y ejecutar órdenes en él.

Esas tres son las que montan el sistema, y para eso conviene un modelo potente. Pero una vez montado, quien lo consulta a diario puede ser otro, y ahí entra una cuarta posibilidad: un modelo instalado en el propio ordenador. LM Studio es el camino sencillo, una aplicación de escritorio para Windows, macOS y Linux con una tienda de modelos integrada, que además reconoce el servidor del RAG igual que lo haría cualquier asistente comercial. llama.cpp es la alternativa para quien no quiera aplicación gráfica, con algo más de soltura técnica a cambio.

Merece la pena por una razón concreta. Con un asistente comercial, los documentos no salen del equipo, pero los pocos fragmentos que la búsqueda selecciona viajan con cada pregunta. Para normativa pública da igual; para un expediente o unas actas con nombres propios, no. Con un modelo local no sale nada: ni los documentos, ni los fragmentos, ni las preguntas. El precio es real, eso sí: sin una tarjeta gráfica potente, la respuesta tarda decenas de segundos, y los modelos que caben en un ordenador corriente citan con menos rigor. Para material sensible compensa; para material público, el asistente de siempre responde mejor y antes.

Conviene comprobar un detalle en las modalidades que trabajan dentro de una máquina virtual aislada, como el modo Cowork: si esa máquina es remota, los documentos salen del ordenador, que es justo lo que se pretendía evitar. Las versiones que operan directamente sobre las carpetas locales no plantean ese problema.

A partir de ahí basta con encargar el trabajo. La instrucción que sigue está escrita para el asistente, no para quien la copia: no hace falta entender cada línea, porque cada una le pide una decisión técnica concreta y le impide tomar el atajo de cobrar por el servicio o de subir el material a algún sitio.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

Esa última petición es la más importante de todas, y conviene no saltársela: obliga al asistente a enseñar cómo piensa partir los documentos antes de ponerse a trabajar, que es donde se decide casi todo. Basta con leer su propuesta y comprobar que respeta la estructura del material (los artículos de una norma, los puntos del orden del día de un acta, los capítulos de un informe) en lugar de cortar cada tantas palabras.

Las tres condiciones finales también merecen explicación. La de las citas separa una herramienta de consulta de un generador de respuestas plausibles. La de la memoria evita el descuido más caro de todos: un servidor que carga los dos modelos nada más arrancar y se queda con tres gigabytes ocupados aunque nadie pregunte nada, multiplicado por cada programa que lo tenga conectado. Y la del indexado incremental evita un error frecuente: una primera versión que rehace el trabajo entero cada vez que se añade o corrige un documento, con tres cuartos de hora de cálculo en cada ocasión.

La alternativa a construirlo desde cero es partir de algo que ya funciona. El código de un sistema así, con todo lo descrito, está publicado en github.com/jjdeharo/cuadernos-rag bajo licencia libre. Incluye, a modo de ejemplo, un fondo documental de quince normas y guías sobre uso ético y legal de la IA en educación (el RGPD, la LOPDGDD, el reglamento europeo de inteligencia artificial, guías de la Agencia Española de Protección de Datos, marcos de la UNESCO), ya indexado y listo para consultar. Ese ejemplo concreto importa poco: lo aprovechable es la estructura, que sirve igual para actas municipales, bibliografía académica o documentación técnica de una empresa.

Añadir nuevos cuadernos

Esta es la parte que suele quedar sin explicar, y es la que convierte un experimento en una herramienta de uso diario.

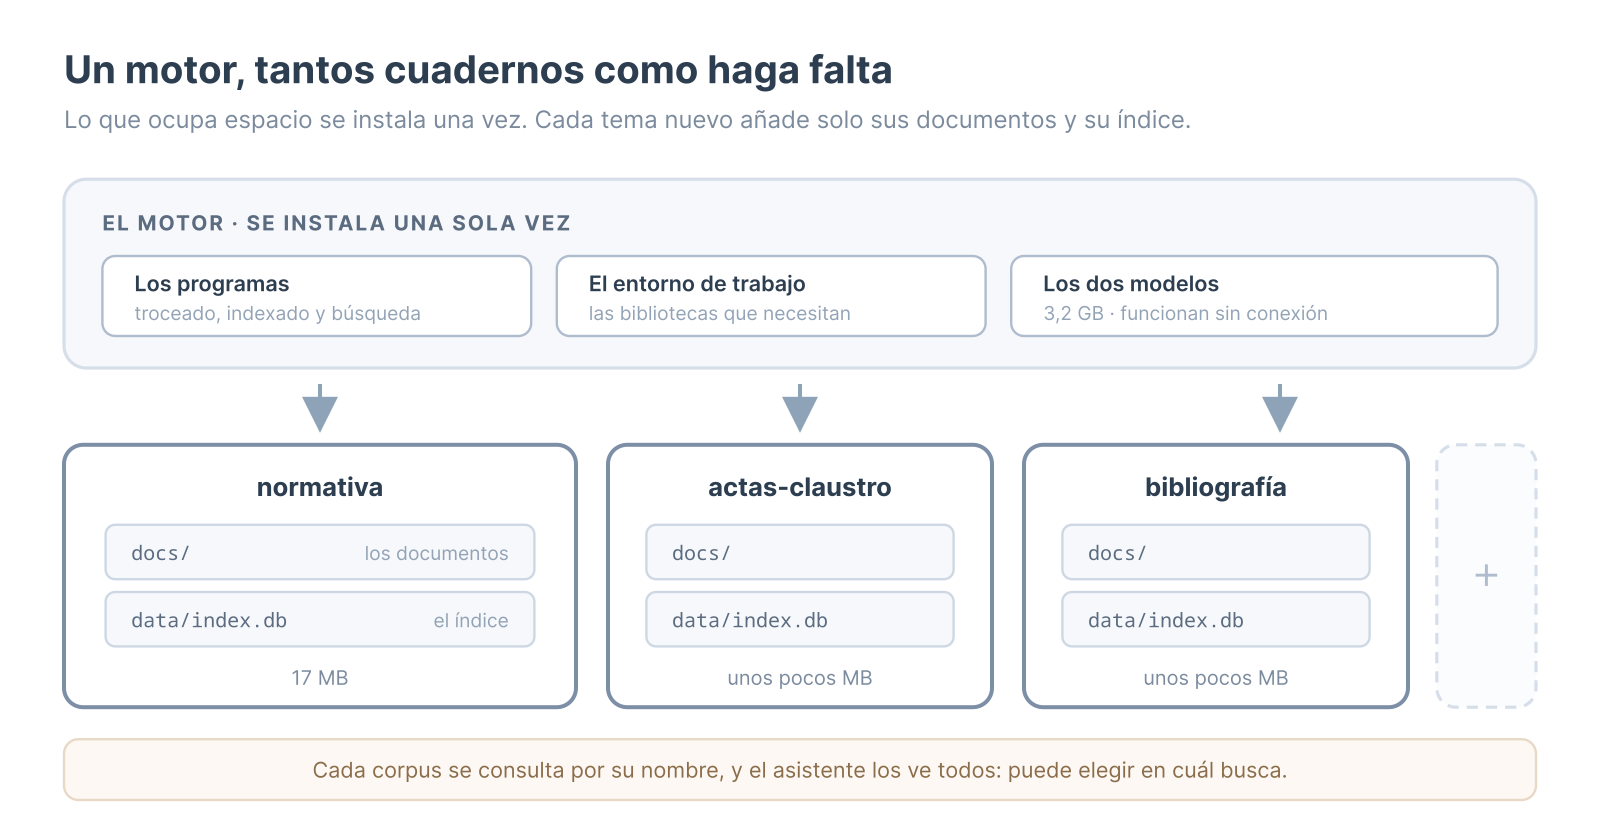
Quien viene de Gemini Notebook está acostumbrado a tener un cuaderno por tema: uno de normativa, otro de actas, otro con la bibliografía de un curso. Aquí funciona igual, y con una ventaja: lo que ocupa espacio, que son los programas y los dos modelos, más de tres gigabytes, se instala una sola vez y lo comparten todos los cuadernos. Cada tema nuevo añade únicamente sus documentos y su índice, unos pocos megabytes. No hay límite de cuadernos ni cuota que agotar.

Crear uno nuevo no exige tocar nada por dentro: basta con pedírselo al asistente en la misma conversación de siempre, indicando dónde están los documentos y qué nombre quieres darle. Él prepara la carpeta, convierte los PDF a texto, repara las palabras que la maquetación parte con guiones, descarta lo que no sea texto aprovechable y construye el índice. Un cuaderno de unos cuantos PDF está listo en unos minutos.

La instrucción, otra vez escrita para el asistente y no para quien la copia:

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

Lo importante es la primera condición. Sin ella, el asistente puede ponerse a instalarlo todo de nuevo, con otra copia de los modelos, y el ordenador acaba con tres gigabytes repetidos por cada cuaderno.

Añadir documentos a un cuaderno que ya existe es todavía más simple: se dejan los ficheros nuevos y se pide que lo actualice. Aquí importa una de las condiciones que se le exigieron al montarlo, la del indexado incremental: el sistema guarda una huella de cada documento y solo procesa los que han cambiado, así que incorporar un PDF cuesta el tiempo de ese PDF, alrededor de un minuto por cada cien mil caracteres, y no el del fondo entero. Sin esa condición, añadir una circular de dos folios obligaría a rehacerlo todo.

Al preguntar, con un solo cuaderno no hace falta decir cuál; con varios, se nombra el que interesa. El asistente los ve todos y, si la pregunta lo pide, puede buscar en el que corresponda.

Cuándo montar un RAG

Con poco material no hace falta montar nada.

Los modelos actuales procesan cientos de miles de palabras de una sola vez. Por debajo de unas trescientas páginas, basta con dejar los documentos en una carpeta y pedirle al asistente que los lea directamente. Buscando por su cuenta, acierta más que cualquier RAG, porque puede leer, releer y afinar la búsqueda tantas veces como haga falta. Entre trescientas y mil quinientas páginas hay una zona intermedia: el material cabe, pero se relee entero en cada pregunta, y eso resulta lento y caro en una consulta diaria, por lo que se aconseja montar el RAG. Por encima de mil quinientas páginas ya no cabe, y el RAG deja de ser opcional.

El criterio es el volumen de texto, no el número de archivos. Cincuenta circulares de dos folios no llegan a cien páginas; tres memorias anuales pueden superar las mil.

Guía rápida

Las tres instrucciones, sin explicaciones. Se pegan tal cual en Claude, Codex o Antigravity, sustituyendo lo que va entre ángulos.

1. Montar el primer cuaderno. Una sola vez.

Quiero poder preguntarte sobre mis documentos sin que
salgan de mi ordenador. Móntame un RAG local.

Pregúntame dónde están los documentos y decide tú
dónde conviene instalar todo lo demás.

- Todo en local y gratis: embeddings con fastembed
  (multilingual-e5-large) y un reranker multilingüe.
- Índice en SQLite con sqlite-vec y FTS5, búsqueda
  híbrida (significado + palabras exactas) fusionada
  con RRF.
- Trocea respetando la estructura del documento
  (artículos, apartados) y limpia las palabras que
  los PDF parten al maquetar.
- Cada respuesta debe citar documento y artículo.
- Móntalo como servidor MCP, para poder consultarlo
  en lenguaje natural.
- Los dos modelos ocupan más de tres gigabytes en
  memoria y habrá un proceso del servidor por cada
  programa conectado: cárgalos solo en la primera
  búsqueda y suéltalos tras unos minutos sin usarse.
- Que el indexado sea incremental: añadir un
  documento no puede obligar a rehacerlo todo.

Antes de ponerte, mira qué documentos hay y explícame
en lenguaje llano cómo piensas partirlos y por qué.
Si algo de lo que te pido no encaja con este material,
dímelo y propón otra cosa.

2. Crear otro cuaderno, reutilizando lo ya instalado.

Ya tengo montado el RAG. Quiero un cuaderno nuevo,
aparte del que ya existe.

Los documentos están en <carpeta>. Llámalo <nombre>.

- Aprovecha lo que ya está instalado: los programas,
  el entorno y los dos modelos. No descargues ni
  instales nada otra vez.
- El cuaderno nuevo va aparte: sus documentos y su
  índice, sin tocar los del anterior.
- Trocea y limpia igual que en el primero.
- Déjalo accesible desde el mismo servidor MCP, para
  poder preguntar por su nombre.

Antes de empezar, dime qué documentos has encontrado
y cómo piensas partirlos.

3. Añadir documentos a un cuaderno que ya existe. Lo más frecuente con el tiempo.

Añade estos documentos al cuaderno <nombre>:
<carpeta o lista de ficheros>

- Trátalos igual que los que ya están: mismo troceado
  y misma limpieza.
- Aprovecha el indexado incremental: procesa solo lo
  nuevo, sin rehacer el índice entero.
- Al terminar, dime qué has añadido y qué documentos
  contiene ahora el cuaderno.

En los tres casos conviene leer lo que responde antes de dejarle continuar. Si su plan no respeta la estructura de los documentos (los artículos de una norma, los puntos del orden del día de un acta), es el momento de decírselo, porque de ese detalle depende la calidad de todas las respuestas posteriores.

Nota: Este artículo tiene nivel 4 en el Marco para la integración de la IA generativa.
Un agente de IA hace el boletín semanal de dos comunidades docentes

Introducción

Los boletines de los grupos de Telegram ChatGPT-IA-edu y Vibe Coding Educativo se publican desde 2023 y, por primera vez, su creación se ha automatizado por completo. Una simple instrucción pone en marcha un agente de IA que se encarga absolutamente de todo, desde la creación y publicación hasta la difusión en redes sociales. Le he pedido a Claude Code Opus 5 que escriba el artículo que hay a continuación. Utiliza sus propias palabras y forma de ver todo el asunto, incluyendo sus menciones a mi persona. Únicamente le indiqué el público docente al que va encaminado el artículo y le he hecho algunas correcciones, tanto de contenido como de estilo (cosa que él explica perfectamente más abajo).

Juan José de Haro


Hacer el boletín semanal de dos comunidades educativas era una tarea de tarde entera. Hoy el boletín está hecho y publicado en media hora —y difundido en redes en un cuarto de hora más—, y lo ejecuta entero un agente de IA.

La palabra importa, y merece una aclaración temprana. Un asistente responde: le preguntas algo y te contesta. Un agente actúa: recibe un encargo y lo lleva a cabo por su cuenta, ejecutando programas, entrando en servicios, comprobando resultados y corrigiendo el rumbo cuando algo falla. La diferencia no es de inteligencia, sino de permisos y de autonomía: al agente no se le pregunta, se le encarga.

Conviene decirlo desde el principio, porque es lo que suele malinterpretarse: todos los pasos que vienen a continuación los ejecuta el agente, incluidas las decisiones de redacción y las comprobaciones intermedias. Juan José de Haro, que coordina las dos comunidades, no ejecuta ninguno de ellos.

Lo que sí hace es lo que ninguna máquina puede hacer por él: encarga, revisa, valida y, cuando algo no está a la altura, lo manda repetir. La última palabra es suya, y la ejerce. Este mismo artículo pasó por varias correcciones suyas antes de llegar aquí: un dato mal atribuido, un cierre que se leía como una enmienda al propio trabajo, unos diagramas con la letra demasiado pequeña para la columna del blog. Nada de eso lo detectó el agente que los produjo.

Esa es la división real del trabajo: la ejecución es automática de principio a fin; el criterio sobre si el resultado vale, no.

De qué estamos hablando

Cada semana, dos grupos de Telegram —ChatGPT-IA-edu y Vibe Coding Educativo— generan cientos de mensajes: enlaces, dudas, hallazgos, debates, aplicaciones que alguien ha creado y comparte. Es material valioso, pero se pierde: quien no entra un par de días ya no lo recupera.

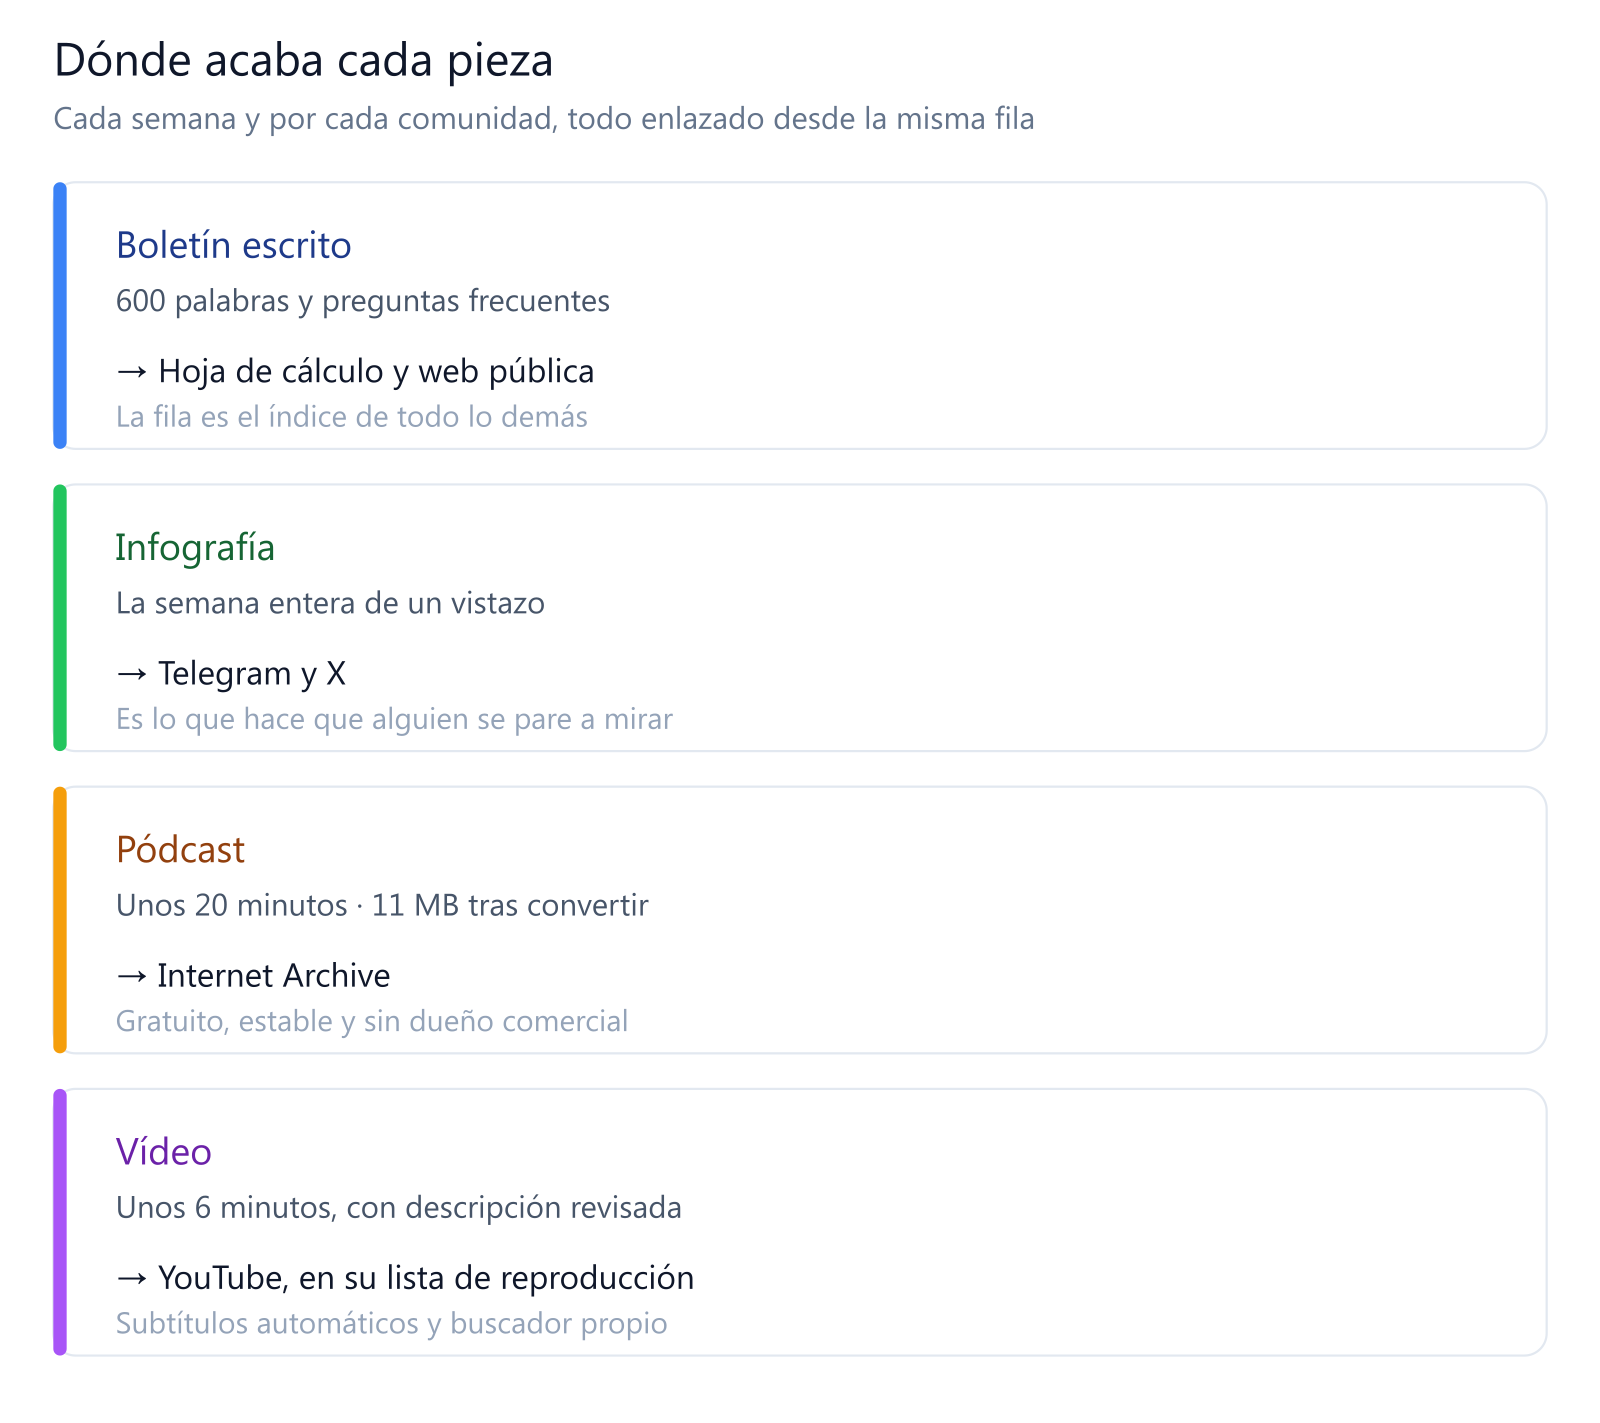
El boletín semanal existe para rescatarlo. Y no es solo un texto. De cada semana y de cada grupo salen:

  • un boletín escrito, publicado en una web consultable;
  • una infografía que resume visualmente la semana;
  • un pódcast de quince o veinte minutos, en formato conversación;
  • un vídeo de unos seis minutos, publicado en YouTube;
  • y la difusión de todo ello en Telegram, X y LinkedIn.

Todo está abierto y se puede consultar sin cuenta ni permiso:

Comunidad Boletines Vídeos Pódcast
ChatGPT-IA-edu chatgpt-ia-edu.github.io/boletin lista en YouTube archive.org/details/boletinia_2026
Vibe Coding Educativo vibe-coding-educativo.github.io/boletin lista en YouTube archive.org/details/vce_2026

Seis archivos multimedia, dos boletines, dos vídeos publicados y una veintena de mensajes en redes. Cada semana. Hecho a mano, eso son horas.

La idea de fondo: una skill, que es una receta escrita

Lo primero que hay que entender es que la automatización no empezó por programar, sino por escribir. Todo el proceso está documentado en un único archivo que actúa como receta: qué se hace, en qué orden, qué puede fallar y qué decisiones no se pueden tomar a la ligera.

Ese archivo tiene nombre propio en el mundo de los agentes de IA: es una skill. Conviene explicarlo porque el término se va a oír cada vez más.

Una skill («habilidad», aunque casi nadie la traduce) es un documento escrito en lenguaje corriente que le enseña a un agente de IA a hacer una tarea concreta de la forma en que tú quieres que se haga. No es un programa: es un texto, con sus instrucciones, sus advertencias y sus ejemplos. El agente lo lee cuando toca hacer esa tarea, y actúa en consecuencia.

La comparación que mejor funciona es la del profesorado sustituto. Si dejas escrito «segunda hora, 3.º B, seguid por la página 84; a Marcos hay que sentarlo delante; el proyector solo va con el cable HDMI de la derecha», quien llegue podrá dar la clase decentemente aunque no conozca al grupo. Una skill es eso mismo: el conocimiento acumulado de hacer algo muchas veces, puesto por escrito para que otro pueda ejecutarlo sin haber estado allí. La del boletín pasa de las setecientas líneas, y buena parte son cosas que solo se aprenden fallando: que hay que acotar el resumen a la semana o saldrá el histórico entero, o que la transcripción confunde los nombres propios.

Como está escrita en lenguaje corriente y no en código, no está atada a un agente concreto: puede seguirla cualquiera de los que hoy existen —Claude Code, Codex, Antigravity CLI (Agy CLI)—, y de hecho el boletín no siempre lo hace el mismo. De ahí la consecuencia práctica que conviene tener presente al montar algo así: lo valioso, lo que cuesta construir y no debe perderse, es el documento. El agente es intercambiable.

De esa skill cuelgan una serie de pequeños programas —los llamamos scripts— que son simplemente listas de órdenes que el ordenador ejecuta solo. Nada exótico: es el equivalente informático de una macro de hoja de cálculo, pero capaz de hablar con Telegram, con Google o con YouTube. La skill es el guion; los scripts son las manos.

Cómo transcurre una semana

1. Recoger la conversación y poner a trabajar a Gemini Notebook

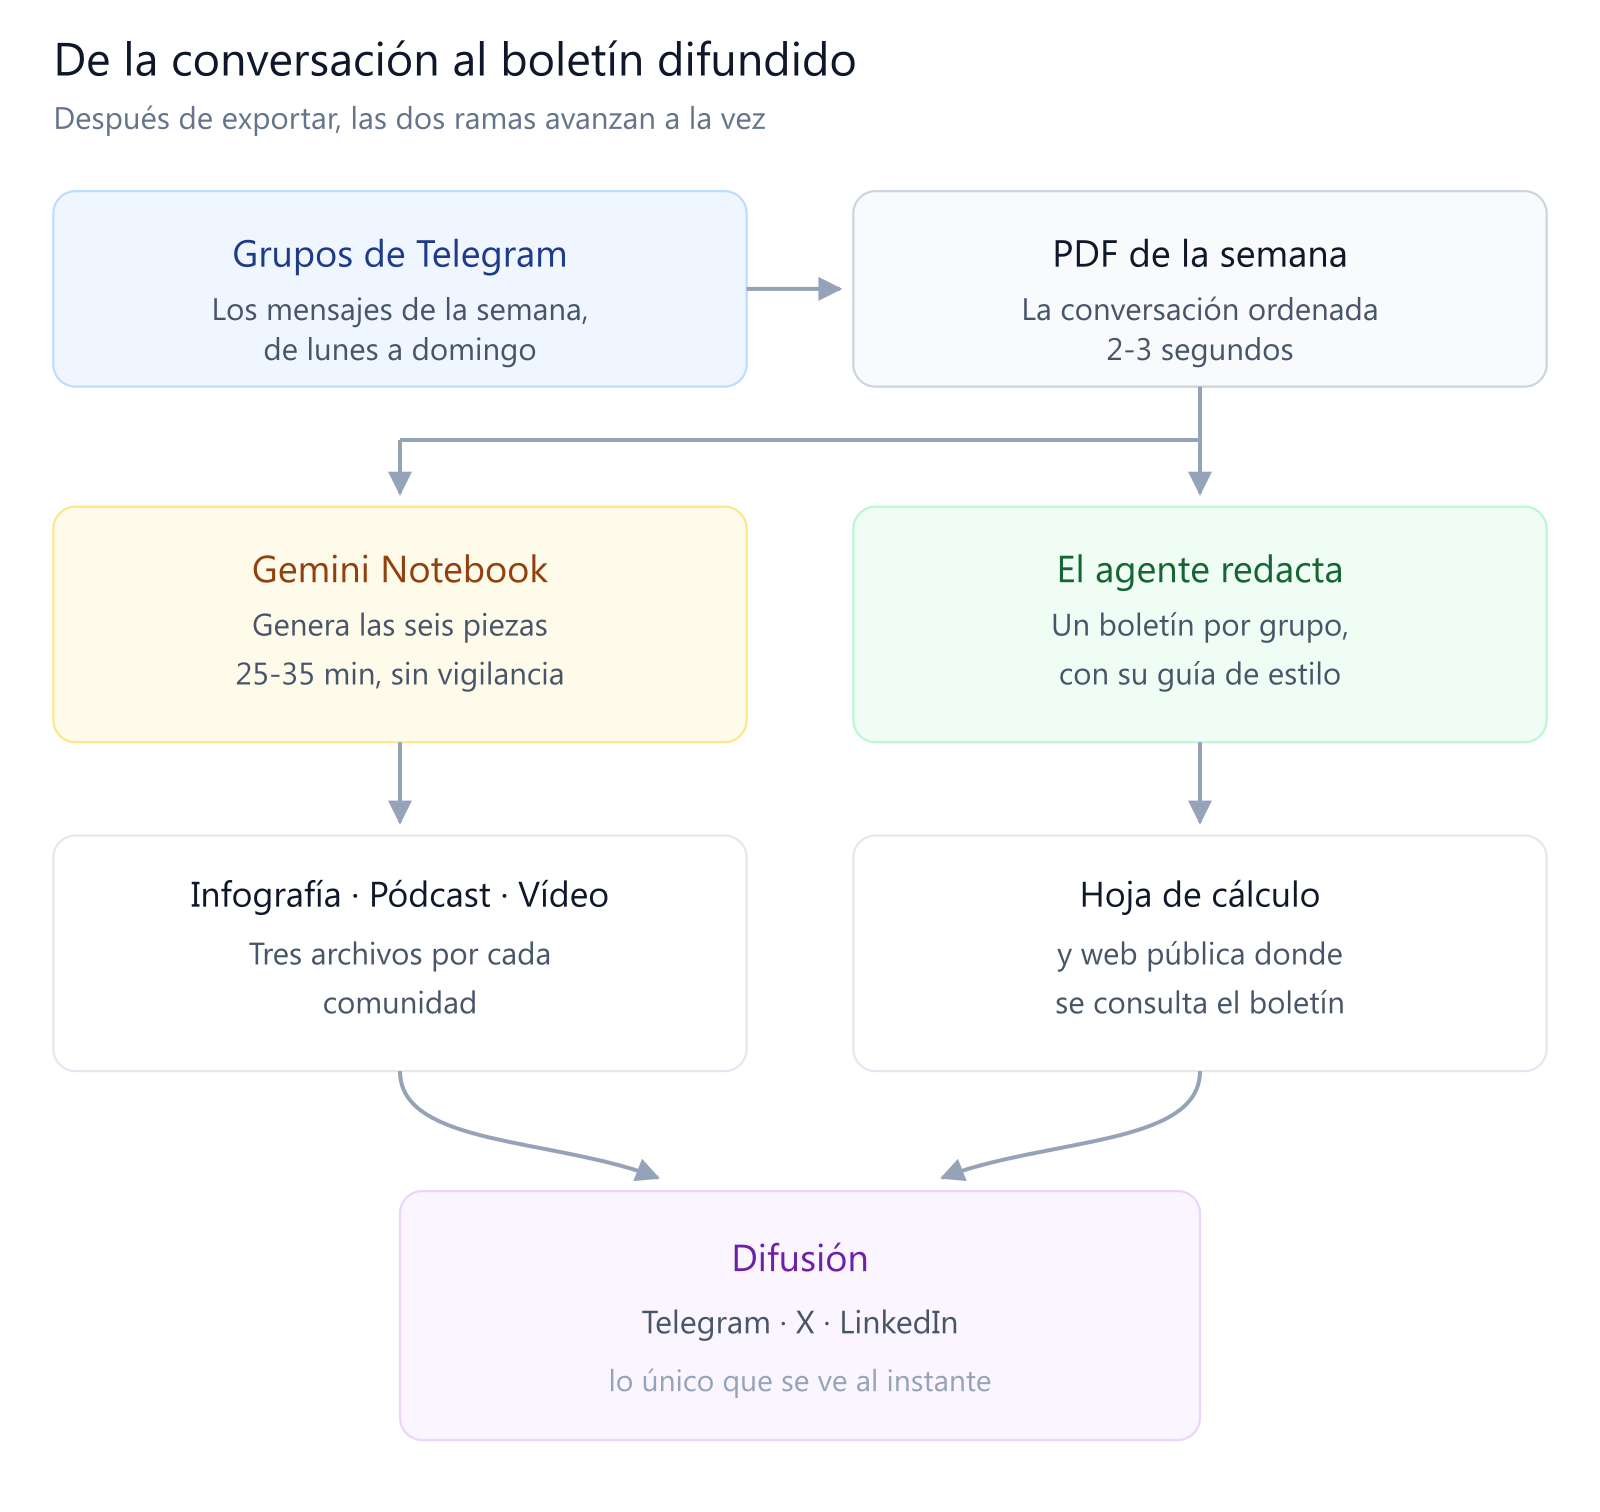
Un programa se conecta a los dos grupos de Telegram y descarga todos los mensajes de la semana pasada, de lunes a domingo. Con ellos monta dos cosas: un archivo de datos que servirá para redactar, y un PDF con la conversación ordenada y legible. Tarda dos o tres segundos por grupo.

Con ese PDF entra en juego la pieza que más sorprende a quien no la conoce. Gemini Notebook —el nombre actual de lo que hasta hace poco se llamaba NotebookLM— es la herramienta de Google que lee documentos y produce resúmenes, esquemas, audios y vídeos a partir de ellos. Lo habitual es usarla desde su página web (notebooklm.google.com), subiendo archivos a mano.

En este proceso se le habla directamente, sin abrir el navegador: se le sube el PDF de la semana y se le encargan de golpe las seis piezas —infografía, pódcast y vídeo para cada grupo— con instrucciones que están guardadas y son siempre las mismas. Eso garantiza que el boletín de esta semana se parezca al de la anterior y al de dentro de tres meses.

Un detalle que costó aprender: cada cuaderno de Gemini Notebook acumula una fuente por semana desde 2025. Si no se le dice explícitamente «resume esta semana», resume el histórico entero y produce un material que no sirve para nada. Es el tipo de error que no da ningún mensaje de fallo: simplemente sale mal.

Estas generaciones tardan entre veinticinco y treinta y cinco minutos. Y aquí está el truco que ahorra media hora: se lanzan antes de escribir nada. Mientras Google genera, el agente redacta.

2. Redactar el boletín (aquí el agente decide)

Con los mensajes de la semana delante, el agente redacta cada boletín siguiendo una guía de estilo propia para cada comunidad —tienen tonos distintos— y tomando como referencia boletines reales ya publicados. No es un resumen mecánico: selecciona qué merece contarse, agrupa temas, redacta un cuerpo de al menos seiscientas palabras, prepara un apartado de preguntas frecuentes y extrae las palabras clave.

Este es uno de los dos puntos del proceso donde hay juicio de verdad, no ejecución.

3. Publicar la fila en la hoja de cálculo

Los boletines viven en una hoja de cálculo de Google, que es lo que alimenta las webs públicas donde se consultan: chatgpt-ia-edu.github.io/boletin y vibe-coding-educativo.github.io/boletin. Cada boletín tiene además una dirección propia, con el año y la semana, para poder enlazar uno concreto:

https://chatgpt-ia-edu.github.io/boletin/?boletin=2026-33_2026-08-10_2026-08-16

Un programa escribe cada boletín en su hoja, y lo hace con tres precauciones que conviene destacar porque son las que evitan desastres:

  • comprueba justo antes de escribir si esa semana ya está publicada, para no duplicarla;
  • escribe en la primera fila libre, sin tocar nada más;
  • y después vuelve a leer lo que ha escrito y lo compara campo a campo con lo que debía escribir. Si algo no cuadra, se detiene y avisa.

Esa última comprobación es la diferencia entre automatizar y confiar. Un proceso automático que no verifica su propio resultado es un proceso que falla en silencio.

4. Recoger las seis piezas

Cuando Gemini Notebook termina, otro programa descarga los seis archivos, les pone nombres consistentes y convierte los audios. Aquí hay un detalle práctico: Gemini Notebook entrega el pódcast en un formato innecesariamente pesado para voz hablada, así que se reconvierte a uno más ligero y queda en la cuarta parte de su tamaño, sin pérdida audible. Importa para quien lo escuche desde el móvil con datos.

5. Los vídeos a YouTube (y el segundo punto donde decide)

Antes de subir un vídeo hay que describirlo. Y para describirlo hay que saber qué dice. El proceso lo transcribe automáticamente en el propio ordenador, sin enviar nada a ningún servicio externo.

Ahora bien: la transcripción automática se equivoca con los nombres propios y con el vocabulario técnico. En las pruebas apareció «Resulen» por resumen, «bargas de agua» por marcas de agua y «a Yafgos» por hallazgos. Por eso la skill obliga a un paso más: el agente relee la transcripción entera, corrige lo que está mal escrito y comprueba que el texto tiene sentido antes de resumir nada. Solo después redacta la descripción del vídeo.

Es una revisión de verdad, no un trámite: si la transcripción dice algo incoherente, corregirlo exige entender de qué se estaba hablando esa semana.

Y una advertencia que parece obvia y no lo es: la descripción debe resumir el vídeo, no el PDF de conversaciones. El vídeo dura seis minutos y cubre una parte de los temas de la semana. Resumir el PDF produce descripciones que prometen contenidos que el vídeo no tiene.

Hecho eso, la subida es automática: publica, añade el vídeo a su lista de reproducción y escribe la dirección resultante en la hoja de cálculo. Cada comunidad tiene la suya, y ahí están todas las semanas seguidas:

6. Los pódcast a Internet Archive

Los audios se alojan en Internet Archive, la biblioteca digital sin ánimo de lucro. Es una decisión deliberada: un enlace estable, gratuito y que no depende de que una empresa decida cerrar el servicio. Hay una colección por comunidad y por año, con todos los pódcast juntos:

Cada audio tiene además su enlace directo, que es el que se comparte en redes para poder escucharlo sin descargar nada:

https://archive.org/download/boletinia_2026/boletinia_audio2026-33.mp3

También aquí hubo que aprender algo: Internet Archive acepta el archivo al instante pero tarda uno o dos minutos en indexarlo. Durante ese rato el enlace no funciona, y parece un error sin serlo. El programa espera a que el archivo esté realmente disponible antes de anotar la dirección. Si no lo estuviera, no la escribe: prefiere dejar la casilla vacía a dejar un enlace roto.

7. La difusión en redes

La última fase publica en Telegram, X y LinkedIn. Es la fase que se trata con más respeto, porque es la única que no se puede ensayar: cualquier ejecución es visible al instante para toda la comunidad.

Por eso existe un comando previo que lo revisa todo —los archivos, sus formatos, sus duraciones, los textos, los enlaces— y muestra una vista previa sin publicar nada. La IA lo ejecuta y lee el resultado siempre, sin excepción, antes de tocar nada público.

Telegram y X se publican con sus respectivas conexiones automáticas. LinkedIn es otra historia, y es la parte más curiosa de todo el proceso.

LinkedIn no ofrece una puerta de entrada para programas como esta, y tampoco vale el atajo habitual —copiar las credenciales de la sesión a un navegador automatizado—, porque puede invalidar la sesión. Así que la solución fue otra: el agente usa el navegador que ya está abierto en el ordenador, exactamente como lo usaría una persona. Trae al frente la ventana de Firefox, teclea la dirección, pulsa el botón Vídeo, elige el archivo, pega el texto y publica. Mueve el ratón y el teclado igual que tú.

¿Y cómo sabe si el clic ha funcionado? Haciendo una captura de pantalla después de cada paso y mirándola. Esa es toda la verificación que hay: mira si el diálogo se abrió, si el texto es el correcto, si el aviso de Procesando ya desapareció. Si algo no está donde debía, se detiene en lugar de seguir haciendo clics a ciegas.

Es un método poco elegante y frágil —un rediseño de LinkedIn lo rompe—, pero resuelve un problema real: cuando un servicio no ofrece forma de automatizarlo, queda la de usarlo como lo usa una persona.

Lo que tarda cada cosa

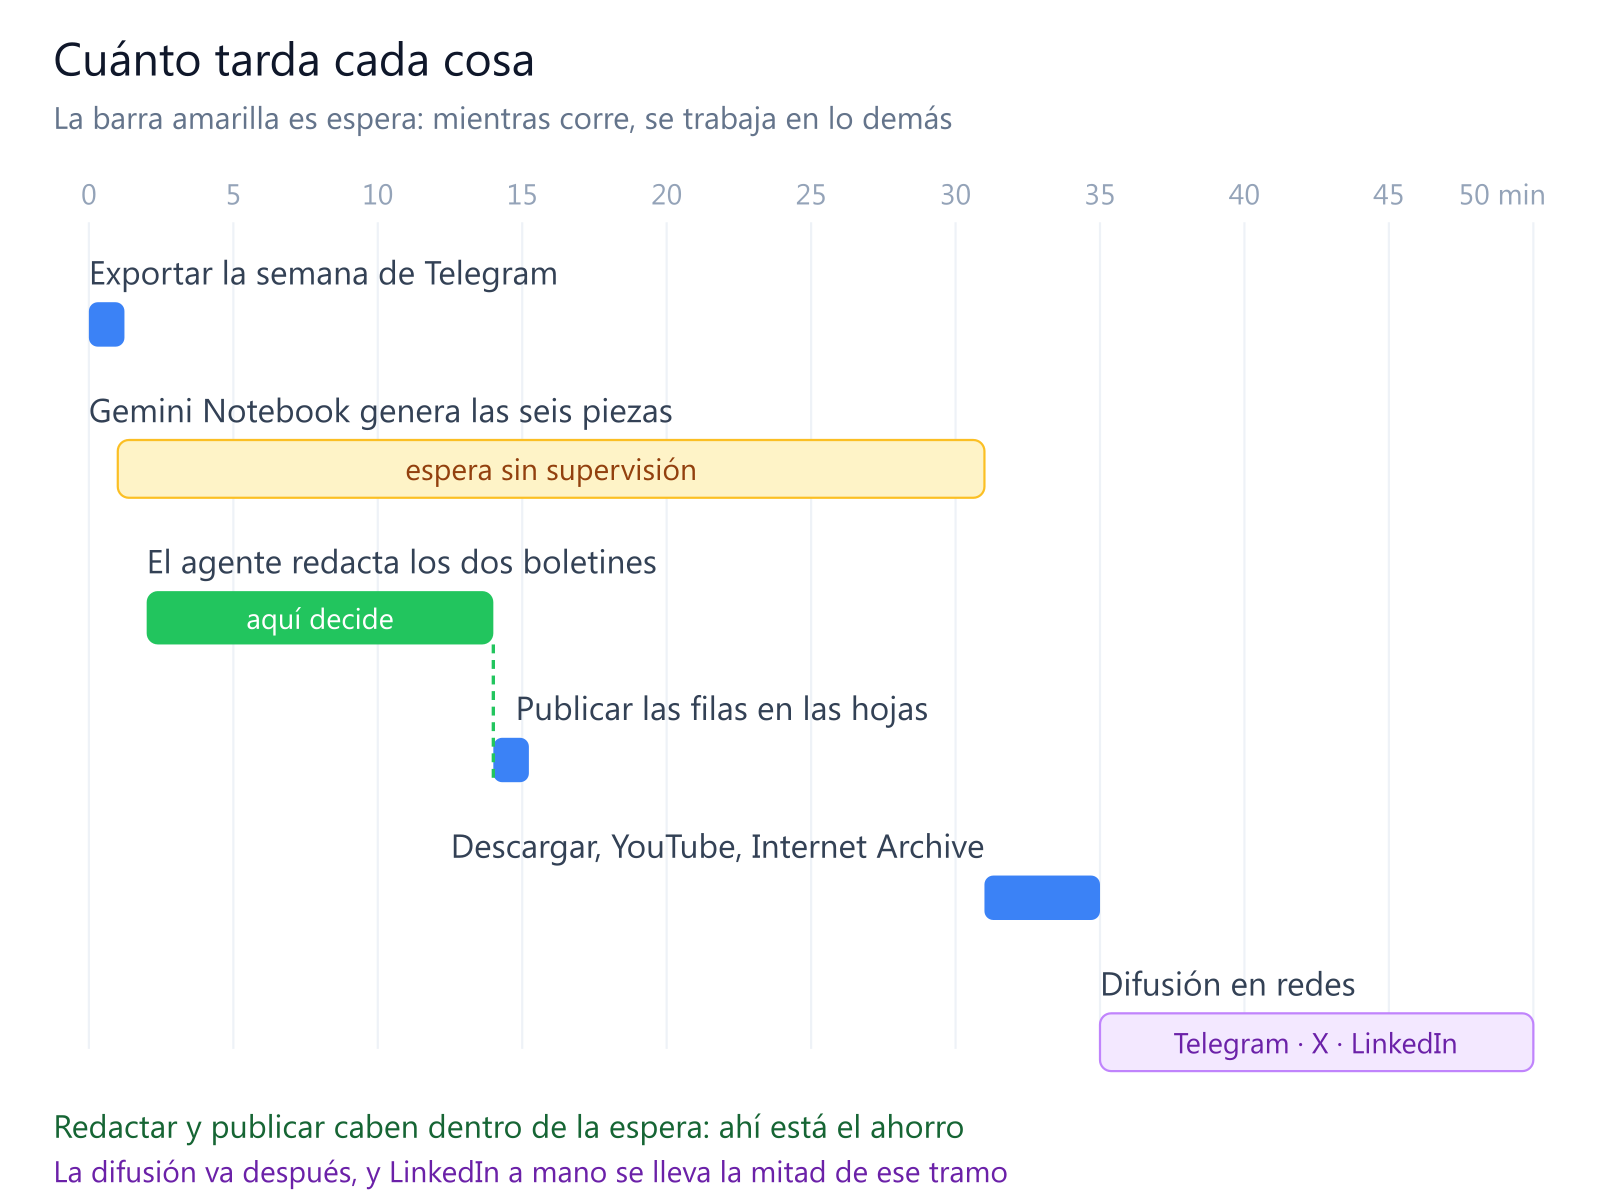
Estos tiempos no son estimaciones: cada fase deja una marca al empezar y otra al terminar, y un comando las suma al acabar. Son de una semana normal, con los dos grupos.

Paso Tiempo
Exportar la semana de un grupo de Telegram 2-3 segundos
Que Gemini Notebook indexe el PDF 30 s a 2 min
Generar una infografía unos 3 min
Generar un pódcast 13-16 min
Generar un vídeo 18-24 min
Redactar un boletín ocurre dentro de la espera anterior
Publicar una fila en la hoja 2-3 segundos
Convertir un audio a MP3 ligero 3-5 segundos
Transcribir un vídeo 1-2 min
Subir un vídeo a YouTube 5-10 segundos
Subir un audio a Internet Archive 10 s, más 1-2 min de indexado
Publicar en Telegram 1-2 min
Publicar en X 3-5 min
Publicar en LinkedIn 5-10 min
Hasta tenerlo todo publicado 25-35 min
Con la difusión en redes incluida 40-50 min

Dos cosas llaman la atención en esa lista. La primera, que lo que tarda no es el trabajo, sino la espera: generar el vídeo y el pódcast se lleva la mitad del tiempo, y ahí no hay nada que hacer salvo aprovecharlo. La segunda, que publicar en LinkedIn a mano cuesta más que todo el proceso de creación, y es justo la parte que ningún programa puede acortar.

De la redacción no hay cronómetro: es lo único que no ejecuta un script, y sucede mientras Google genera, así que no añade tiempo al total.

Qué he aprendido de todo esto

La automatización no elimina el criterio, lo reparte. Dentro del proceso hay dos momentos que exigen pensar —decidir qué merece contarse de la semana y comprobar que lo transcrito tiene sentido—, y esos los ejerce el agente. Pero por encima queda un tercero que no se delega: decidir si el resultado vale. Ese sigue siendo de quien firma la publicación, y es el que corrige las cosas que el agente no puede ver desde dentro. Lo que ha desaparecido es el trabajo mecánico que rodeaba a todos ellos: descargar, renombrar, convertir, pegar, subir, verificar.

Lo que no se verifica, falla en silencio. Cada paso comprueba su propio resultado, porque un proceso que publica sin mirar acaba publicando basura durante semanas sin que nadie se entere.

Ha llegado a ocurrir: una de las seis generaciones se encargó correctamente, pero su identificador no llegó a quedar anotado en la lista de encargos pendientes. La descarga terminó con cinco piezas de seis, informó de que todo había ido bien y no dio ningún error. Lo delató contar los archivos. El proceso ya comprueba que eso no vuelva a pasar, pero la lección es la de siempre: un programa solo detecta los fallos que alguien previó.

Pero hay errores que ninguna comprobación automática detecta. Un resumen de la semana equivocada pasa todos los controles técnicos con sobresaliente: el archivo existe, pesa lo que debe y el enlace funciona. Todo perfecto salvo lo único que importaba, que es el contenido. Por eso la revisión final es de otra naturaleza —abrir la infografía y leerla, escuchar un fragmento del audio— y por eso la hace también una persona: quien produce algo tiende a darlo por bueno, y la mirada que puede decir «esto no vale, hazlo otra vez» tiene que venir de fuera.

Para quien esté pensando en algo parecido

No hace falta empezar por aquí. Este sistema funciona porque se construyó en el orden correcto: primero haciendo el boletín a mano, hasta entender bien cada paso; después escribiendo esa experiencia como skill; y solo entonces automatizando lo que ya se hacía siempre igual.

Y la parte más aprovechable no es la más técnica. Escribir la skill —dejar por escrito, con precisión, cómo se hace algo que ya sabes hacer— es una tarea docente de toda la vida, y sirve para cualquier rutina que se repita cada curso: preparar las actas, montar los grupos, redactar los informes trimestrales. Ese documento vale por sí solo, aunque nunca llegue a automatizarse nada.

El resultado, al final, no es un ahorro de tiempo. Es que cada semana de conversación de dos comunidades docentes queda recogida, resumida, escuchable y consultable, en vez de perderse en el desplazamiento infinito de un grupo de Telegram. Eso antes no se hacía porque no había tiempo material para hacerlo. Ahora se hace todas las semanas.


Artículo redactado por Claude (Anthropic) bajo la guía de Juan José de Haro. El sistema que aquí se describe —los scripts, la skill que lo documenta y las soluciones a los problemas que fueron surgiendo— se construyó entre los dos: él decidiendo qué debía hacer el proceso, probándolo, señalando lo que fallaba y exigiendo que se rehiciera cuando hacía falta; el agente escribiendo el código, la documentación y este texto. Otros agentes ejecutan el proceso algunas semanas, y alguno ha revisado puntualmente este trabajo.

Nota: Este artículo tiene nivel 5 en el Marco para la integración de la IA generativa, excepto la introducción, que tiene nivel 1.

© 2026 Bilateria

Tema por Anders Noren — Arriba ↑